
AI coding assistants คืออะไร และทำไมความเร็วถึงกลายเป็นหนี้เทคนิค
AI coding assistants คือเครื่องมือช่วยเขียนโค้ดที่ใช้โมเดลภาษาขนาดใหญ่เพื่อวิเคราะห์ สร้าง และแก้ไขซอฟต์แวร์โดยอัตโนมัติ ทำให้นักพัฒนาสามารถส่งมอบฟีเจอร์ แก้บั๊ก และรีแฟกเตอร์โค้ดได้เร็วขึ้นหลายเท่า แต่ความเร็วนี้มาพร้อมต้นทุนแฝงทั้งในมิติคุณภาพ การทดสอบ การดูแลโค้ด และค่าใช้จ่ายด้านโครงสร้างพื้นฐานที่ไม่เห็นทันทีในวันแรกของการใช้งาน
ในโลกความเป็นจริง นักพัฒนาจำนวนมากกำลังใช้เครื่องมืออย่าง Claude Code เพื่อให้ฟีเจอร์ไปถึงโปรดักชันให้เร็วที่สุด ทว่าคำถามที่ไม่ค่อยมีใครกล้าพูดคือ ความเร็วที่ได้มานั้นแลกด้วยอะไร การเขียนโปรดักชันโค้ดด้วย AI ถูกย้ำว่า ต้องมีมาตรฐานสูงกว่าที่มนุษย์เขียนเองด้วยซ้ำ เพราะต้องผ่านกฎ lint มากมาย การทดสอบจำนวนมาก การทดสอบปลายทางด้วย AI การทำ fuzzing รายวัน รีวิวโค้ดอัตโนมัติ และรีวิวความปลอดภัยก่อนปล่อยใช้งาน เมื่อไม่มีราวกั้นเหล่านี้ ความเร็วจะกลายเป็นหนี้เทคนิคที่สะสมจนระบบบำรุงรักษายากในอนาคต
ประสิทธิภาพ Claude Code กับกับดัก token ใช้เร็วไม่รู้ตัว
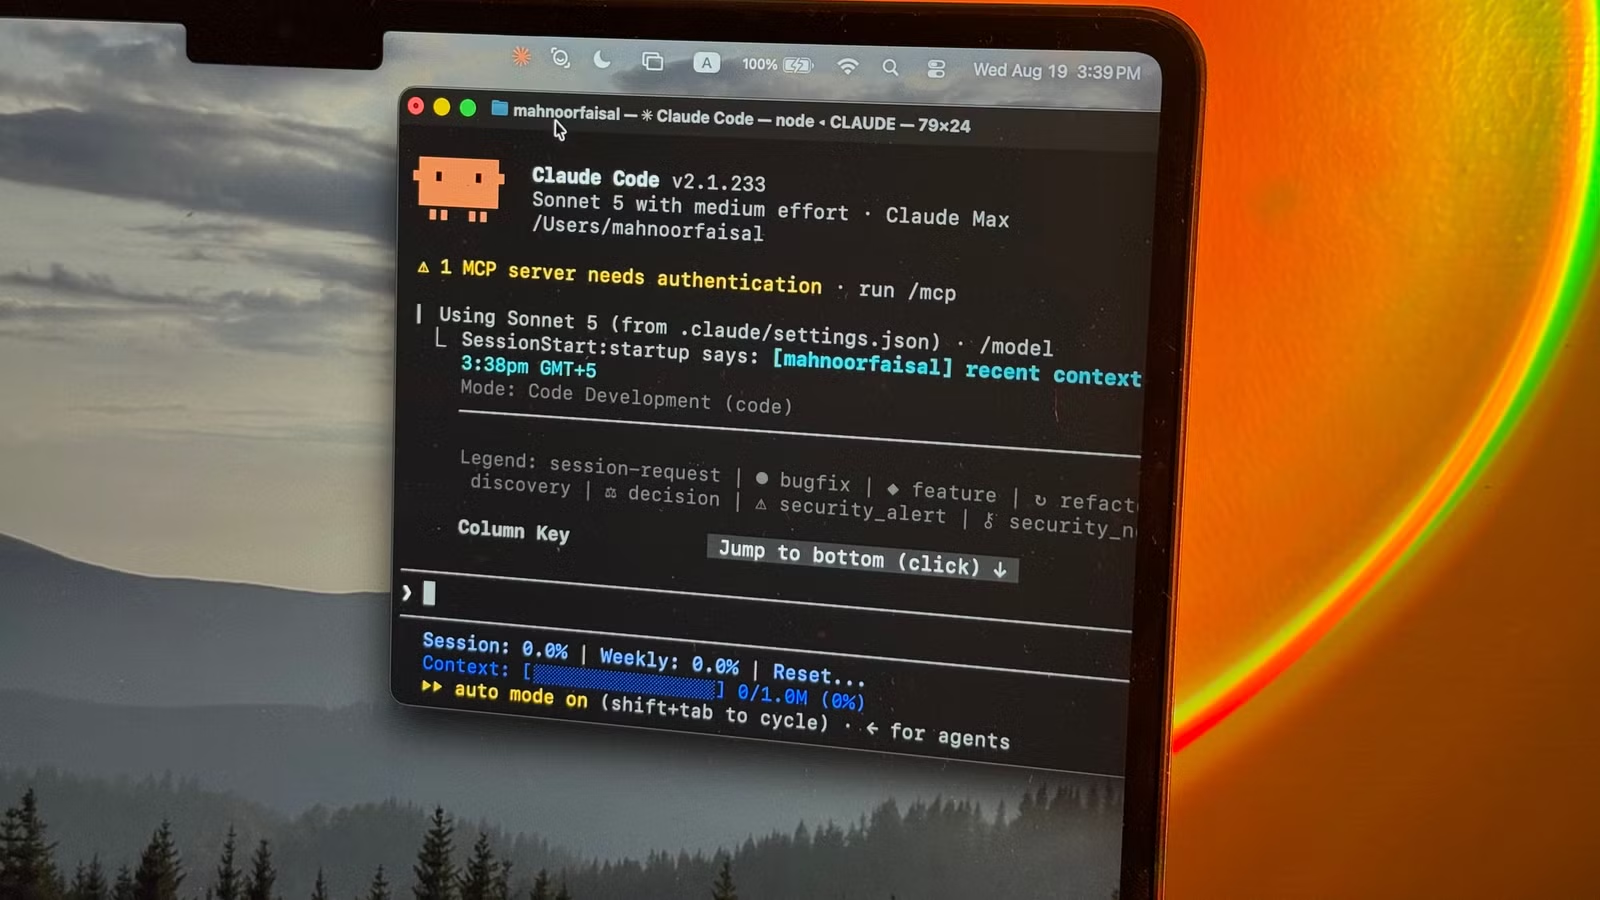
หัวใจของความเร็วจาก AI coding assistants คือการให้โมเดลเห็นบริบทโค้ดได้มากที่สุด แต่บริบทที่มากเกินจำเป็นกลายเป็นหลุมพรางเรื่อง token usage optimization โดยเฉพาะบน Claude Code นักเขียนโค้ดหลายคนค้นพบด้วยตัวเองว่า การปล่อยให้ AI ไต่ดูทั้งโปรเจกต์ทุกครั้งคือการเผาโควตาแบบไร้เหตุผล เมื่อใส่คำสั่งกว้างอย่างให้หาวิธีทำงานของ authentication และแก้บั๊กล็อกอิน Claude ต้องค้นหา เปิดอ่านไฟล์จำนวนมาก ก่อนจะเจอไฟล์ที่เกี่ยวข้อง ทำให้ค่า token สะสมโดยไม่ได้สร้างคุณค่าเท่าไรนัก
เสียงสะท้อนหนึ่งคือ ผู้ใช้คนหนึ่งหยุดให้ Claude Code ขุดทั้งโปรเจกต์ทุกครั้งที่สั่งงาน แล้วหันมาให้บริบทแบบเจาะจง เช่น สั่งให้เริ่มดูในโฟลเดอร์ src auth ก่อน และค่อยขยายออกเมื่อจำเป็น ผลคือการใช้งาน Claude ลดลงอย่างชัดเจน แม้ไม่มีตัวเลขแนบตรง แต่เจ้าตัวบอกว่าการใส่ข้อมูลอย่างมีสติทำให้เผาโควตาช้าลงมาก ขณะที่อีกคนยอมรับว่า บน Claude Code เขารู้สึกถึงเพดานการใช้งานตลอดเวลา เพราะแผนแบบเสียเงินนับโควตาทั้งในหน้าต่าง 5 ชั่วโมงแบบ rolling และโควตรายสัปดาห์ร่วมกับการใช้งานอย่างอื่น เมื่อใช้หนักในตอนเช้า หน้าต่างช่วงบ่ายอาจหายไปโดยไม่รู้ตัว
คุณภาพโค้ดจาก AI ไม่ใช่ฟรี ต้องจ่ายด้วย QA และกระบวนการ
ปัญหาที่ถูกพูดถึงน้อยคือ AI code quality ไม่เท่ากับคุณภาพโค้ดที่มนุษย์คุ้นเคย และในโปรดักชันจริง มาตรฐานควรถูกยกให้สูงขึ้นไม่ใช่ลดลง องค์กรหนึ่งประกาศชัดว่า โค้ดโปรดักชันที่ Claude เขียนต้องผ่านมาตรฐานที่สูงกว่าโค้ดที่มนุษย์เขียนเอง เพราะพวกเขาวาง guardrails หนาแน่น ตั้งแต่ lint rules จำนวนมาก การทดสอบจำนวนมาก การทดสอบแบบ end to end ที่ใช้ Claude เอง การทำ fuzzing รายวัน รีวิวโค้ดอัตโนมัติ รีวิวด้านความปลอดภัย และระบบรีแฟกเตอร์อัตโนมัติ
คำถามคือ ทีมทั่วไปที่รีบใช้ AI coding assistants เพื่อส่งของเร็ว มีราวกั้นระดับเดียวกันหรือไม่ หากไม่มี ความเร็วที่ได้มาจะกลายเป็นหนี้เทคนิคทันที เพราะทุกบรรทัดที่ AI เขียนต้องมีคนอ่าน ทดสอบ และรับผิดชอบในอนาคต การเพิ่มกติกา lint test และรีวิวอัตโนมัติทำให้ต้นทุน QA แฝงเพิ่มขึ้น แม้เวลาเขียนโค้ดสั้นลงก็ตาม ผลคือ productivity paradox ความเร็วที่อินเทอร์เฟซแสดงนั้น เป็นเพียงด้านเดียวของสมการ อีกด้านคือเวลาที่ใช้ทดสอบ แก้ regression และจับ bug ที่แอบซ่อนอยู่ในโค้ดที่ AI เขียน
ทางหนี rate limit จากโอเพ่นซอร์สและ local LLM deployment
เมื่อ rate limit และโควตาของ Claude ทำให้หลายคนรู้สึกติดกับ นักพัฒนาบางรายเริ่มหันหาเครื่องมือโอเพ่นซอร์สอย่าง OpenCode ซึ่งสร้างโดยทีมเล็กที่พัฒนาเฟรมเวิร์กสำหรับนักพัฒนา และออกแบบให้ทำงานกับผู้ให้บริการ AI ได้หลายราย แทนที่จะผูกกับผู้ให้บริการรายเดียว OpenCode เองไม่ตั้งเพดานการใช้งาน เพราะมันเป็นเพียงไคลเอนต์ ส่วนข้อจำกัดขึ้นกับผู้ให้บริการที่เชื่อมต่อผ่านคำสั่ง connect ขณะเดียวกันผู้ใช้รายเดิมสังเกตว่า บน Claude Code เพดานการใช้งานคือสิ่งที่ต้องคิดอยู่ตลอดเวลา แต่เมื่อใช้ OpenCode กับโมเดลฟรี เพดานเหล่านั้นแทบไม่ใช่ปัจจัย และบนโมเดลเสียเงินก็เป็นเรื่องของยอดคงเหลือที่ผู้ใช้ซื้อเองมากกว่าการถูกตัดการใช้งานกลางคัน
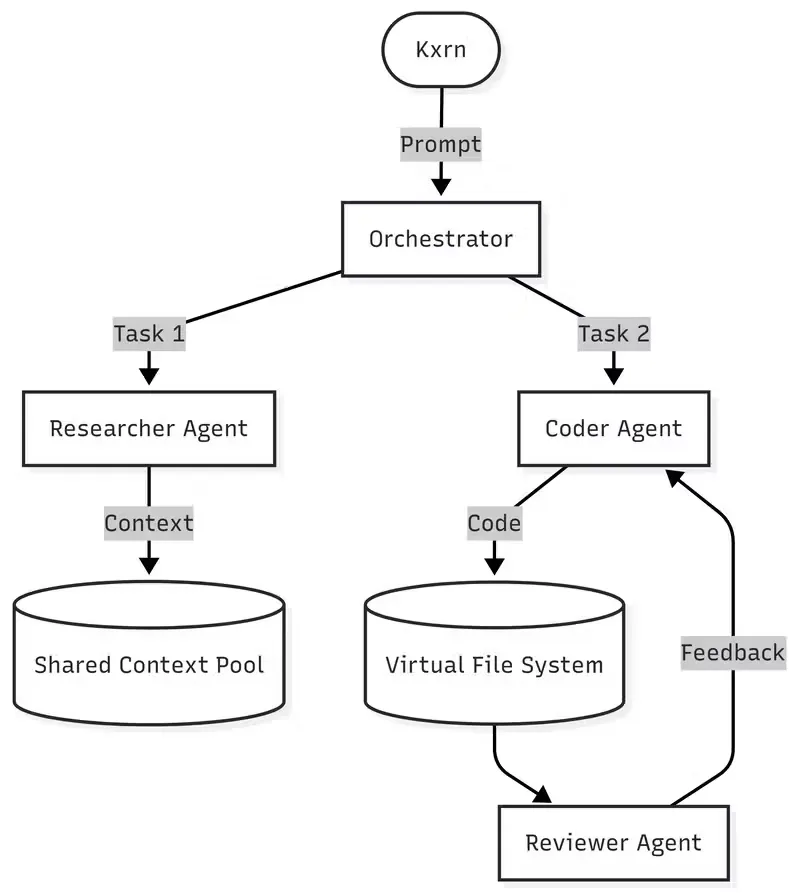
อีกฝั่งหนึ่ง นักพัฒนาที่หมกมุ่นกับระบบอัตโนมัติสร้าง SwarmForge ซึ่งเป็น multi agent AI coding orchestrator แบบศูนย์ค่าใช้จ่าย ร่วมกับผู้ช่วยท้องถิ่นที่ชื่อ O D I N โดยตั้งเป้าสร้างทีมเอเจนต์ลำดับชั้นทั้งผู้จัดการ นักวิจัย คนเขียนโค้ด และผู้รีวิว ที่ทำงานร่วมกันบน free tier APIs และโมเดลท้องถิ่น เพื่อให้รันบนเครื่องเก่าที่ใช้ i7 และการ์ดจอ 2GB เจ้าของระบบต้องหันไปใช้ local LLM deployment ด้วยโมเดลแบบ quantized ในฟอร์แมต GGUF ระดับ Q3 หรือ Q4 โหลดไว้ใน RAM เป็นหลัก ใช้ GPU แค่ช่วยบางเลเยอร์เท่านั้น นี่คือศิลปะในการชั่งน้ำหนักต้นทุน AI ระหว่างพึ่ง cloud API กับลงทุนเวลาเพื่อบีบประสิทธิภาพจากฮาร์ดแวร์ที่มีอยู่

จากคลาวด์สู่ไฮบริด ความเร็วที่ยั่งยืนต้องรวมโครงสร้างและวินัย
การหนีจาก rate limit ด้วย local LLM deployment ไม่ใช่แค่เรื่องเปลี่ยนผู้ให้บริการ แต่คือการเปลี่ยนวิธีคิดเรื่องโครงสร้างพื้นฐาน นักพัฒนาที่สร้าง SwarmForge และ O D I N ยอมรับว่า เป้าหมายคือระบบผู้ช่วยหลายเอเจนต์ที่ไม่เสียค่าใช้จ่ายเพิ่ม ต้องพึ่งทั้ง free tier APIs และโมเดลท้องถิ่น และยังต้องเคารพข้อจำกัดของฮาร์ดแวร์ทั้ง RAM และ GPU การใช้โมเดล quantized บน RAM 16GB หรือใกล้เคียง ทำให้เครื่องเก่ากลายเป็นระบบอัตโนมัติที่ทรงพลังได้ แต่แลกด้วยความซับซ้อนและทักษะด้านระบบเพิ่มขึ้น
ในมุมผู้ใช้ทั่วไป productivity paradox จึงปรากฏชัด AI coding assistants ช่วยให้เขียนโค้ดและปล่อยฟีเจอร์ได้เร็วขึ้น แต่คุณต้องจ่ายด้วยสามอย่าง หนึ่ง คือการบริหาร token ผ่านการเลือกบริบทอย่างระมัดระวังไม่เปิดทั้งโปรเจกต์ให้ Claude อ่านทุกครั้ง สอง คือการยอมรับว่ามาตรฐาน AI code quality ต้องสูงขึ้น พร้อมลงทุนใน lint test และ review กลางที่ AI และคนทำร่วมกัน สาม คือการตัดสินใจระหว่างติดอยู่กับ rate limit บนคลาวด์ กับลงทุนลงแรงสร้างระบบไฮบริดหรือ local ให้เหมาะกับฮาร์ดแวร์ของทีม ถ้าไม่อยากให้ความเร็ววันนี้กลายเป็นหนี้เทคนิคในวันหน้า นักพัฒนาต้องเลิกคิดว่า AI เป็นเวทมนตร์ และเริ่มมองมันเป็นส่วนหนึ่งของวินัยวิศวกรรมซอฟต์แวร์ที่ต้องออกแบบอย่างรอบคอบ