
AI coding agents คืออะไร และทำไมแอปโปรดักชันถึงออกได้จากพรอมต์เดียว
AI coding agents คือระบบปัญญาประดิษฐ์ที่ทำหน้าที่เหมือนนักพัฒนาซอฟต์แวร์เสมือน ตั้งแต่ทำความเข้าใจสเปก ออกแบบโครงสร้างระบบ เขียนโค้ด ทดสอบ ไปจนถึงสร้าง Pull Request โดยไม่ต้องให้มนุษย์ลงมือเขียนโค้ดเอง AI แบบนี้ถูกออกแบบให้ทำงานเป็นตัวหลักของกระบวนการพัฒนา ไม่ใช่แค่ผู้ช่วยตอบคำถามโค้ดสั้นๆ จึงสามารถรับโจทย์หนึ่งครั้งแล้วสร้างฟีเจอร์ครบวงจรให้แอปเนทีฟหรือเว็บแอปได้ในระดับที่พร้อมขึ้นโปรดักชัน
กรณีศึกษาที่ชัดที่สุดคือแอป Sojourn: Topical Bible Study ซึ่งผู้สร้างยืนยันว่าเป็นแอปที่เผยแพร่ได้โดยไม่ต้องพิมพ์โค้ดด้วยตัวเองแม้แต่บรรทัดเดียว เขาใช้ Claude Code เป็นแกนหลักของเวิร์กโฟลว์ สร้างฟีเจอร์ iOS ที่ซับซ้อนผ่านพรอมต์แบบ one-shot คือส่งคำสั่งครั้งเดียวให้เอเจนต์ดูแลตั้งแต่ต้นจนจบ แนวทางนี้ทำให้คำถามสำคัญเปลี่ยนจากว่าใช้โมเดลอะไร ไปเป็นว่าเราป้อนคอนเท็กซ์และตั้งเวทีให้เอเจนต์ทำงานดีพอหรือยัง
จากเว็บซับซ้อนถึงแอป iOS: เมื่อ Claude Code กลายเป็นช่างหลัก ไม่ใช่ผู้ช่วย
ในโลกจริงนักเขียนโค้ดหลายคนเริ่มปล่อยให้ AI coding agents ทำงานแทนแบบเต็มขั้น หนึ่งในตัวอย่างที่น่าสนใจคือการทดสอบให้ Claude Code, Codex และ Google Antigravity เขียนเว็บเดลิเวอรี่อาหารจากบรีฟเดียวกัน โดยไม่ให้คำใบ้หรือคำสั่งต่อเนื่องเพิ่มเติมเลย แม้ทั้งสามจะควรทำได้ดีบนกระดาษ แต่ผลลัพธ์แสดงชัดว่า Claude Code แตกต่างออกมาในฐานะเอเจนต์ที่ทำงานเสร็จดูเป็นโปรดักชันมากที่สุด
ผู้ทดสอบบอกว่า Claude Code ชนะด้วยความสม่ำเสมอ รายละเอียดอย่างตัวอักษร ระยะห่าง โมคอัพ ส่วนติดตามสถานะ คำถามที่พบบ่อย และจดหมายข่าวให้ความรู้สึกว่าจบงานเรียบร้อย นี่สะท้อนว่าใน Claude Code development จุดเด่นไม่ใช่แค่ความฉลาดของโมเดล แต่คือความสามารถของเอเจนต์ในการรักษารูปแบบงานทั้งหน้าให้ไปในทิศทางเดียวกัน ซึ่งสำคัญมากเมื่อเราปล่อยให้ AI ทำหน้าที่ช่างหลัก
เวิร์กโฟลว์ one-shot: ฟีเจอร์สิบกว่าหน้าจอจากพรอมต์เดียวและบริฟที่ถูกต้อง
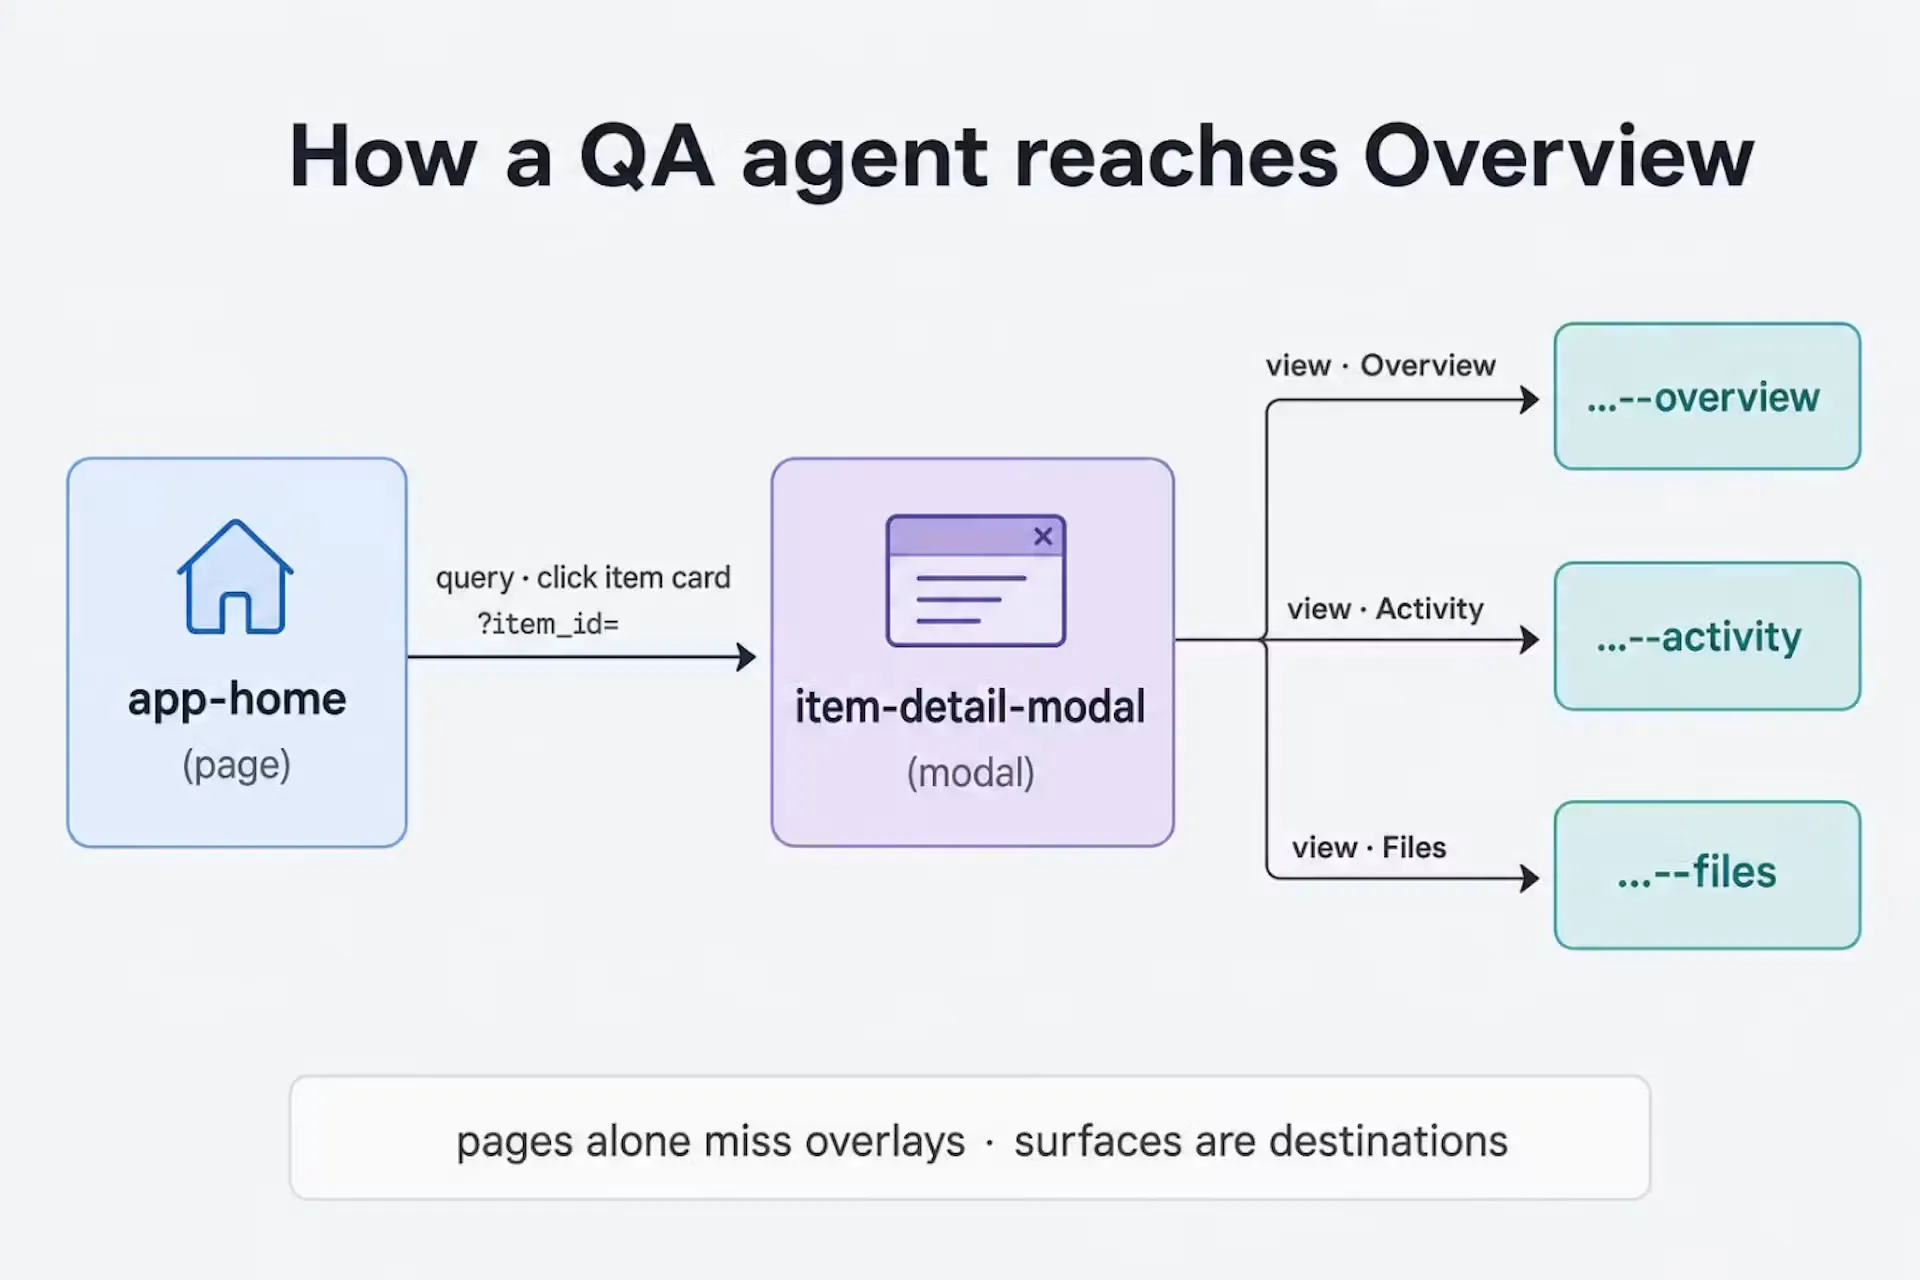
หัวใจของ app feature automation ไม่ได้อยู่ที่โมเดลรุ่นใหม่แค่ไหน แต่อยู่ที่เวทีที่เราปูให้ AI agent ทำงาน นักพัฒนาที่สร้าง Sojourn ใช้เวลาหลายวันร่างประสบการณ์ใช้งานผ่าน Claude Design สร้างต้นแบบฟังก์ชันแล้วเก็บเป็นคอนเท็กซ์ฐาน ซึ่งถูกอัปเดตอัตโนมัติและใช้ชี้นำขั้นตอนต่อไป เขาพบว่า Claude Code เข้าใจต้นแบบฟังก์ชันได้ลึกจน UX ของแอปจริงแทบจะเหมือนต้นแบบที่ AI เคยสร้างให้
จากนั้นเขาเก็บทุกฟีเจอร์เป็น GitHub issue เมื่ออธิบายครบก็ให้เอเจนต์สร้าง issue ตามเทมเพลต ก่อนจะใช้สกิล /gh-issue เรียกใช้ Claude Code ให้จัดการฟีเจอร์นั้นเอง เขาบอกว่า “Implementing a feature is as simple as me using the /gh-issue skill and passing the issue number to it I generally get up and leave the room at this point” ผลคือในไม่กี่สัปดาห์เขาสร้าง issue ไป 49 รายการ และปิดได้ 45 รายการหรือ 45 ฟีเจอร์ที่เสร็จแล้ว ที่น่าสนใจคือวิดเจ็ตหน้าจอหลักฟีเจอร์เดียวกินโค้ด 2,466 บรรทัดใน 27 ไฟล์ แต่ก็ยังมาจาก one-shot เดียว
เมื่อฮาร์ดแวร์บ้านๆ ก็รัน multi-agent systems ได้: local LLM optimization สำคัญกว่าโมเดลเทพ
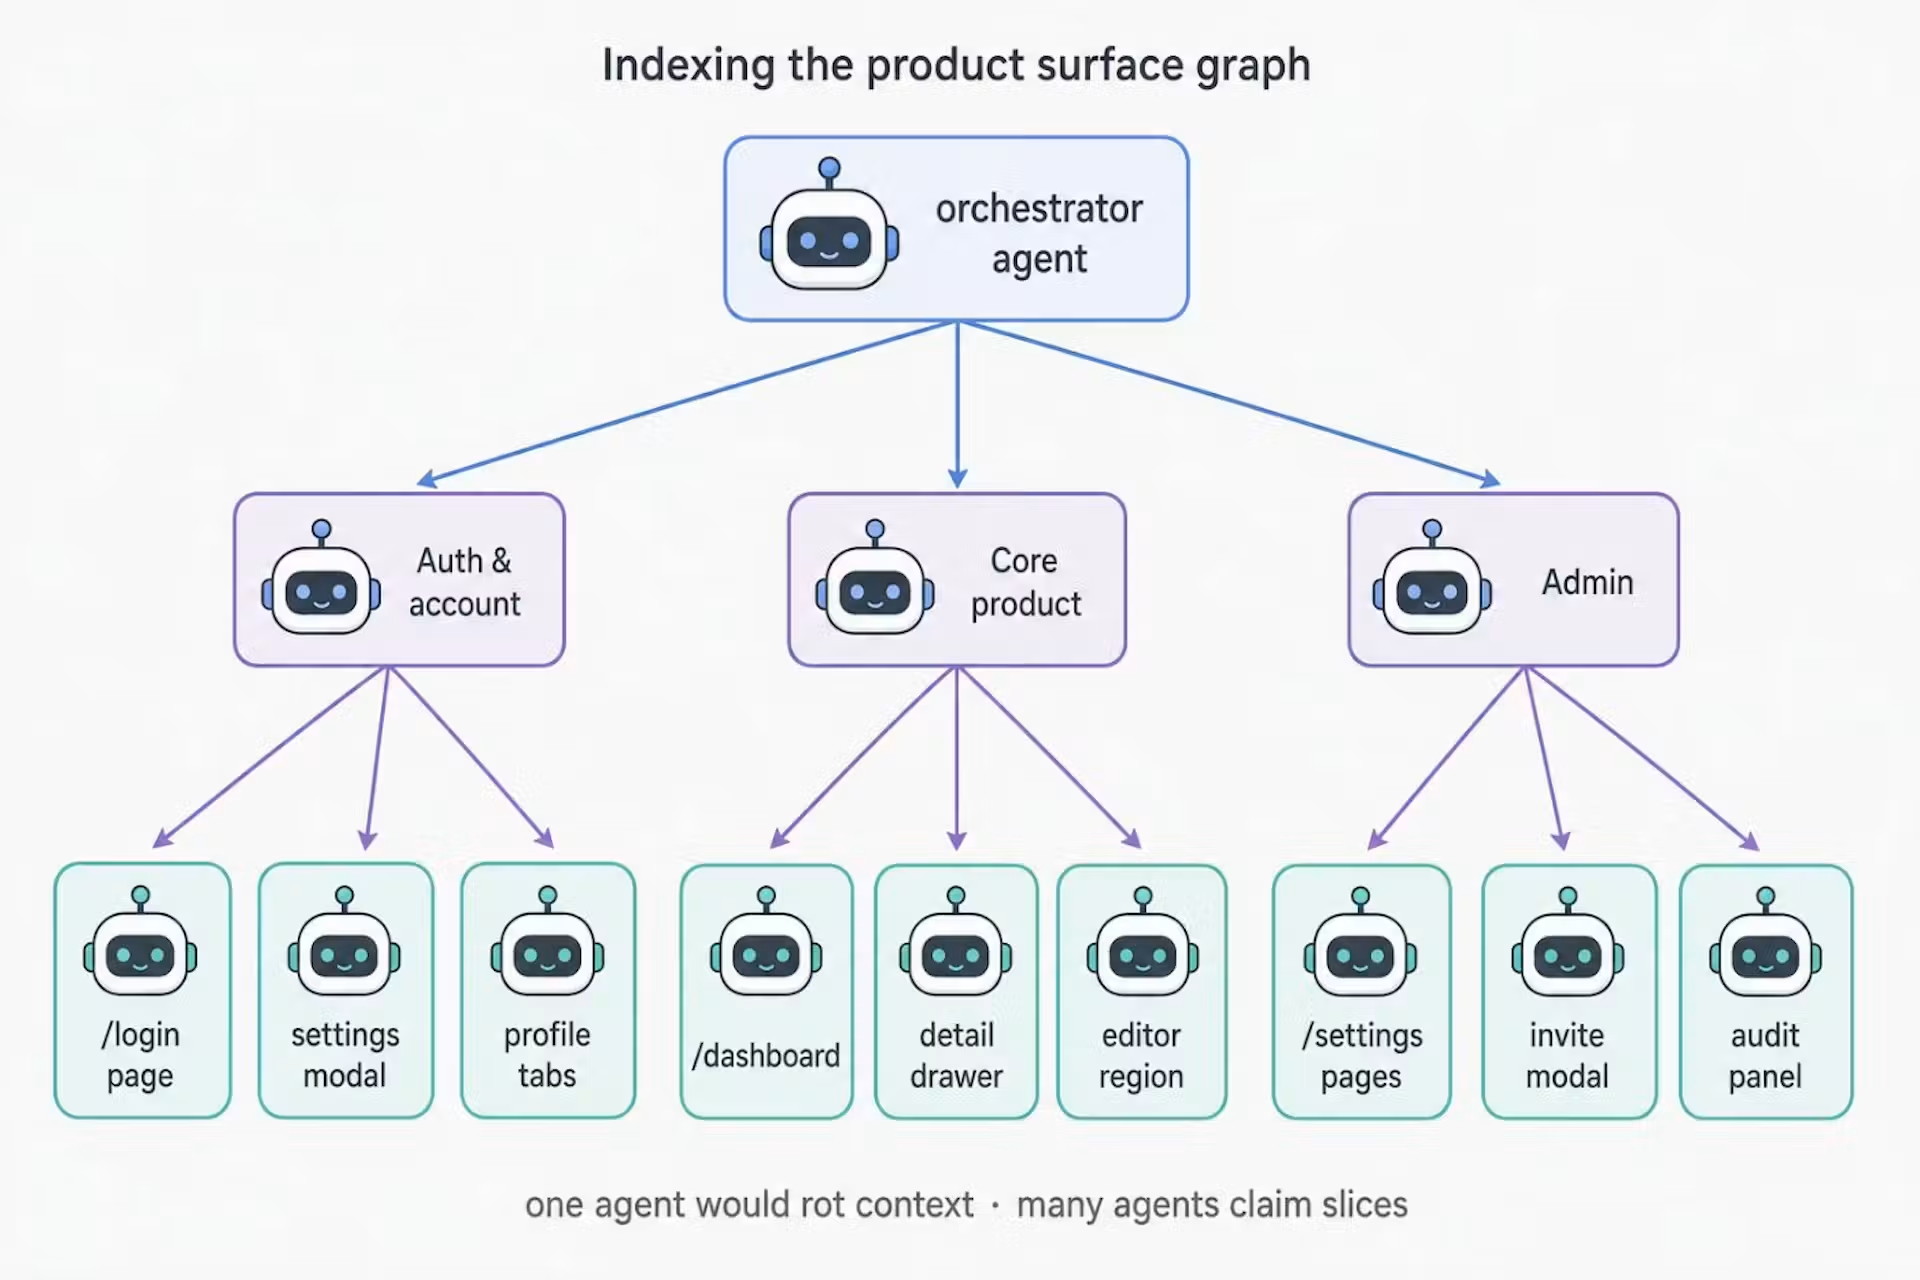
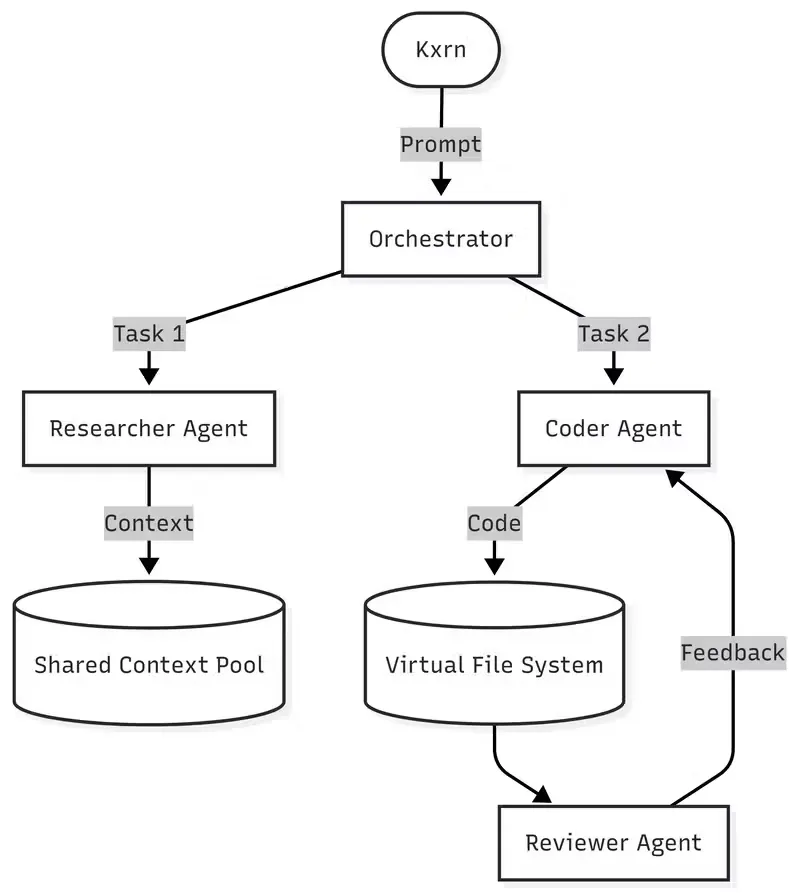
แนวคิดว่า AI coding agents ต้องพึ่งคลาวด์กำลังถูกท้าทาย นักพัฒนารายหนึ่งสร้าง SwarmForge ซึ่งเป็น orchestrator แบบ multi-agent ที่ตั้งเป้าให้มีทีมเอเจนต์เป็นลำดับขั้น ทั้งผู้จัดการ นักวิจัย คนเขียนโค้ด และรีวิวเวอร์ เพื่อรับงานโค้ดซับซ้อนโดยอัตโนมัติ และต้องใช้ต้นทุนศูนย์ผ่าน API ฟรีและโมเดลท้องถิ่น เขาทำทั้งหมดนี้บนเครื่องเดสก์ท็อป Intel Core i7-4790 แรม 16GB และการ์ดจอ GTX 1050 OC
ด้วยการ์ดจอแค่ 2GB VRAM เขาไม่สามารถรันโมเดลใหญ่แบบมาตรฐานได้ จึงหันไปใช้ quantized models รูปแบบ GGUF แบบ Q3 หรือ Q4 โหลดหลักไว้ในหน่วยความจำหลักของเครื่อง ใช้ GPU แค่เร่งบางเลเยอร์เท่านั้น เขาเน้นให้บริบทสั้นและกำหนดบทบาทเอเจนต์อย่างเข้มงวด ทำให้ SwarmForge สร้างโค้ดคุณภาพดีได้โดยไม่ต้องพึ่ง multi-agent systems บนคลาวด์ราคาแพง จุดนี้ชี้ชัดว่าการปรับแต่ง local LLM optimization และการบริฟเอเจนต์ให้ชัด มีผลมากกว่าการไล่ตามโมเดลใหญ่สุดเสมอ
speculative decoding ทำให้ AI บนเครื่องรู้สึกทันใจ จนไม่คิดถึงคลาวด์อีก
อีกมุมหนึ่งของ local LLM optimization คือเทคนิค speculative decoding ซึ่งใช้โมเดลขนาดเล็กเป็น draft model และโมเดลใหญ่เป็น executor เพื่อเร่งการสร้างคำตอบ นักพัฒนารายหนึ่งเริ่มจากโครงแบบผสมคลาวด์กับโมเดลท้องถิ่น ใช้ GPT-5.6 Luna วางแผนและรีวิวงาน ส่วน Qwen 3.5-9B รับหน้าที่ลงมือ แต่เขาต้องการเลิกพึ่งคลาวด์เลยหันมาปรับปรุงโมเดลท้องถิ่นแทน
เขาตั้งค่าด้วย Llama 3.1 8B เป็นโมเดลหลักและ Llama 3.2 1B เป็น draft model ผลคืออัตราการสร้างข้อความจาก 23.35 โทเคนต่อวินาที เพิ่มเป็น 29.46 โทเคนต่อวินาที หรือเพิ่มขึ้นราว 26 เปอร์เซ็นต์ โดยคุณภาพคำตอบไม่ลดลง เขาสรุปว่า speculative decoding ทำให้โมเดลท้องถิ่นตอบสนองได้เร็วจนรู้สึกดีกว่าการใช้คลาวด์ API ที่สำคัญคือเราจะใช้เวลาเฝ้ามองโมเดลพิมพ์คำตอบน้อยลง และมีเวลาทำงานกับคำตอบมากขึ้น เมื่อผนวกเข้ากับโครงแบบ multi-agent และการโหลดโมเดลแบบขี้เกียจ นักพัฒนาจึงสามารถสร้างเวิร์กโฟลว์ AI บนเครื่องที่แข่งขันกับคลาวด์ได้โดยไม่ต้องเสียทรัพยากรเกินจำเป็น