
โมเดลเล็กสำหรับงานที่เอเจนต์ทำซ้ำ
โมเดล Muse Ember คือโมเดล AI ขนาดเล็กของ Meta ที่ออกแบบมาเพื่อทำงานย่อยซึ่งเอเจนต์ AI ต้องทำซ้ำ เช่น เรียกใช้เครื่องมือ เขียนโค้ดบางส่วน จัดเส้นทางงาน ดึงข้อมูล และแยกวิเคราะห์เอกสารยาว โดยเน้นความคุ้มค่าและการทำงานต่อเนื่องเป็นหลัก Meta AI Research เปิดตัวโมเดลนี้เมื่อวันที่ 9 พฤศจิกายน 2026 พร้อมวางตำแหน่งเป็นโมเดลที่เล็กที่สุดของบริษัทและเหมาะกับงานลักษณะดังกล่าว จุดขายจึงไม่ใช่การให้โมเดลตัวเดียวคิดแทนทุกอย่าง แต่เป็นการให้โมเดลหลักแบ่งงาน แล้วส่งขั้นตอนที่มีรูปแบบชัดเจนให้โมเดลเล็กลงรับช่วงต่อ
เหตุผลทางธุรกิจฟังขึ้น เพราะ Meta ระบุว่าเอเจนต์ใช้โทเค็นจำนวนมากกับงานย่อยที่มีโครงสร้าง เช่น การเรียกเครื่องมือและประมวลผลข้อมูล ในระบบที่โมเดลระดับแนวหน้าวางแผนแล้วแจกงานให้เอเจนต์ โมเดล Muse Ember จึงอาจลดภาระการเรียกโมเดลราคาแพงซ้ำ ๆ หากต้นทุนการทดลองลดลง ทีมอาจกล้าทดลองมอบหมายงานให้เอเจนต์ครอบคลุมขั้นตอนมากขึ้น แต่ความคุ้มค่าจริงยังขึ้นอยู่กับจำนวนครั้งที่ต้องเรียกใช้ การแก้ข้อผิดพลาด และเวลาที่คนต้องตรวจงาน

ประโยชน์ที่เห็นได้ในงานประจำและการเขียนโค้ด
สำหรับ AI เขียนโค้ด Ember รับงานย่อยที่เอเจนต์อาจส่งให้ทำหลายครั้งในหนึ่งช่วงการทำงาน ตั้งแต่อ่านไฟล์ รันทดสอบ ไปจนถึงแก้โค้ดเฉพาะจุด ส่วนงานธุรกิจสามารถดึงระเบียน เรียกเครื่องมือตามลำดับ และอัปเดตข้อมูลข้ามแอปพลิเคชันได้ ในมุมผู้ใช้ปลายทาง ประโยชน์อาจอยู่ที่งานเบื้องหลัง เช่น สรุปเอกสารหรือจัดการข้อมูล ไม่ใช่การสนทนาที่ดูฉลาดขึ้นอย่างเห็นได้ชัด
Meta ระบุว่าโมเดลรองรับข้อความ ภาพ เสียง และวิดีโอ รวมถึงการอ่านภาพหน้าจอ กราฟ เอกสารสแกน บันทึกเสียง และวิดีโอ นอกจากนี้ยังมีหน้าต่างบริบท 1 ล้านโทเค็นสำหรับรับโค้ดเบสหรือชุดเอกสารในคำขอเดียว และสร้างผลลัพธ์ได้สูงสุด 512,000 โทเค็น ความสามารถเหล่านี้น่าสนใจสำหรับงานที่ข้อมูลกระจัดกระจายหลายรูปแบบ แต่ตัวเลขความจุไม่ได้ยืนยันว่าโมเดลจะเข้าใจรายละเอียดได้ถูกต้องทุกครั้ง จึงควรเริ่มจากงานที่ตรวจคำตอบย้อนกลับได้

ตัวเลขชวนใช้ แต่ไม่ใช่หลักประกันคุณภาพ
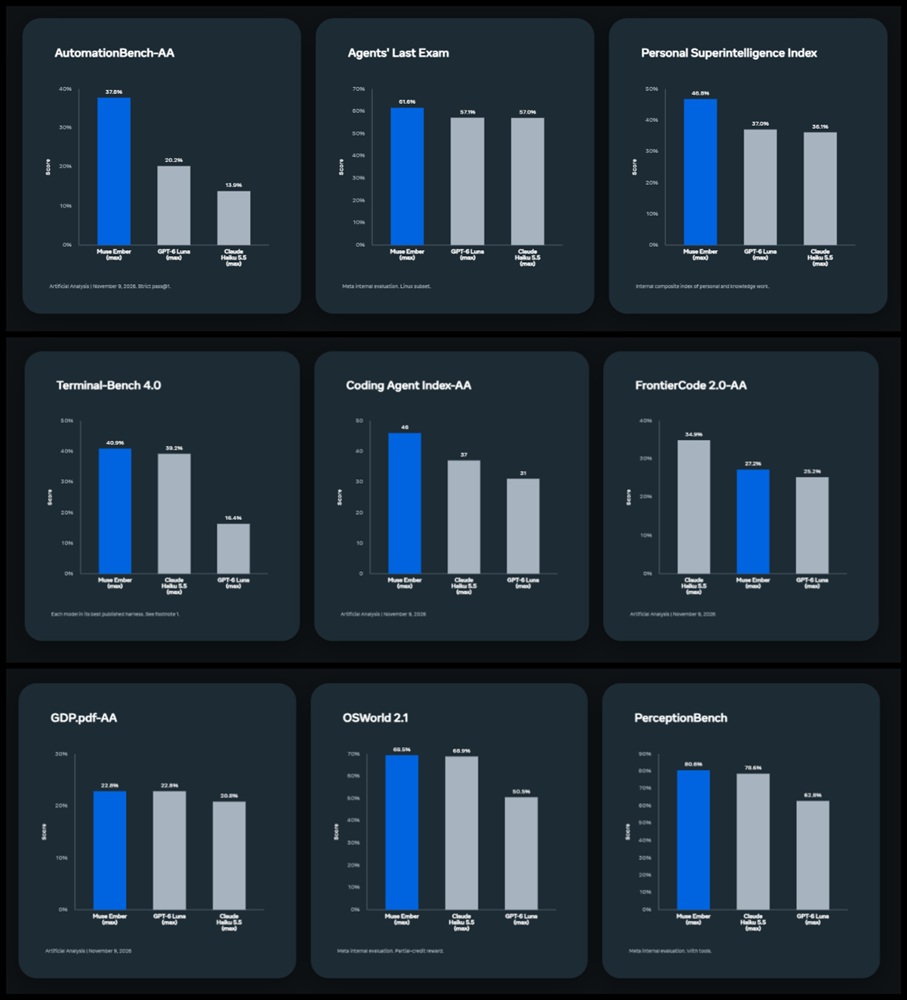
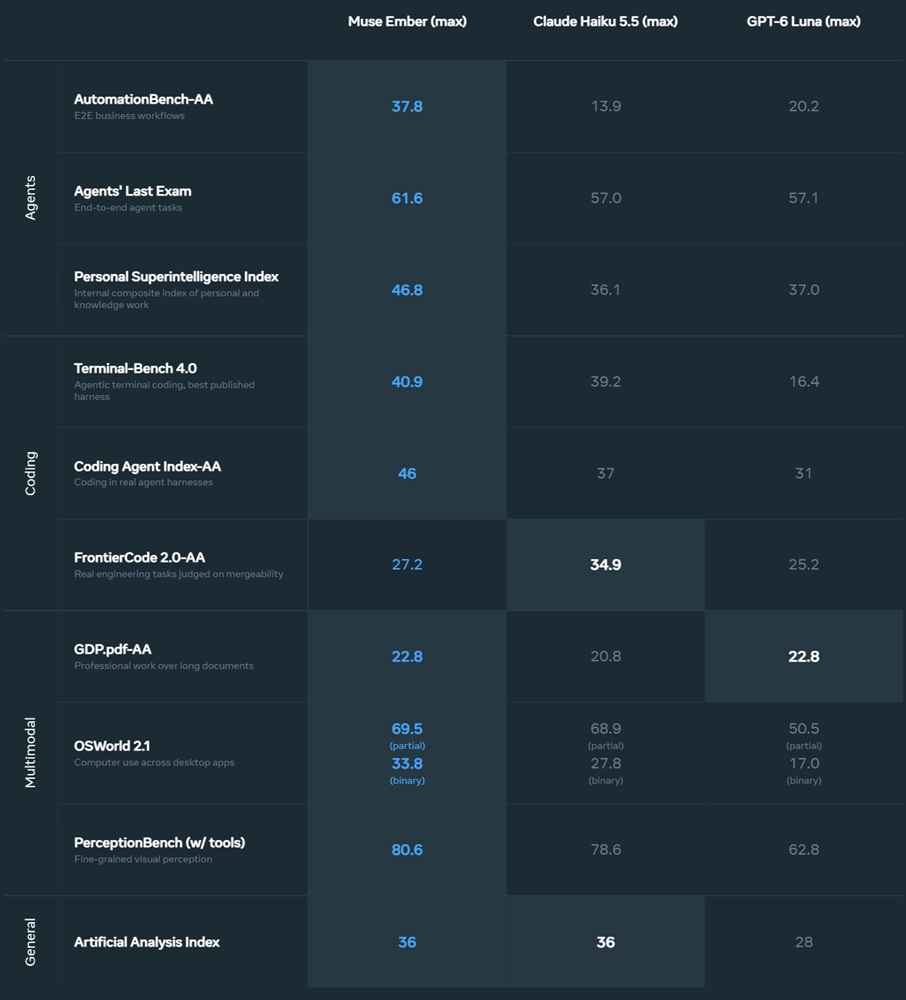
ผลประเมินที่ Meta รายงานสนับสนุนการวาง Ember ไว้ในบทบาทผู้ปฏิบัติงานซ้ำ ๆ โดยได้คะแนน AutomationBench-AA 37.8% เทียบกับ Claude Haiku 5.5 ที่ 13.9% และ GPT-6 Luna ที่ 20.2% ส่วน Terminal-Bench 4.0 อยู่ที่ 40.9% เทียบกับ 39.2% และ 16.4% ตามลำดับ อย่างไรก็ตาม ผลไม่ได้ชี้ว่า Ember นำทุกด้าน เพราะใน FrontierCode 2.0-AA โมเดลได้ 27.2% ต่ำกว่า Haiku ที่ 34.9% ข้อแตกต่างนี้สำคัญ: งานเขียนโค้ดเป็นการตั้งชื่อกว้าง ๆ ให้ภารกิจหลายแบบ คะแนนงานเอเจนต์ที่ดีจึงไม่รับประกันว่าจะรวมโค้ดเข้ากับโครงการจริงได้ดีที่สุด
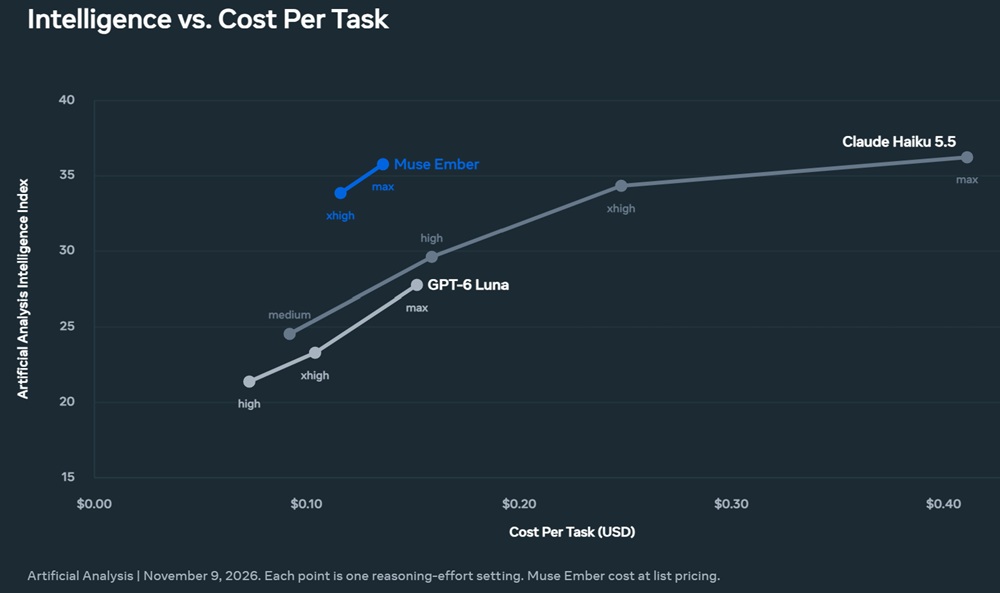
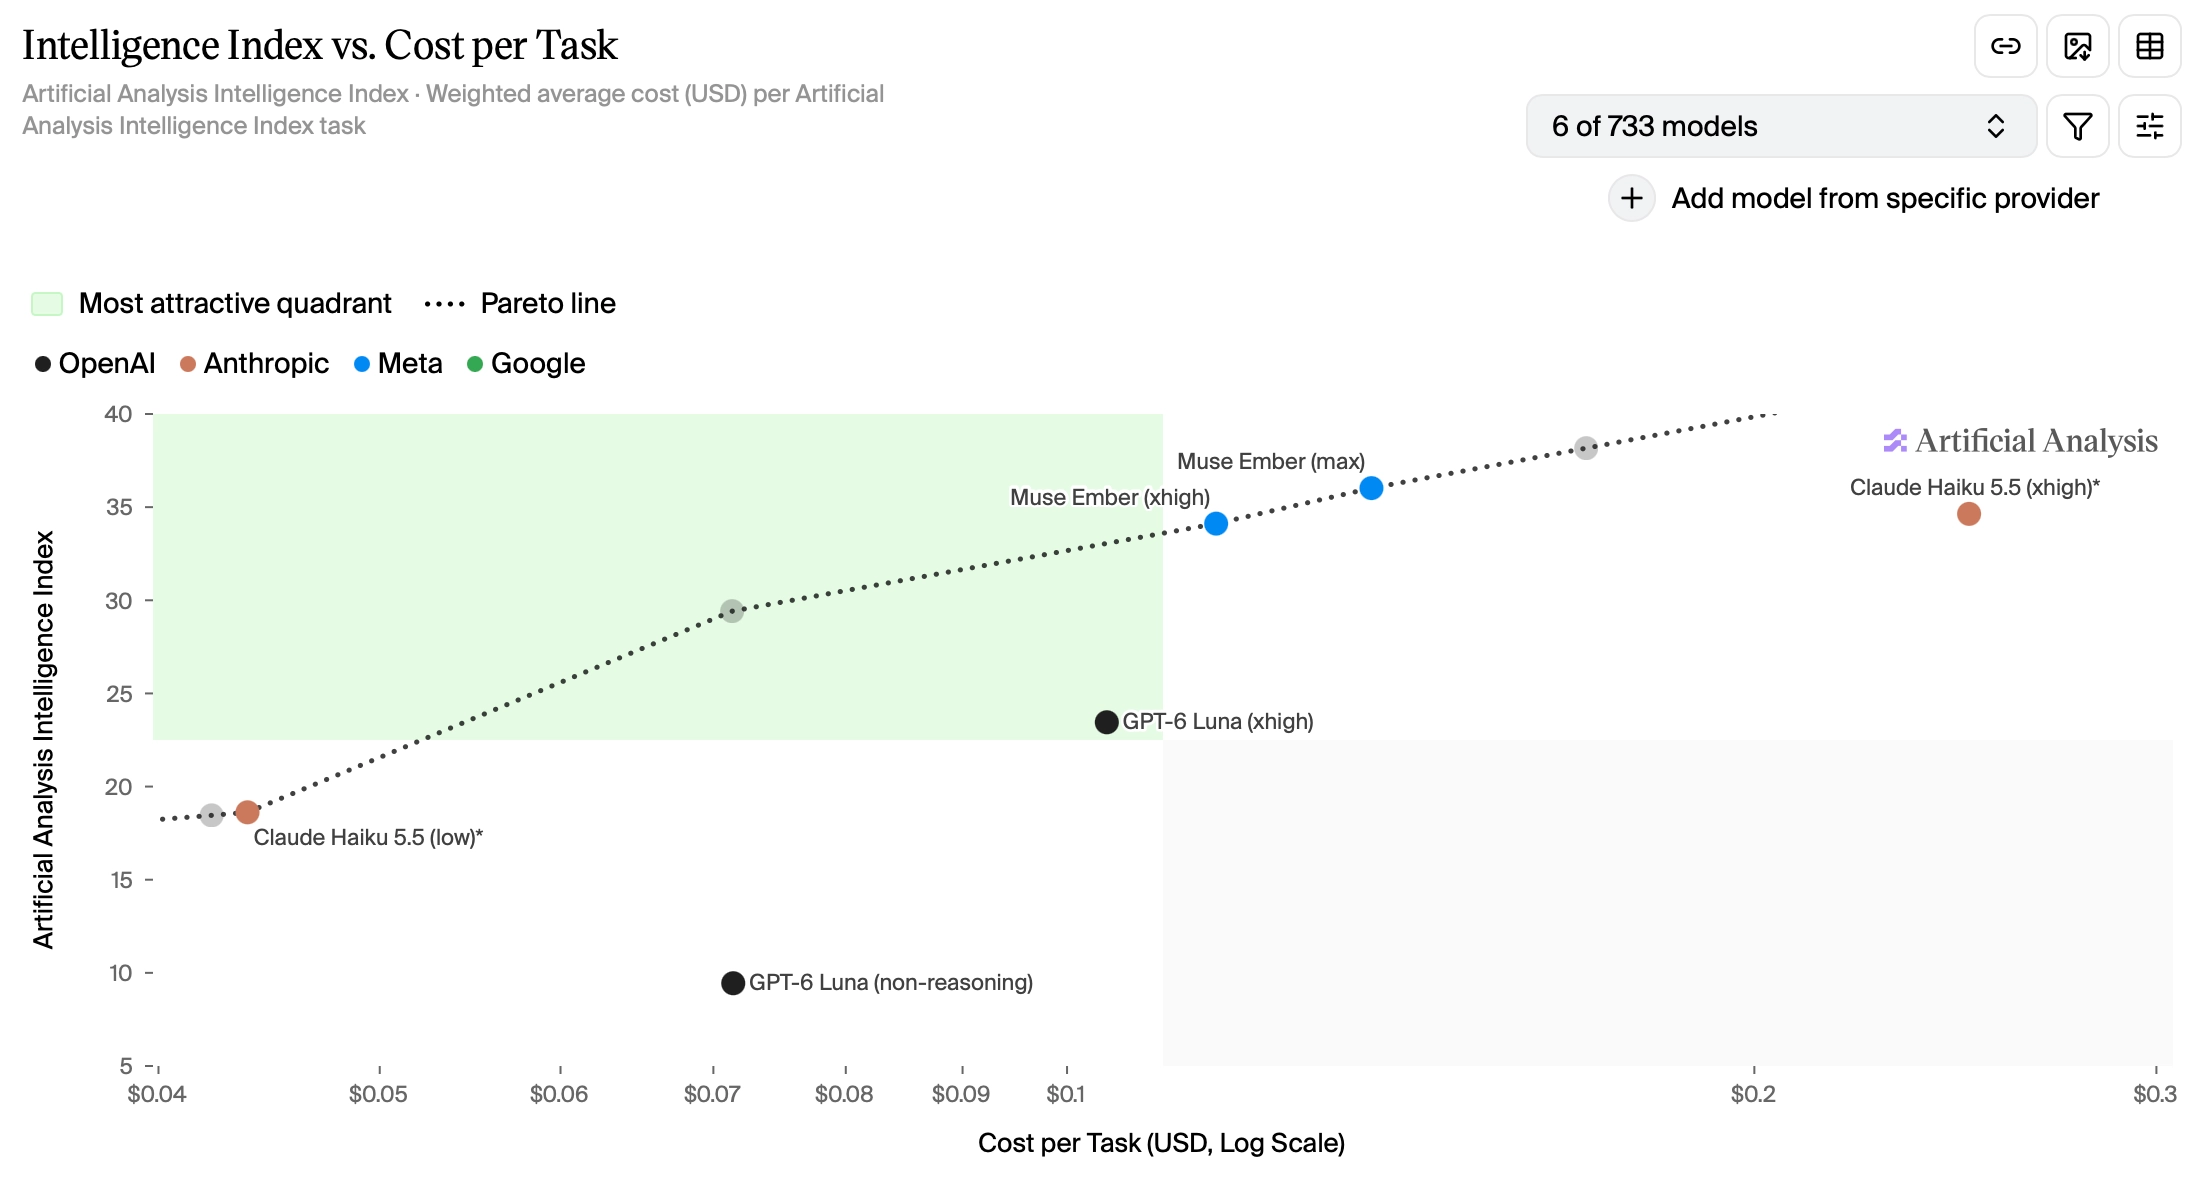
Meta ยังรายงานคะแนน Intelligence Index 36 สำหรับ Ember เทียบกับ 37 สำหรับ Muse Spark 1.3 ขณะที่ค่าใช้จ่ายต่อภารกิจในชุดเปรียบเทียบอยู่ที่ 0.14 และ 2.39 ดอลลาร์ตามลำดับ ตัวเลขดังกล่าวเป็นผลประเมินและการคำนวณตามข้อมูลที่บริษัทนำเสนอ ไม่ใช่คำรับรองผลในระบบของทุกทีม การทดสอบควรใช้ชุดงานขององค์กรเอง วัดความถูกต้อง จำนวนครั้งที่ต้องลองใหม่ การเรียกเครื่องมือผิดพลาด และเวลาที่มนุษย์ใช้แก้ผลลัพธ์ โดยเฉพาะงานที่ความผิดพลาดส่งผลต่อข้อมูลหรือระบบงาน
เริ่มจากงานเสี่ยงต่ำ แล้วค่อยเพิ่มขอบเขต
แนวทางที่สมเหตุผลคือให้ Muse Wonder วางแผนงานซับซ้อน แล้วให้ Ember รับช่วงงานซ้ำที่กำหนดขอบเขตชัดเจน ซึ่งเป็นการแบ่งหน้าที่ที่ Meta แนะนำ สำหรับทีมพัฒนา อาจเริ่มจากอ่านไฟล์ ทดสอบ และเสนอการแก้ไขที่คนตรวจได้ ก่อนอนุญาตให้เอเจนต์เปลี่ยนข้อมูลหรืออัปเดตระบบโดยอัตโนมัติ วิธีนี้ช่วยแยกได้ว่าประโยชน์มาจากความสามารถของโมเดล หรือจากการออกแบบเวิร์กโฟลว์และจุดตรวจของทีม
ข้อสรุปคือโมเดล AI ขนาดเล็กอย่าง Ember มีเหตุผลรองรับเมื่อใช้กับงานย่อยที่เกิดบ่อยและวัดผลได้ แต่คำกล่าวอ้างด้านประสิทธิภาพควรถูกมองเป็นจุดเริ่มต้นของการทดสอบ ไม่ใช่คำตอบสุดท้าย ทีมควรเปรียบเทียบกับวิธีทำงานเดิมในงานจริง และกำหนดเงื่อนไขหยุดเมื่อคุณภาพตกหรือเกิดข้อผิดพลาด Meta ระบุว่ามีโมเดลที่มีประสิทธิภาพมากขึ้นอยู่ระหว่างการฝึก ระหว่างรอ สิ่งที่ควรเร่งทำไม่ใช่การมอบอำนาจให้เอเจนต์ทุกงาน แต่คือการหางานที่ทำซ้ำได้ ปลอดภัย และคุ้มเมื่อมอบหมาย