
ทำไมการตรวจงาน AI coding agent ถึงกลายเป็นคอขวด
AI coding agent verification คือกระบวนการตรวจสอบโค้ดที่สร้างโดย AI coding agent ว่าถูกต้อง ปลอดภัย และสอดคล้องมาตรฐานของทีม โดยไม่ผูกติดกับเครื่องมือหรือโมเดลตัวใดตัวหนึ่ง เป้าหมายคือให้ทุกเอาต์พุตผ่านเกณฑ์เดียวกันทั้งด้านคุณภาพ การทดสอบ และการใช้เครื่องมือพัฒนาซอฟต์แวร์อย่างถูกวิธี เพื่อให้ทีมพัฒนาเพิ่มความเร็วได้โดยไม่ลดความน่าเชื่อถือของระบบลง
หลายทีมใช้ AI coding agent หลายตัวสลับกันไปมา และโมเดลเบื้องหลังก็เปลี่ยนบ่อย ทำให้มาตรฐานคุณภาพเสี่ยงจะผูกกับเครื่องมือที่ใช้สร้างโค้ดแทนที่จะผูกกับหลักวิศวกรรมที่ทีมกำหนดเอง ปัญหาใหญ่คือ pull request จาก agent มักมีขนาดใหญ่กว่าของมนุษย์หลายเท่า ทำให้การรีวิวด้วยมือไม่สามารถรองรับปริมาณงานได้ เมื่อปล่อยให้ agent ตรวจงานตัวเอง ยิ่งเสี่ยงเจอปัญหาไม่มีการแยกหน้าที่ ไม่มีผลลัพธ์ที่ทำซ้ำได้ และไม่มีหลักฐานตรวจสอบย้อนหลังที่ชัดเจน
ข้อผิดพลาดที่พบได้บ่อยมีทั้งระดับโค้ดและระดับการใช้เครื่องมือ ด้านโค้ดเช่นมีกรณีที่ pull request แรกๆ ของ agent สร้าง mock ให้โมดูลที่คอมโพเนนต์ไม่ได้ import เลย ทำให้เทสต์ผ่านและ coverage เพิ่ม แต่ mock ทั้งหมดไม่มีประโยชน์ ด้านการใช้เครื่องมือ AI agent อาจเลือก API ผิด มองข้ามคำแนะนำสำคัญในเอกสาร หรือหยุดทำงานเมื่อเจอข้อผิดพลาด ทั้งที่โค้ดสุดท้ายอาจรันได้แต่ไม่ได้ใช้เครื่องมือที่ทีมคาดหวัง ถ้าไม่มีกรอบตรวจสอบกลาง ปัญหาเหล่านี้จะเล็ดลอดเข้า production ง่ายมาก

วางหลักคิด: แยกหน้าที่ วิเคราะห์แบบกำหนดได้ และตั้ง code quality gates
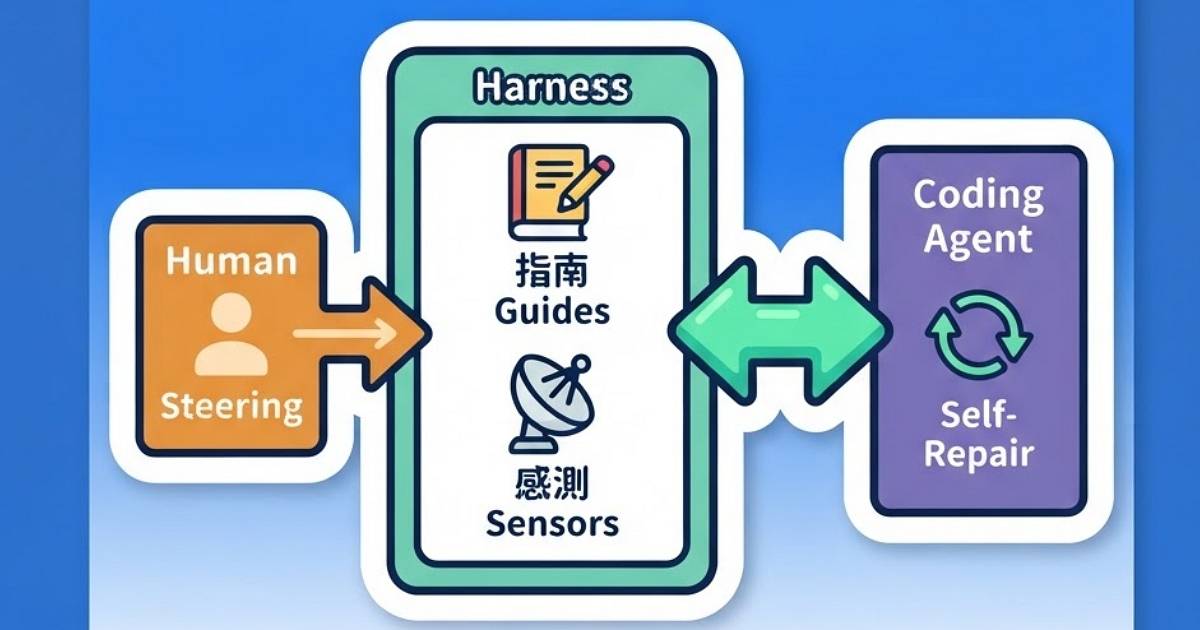
หัวใจของกรอบคิดนี้คือแยกบทบาทระหว่างการสร้างโค้ดกับการตรวจโค้ดให้ชัด AI ทำหน้าที่สร้าง ส่วนการตรวจต้องมาจากระบบอิสระที่ให้ผลเหมือนเดิมทุกครั้ง การวิเคราะห์เชิงกำหนดหรือ deterministic analysis จะช่วยจับประเด็นซับซ้อนทั้ง syntax data flow control flow และโครงสร้างที่ agent มักมองข้าม และให้ผลเหมือนกันทุกครั้งที่รัน จึงตรวจสอบย้อนหลังได้ แนวคิดนี้ทำให้คุณไม่ต้องพึ่ง “ความเห็น” ของ agent เพียงอย่างเดียว แต่มีชั้นตรวจที่วัดได้และอ้างอิงได้
จากนั้นต้องแปลงมาตรฐานคุณภาพให้กลายเป็น code quality gates ที่บังคับใช้ใน CI/CD pipeline แทนที่จะเป็นเช็กลิสต์ในหัวของ reviewer เกณฑ์คุณภาพใน CI/CD จะเปลี่ยนมาตรฐานให้กลายเป็นจุดตัดสินที่บังคับใช้ได้จริง มีคนรับผิดชอบผลการผ่านไม่ผ่าน และมีระบบบันทึกทุกครั้งที่ตัดสิน หรือพูดได้ว่า AI generates Sonar verifies คือให้ AI สร้าง แต่ให้ระบบวิเคราะห์อิสระเป็นผู้ตัดสินคุณภาพ วิธีนี้ลดภาระรีวิวมือ แต่ยังรักษาความรับผิดชอบของมนุษย์ไว้ที่ระดับการกำหนดเกณฑ์และการตัดสินใจสุดท้าย
เมื่อทีมเริ่มใช้กรอบคิดนี้ ผลที่คาดหวังคือคุณภาพจะค่อยๆ ดีขึ้นผ่านการเปลี่ยนแปลงเล็กๆ ที่รีวิวได้จริง มีตัวอย่างทีมที่ให้ agent เปิด pull request เพิ่มเทสต์แบบเจาะจงไฟล์เดียวต่อรอบ ทำให้ coverage ของทั้ง repository ขยับจากประมาณ 70% ไปที่ 82% ภายในราวสี่สัปดาห์ และการเพิ่ม coverage เกิดจากการเปลี่ยนแปลงเล็กๆ ที่รีวิวได้ นี่คือภาพปลายทางที่คุณควรเล็งไว้เมื่อออกแบบกรอบตรวจงาน AI coding agent verification
ขั้นตอนทีละสเต็ป: จาก CI/CD automation ไปถึง SonarQube MCP Server และ Scope
ส่วนนี้คือโครงเดินงานแบบทีละขั้นสำหรับทีมที่อยากตรวจงาน AI coding agent verification แบบไม่ผูกกับเครื่องมือใดเครื่องมือหนึ่ง เป้าหมายคือให้ทุก agent ผ่านเกณฑ์เดียวกัน ตั้งแต่ในเครื่องมือเขียนโค้ดไปจนถึง CI/CD automation และระบบประเมินประสิทธิภาพของ agent เอง
- กำหนดมาตรฐานคุณภาพและ code quality gates กลางของทีม เช่น เกณฑ์ static analysis ระดับความรุนแรงของ issue ที่ยอมรับได้ และระดับ coverage ขั้นต่ำ แล้วฝังเกณฑ์นี้เป็น quality gate ใน CI/CD pipeline เพื่อให้ทุกการเปลี่ยนโค้ดต้องผ่านเกณฑ์เดียวกันก่อน merge
- ตั้ง CI/CD automation ให้รัน deterministic analysis ทุกครั้งที่มี pull request โดยใช้เครื่องมือวิเคราะห์โค้ดที่ให้ผลเหมือนเดิมทุกครั้ง เพื่อจับปัญหาเชิงโครงสร้าง data flow และ control flow ที่ agent อาจมองไม่เห็น และบันทึกผลการผ่านไม่ผ่านไว้เป็นหลักฐานตรวจสอบภายหลัง
- เชื่อม AI coding agent เข้ากับ SonarQube MCP Server เพื่อส่งสัญญาณคุณภาพจากระบบวิเคราะห์เข้าสู่ workflow ของ agent โดยตรง SonarQube MCP Server ทำหน้าที่เป็นสะพานเชื่อมให้มาตรฐานเดียวกันใช้ได้กับหลายเครื่องมือ และอาศัย SonarQube เป็นผู้ทำการวิเคราะห์เบื้องหลัง ทำให้ไม่ว่า agent ตัวไหนจะสร้างโค้ด ก็ต้องผ่านเกณฑ์เดียวกันก่อนจะไปถึง reviewer
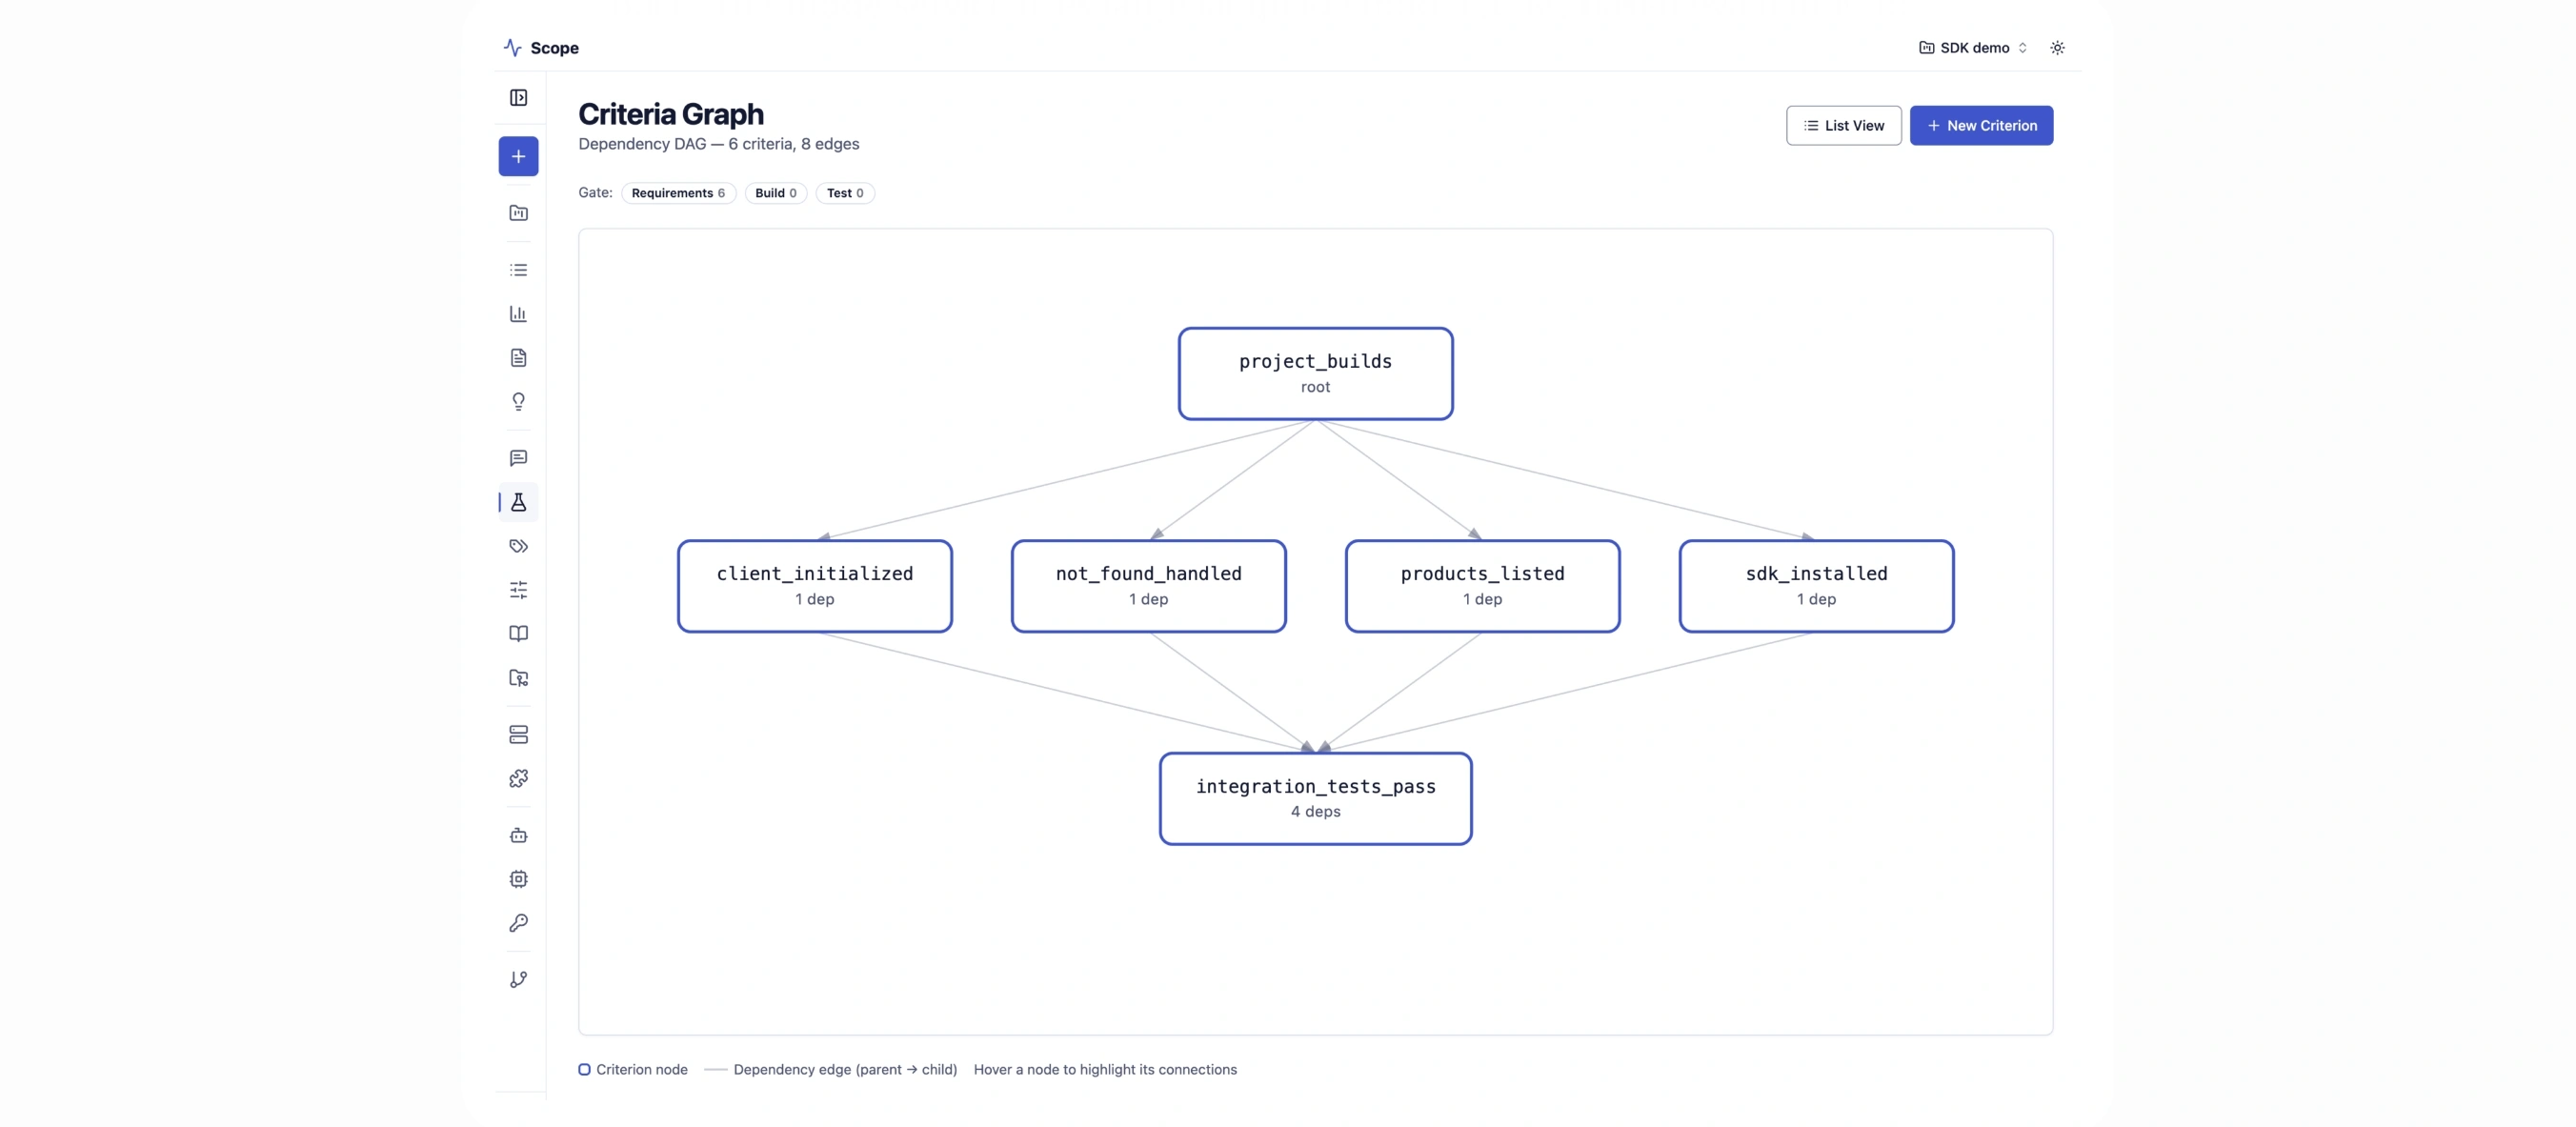
- ใช้แพลตฟอร์ม Scope เพื่อตรวจสอบว่า agent ใช้ SDK API และเครื่องมือที่ทีมเตรียมไว้ได้ถูกต้องหรือไม่ โดยตั้งภารกิจที่ชัดเจน กำหนดเกณฑ์การสำเร็จ และให้ agent หลายตัวทำงานเดียวกัน Scope จะบันทึกโมเดลที่ใช้ เวอร์ชันของ agent และการตั้งค่าทูลไว้ทุกครั้ง เมื่อมีการเปลี่ยนเอกสารหรือเครื่องมือ คุณสามารถรันภารกิจเดิมซ้ำเพื่อดูว่า agent ทำงานได้ดีขึ้นหรือยัง และแยกได้ว่าความผิดพลาดเป็นเหตุการณ์เฉพาะครั้งหรือเกิดซ้ำ
- เพิ่ม unit test automation ด้วย scheduled AI agents ใน pipeline เช่น ตั้ง agent ให้ค้นหาไฟล์ที่ coverage ต่ำ เขียนเทสต์ที่ขาด และเปิด pull request ให้คนรีวิวตามตารางเวลาทุกเช้าวันทำงาน pipeline แบบนี้เคยถูกใช้ใน repository ใหม่ ทำให้ coverage ขยับจากประมาณ 70% ไป 82% ภายในราวหนึ่งเดือน จากชุด pull request ที่เล็กและรีวิวได้
ระหว่างทำตามขั้นตอนเหล่านี้ จุดที่ต้องระวังคืออย่าให้ agent มีอำนาจตัดสินคุณภาพของตัวเองทั้งหมด ต้องมีระบบวิเคราะห์อิสระและ code quality gates ใน CI เป็นตัวกรองสุดท้าย และอย่าลืมตรวจดูว่าการเพิ่ม automation ไม่ทำให้ reviewer มองข้ามสัญญาณเตือนสำคัญ เช่น เทสต์ที่ผ่านแต่ไม่ได้ทดสอบพฤติกรรมจริง หรือการใช้ API ผิดแม้โค้ดจะรันได้
ทำให้เป็นนิสัยประจำวัน: scheduled agents และนิสัยเทสต์ที่ดี
เมื่อกรอบตรวจสอบเริ่มเข้าที่ ขั้นต่อไปคือทำให้มันกลายเป็นนิสัยของทีม ไม่ใช่แค่โปรเจกต์ทดลองเดียว ตัวอย่างที่เห็นภาพคือการใช้ scheduled AI agents ใน CI/CD automation ให้ช่วยเขียน unit test แบบต่อเนื่อง หนึ่งในทีมพาณิชย์มี agent ที่รันตามตารางเพื่อค้นหาไฟล์ที่เทสต์บาง เขียนเทสต์ที่ขาด และเปิด pull request ให้รีวิว pipeline ที่ตั้งเวลาไว้ทุกเช้าวันทำงานช่วยให้ pull request มาถึงตอนที่ทีมพร้อมรีวิว และไม่ต้องรอให้ใครสังเกตเองว่าไฟล์ไหน coverage ต่ำ
อย่างไรก็ตาม automation ไม่ได้แปลว่าปลอดภัยเสมอไป ตัวอย่างข้อผิดพลาดที่เจอบ่อยคือเทสต์ที่ agent เขียนไป mock โมดูลที่คอมโพเนนต์ไม่ได้ import เลย ทำให้เทสต์ผ่านและ coverage เพิ่มขึ้น แต่ mock ทั้งหมดไม่มีประโยชน์ต่อการจับบั๊กจริง ในอีกมุมหนึ่ง AI agent อาจเลือก API ผิดหรือมองข้ามคำสั่งสำคัญในเอกสาร แม้โค้ดสุดท้ายจะทำงานได้ แต่ก็ไม่ได้ใช้เครื่องมือที่ทีมตั้งใจให้ใช้ ตรงนี้เองที่ deterministic analysis และ code quality gates ใน CI จะช่วยกรองเคสที่ดูเหมือนดีแต่คุณภาพต่ำออกไปก่อนถึง production
เมื่อคุณผูก workflow เหล่านี้เข้าด้วยกัน ทั้งการวิเคราะห์เชิงกำหนด code quality gates SonarQube MCP Server และ Scope คุณจะได้กรอบทำงานที่ให้ AI coding agent ช่วยเพิ่มความเร็ว โดยไม่ลดมาตรฐานคุณภาพลง สรุปคือมันคุ้มค่าถ้าคุณยอมลงทุนตั้งเกณฑ์กลางให้ชัด แยกบทบาทสร้างกับตรวจ และไม่ปล่อยให้ agent เป็นผู้ตัดสินงานของตัวเองเพียงฝ่ายเดียว