
AI โครงสร้างพื้นฐานข้อมูล คืออะไร และทำไม 38% จึงน่ากังวล
AI โครงสร้างพื้นฐานข้อมูล คือแนวทางออกแบบและลงทุนในระบบจัดเก็บ บริหาร และเข้าถึงข้อมูลเพื่อรองรับเวิร์กโหลดปัญญาประดิษฐ์ที่สร้างและใช้ข้อมูลจำนวนมากต่อเนื่อง รวมถึงการรองรับการเติบโตของข้อมูลในอนาคต การเข้าถึงข้อมูลย้อนหลัง การแยกชั้นจัดเก็บตามความถี่การใช้งาน และการควบคุมต้นทุนตลอดอายุข้อมูล โดยต้องทำงานสอดประสานกับทรัพยากรประมวลผลและดาต้าเซ็นเตอร์อย่างมีประสิทธิภาพ
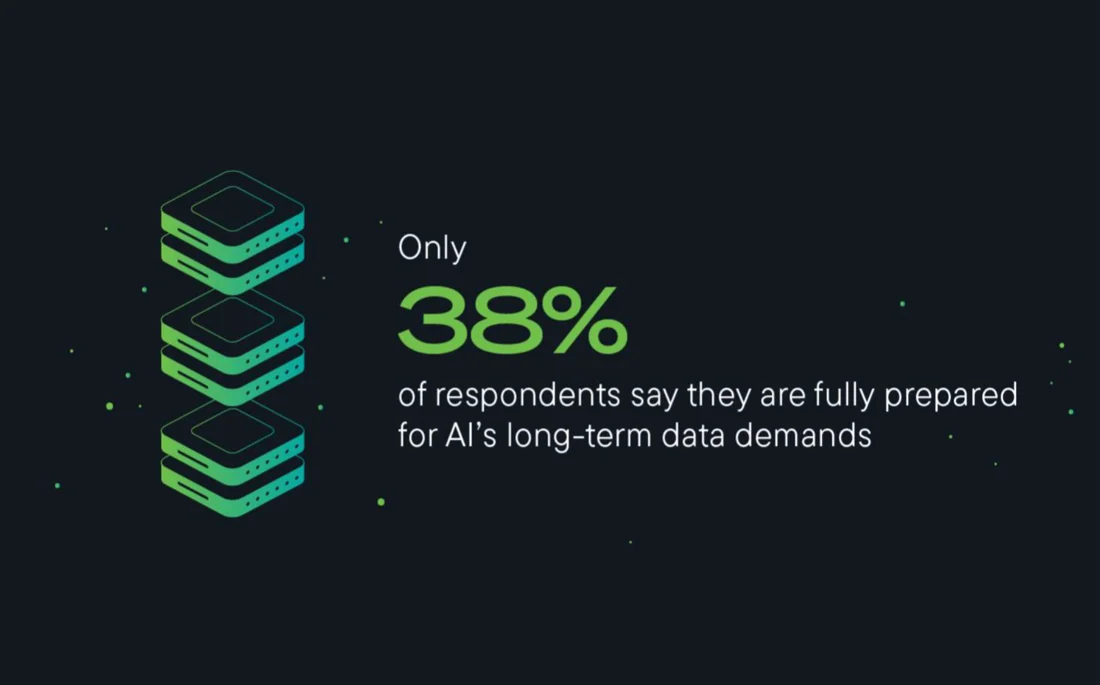
ประเด็นที่น่าตกใจคือ ผู้บริหารด้านไอทีเกือบทั้งหมด 99% เชื่อว่า AI จะเร่งความต้องการด้านการจัดเก็บข้อมูลในสามปีข้างหน้า แต่มีเพียง 38% เท่านั้นที่มั่นใจว่าโครงสร้างพื้นฐานข้อมูลขององค์กรตนพร้อมรองรับ ตัวเลขนี้สะท้อนช่องว่างขนาดใหญ่ระหว่างความคาดหวังต่อ AI กับความเป็นจริงด้านโครงสร้างพื้นฐาน ขณะเดียวกันงานวิจัยอีกชุดหนึ่งแสดงให้เห็นว่าองค์กรส่วนใหญ่กำลังเผชิญวงจรข้อมูลที่เติบโตเร็วขึ้นต่อเนื่อง ทั้งจากข้อมูลที่ AI ใช้และข้อมูลใหม่ที่ AI สร้างขึ้นเอง หากยังคิดว่า AI คือเรื่องของ Compute เป็นหลักโดยไม่ย้ายมายืนบนฐานข้อมูล องค์กรจะใช้ AI ได้ไม่เต็มศักยภาพและเสี่ยงติดล็อกทั้งด้านประสิทธิภาพและต้นทุน
ความเร็วการเติบโตข้อมูล: จากคลื่นลูกใหญ่สู่สึนามิข้อมูล
ตัวเลขจากงานวิจัยที่สนับสนุนโดย WD ชี้ว่า AI กำลังเร่งความเร็วการเติบโตข้อมูลในแบบทบต้น มากกว่าเป็นเพียงการเพิ่มขึ้นตามเส้นตรง 7% ขององค์กรมีการจัดเก็บข้อมูลเพิ่มขึ้นในรอบ 12 เดือนที่ผ่านมาโดยตรงจากการนำ AI และ Generative AI มาใช้ ขณะที่ 61% เห็นปริมาณข้อมูลโต 25% หรือมากกว่านับจากปีที่ผ่านมา และ 74% คาดว่าปริมาณข้อมูลจะเพิ่มขึ้นอย่างน้อย 25% ภายในสามปีข้างหน้า ตัวเลขเหล่านี้บอกชัดว่าองค์กรทั่วไปไม่ได้แค่มีข้อมูลมากขึ้น แต่กำลังถูกคลื่นข้อมูลซัดซ้ำปีแล้วปีเล่า
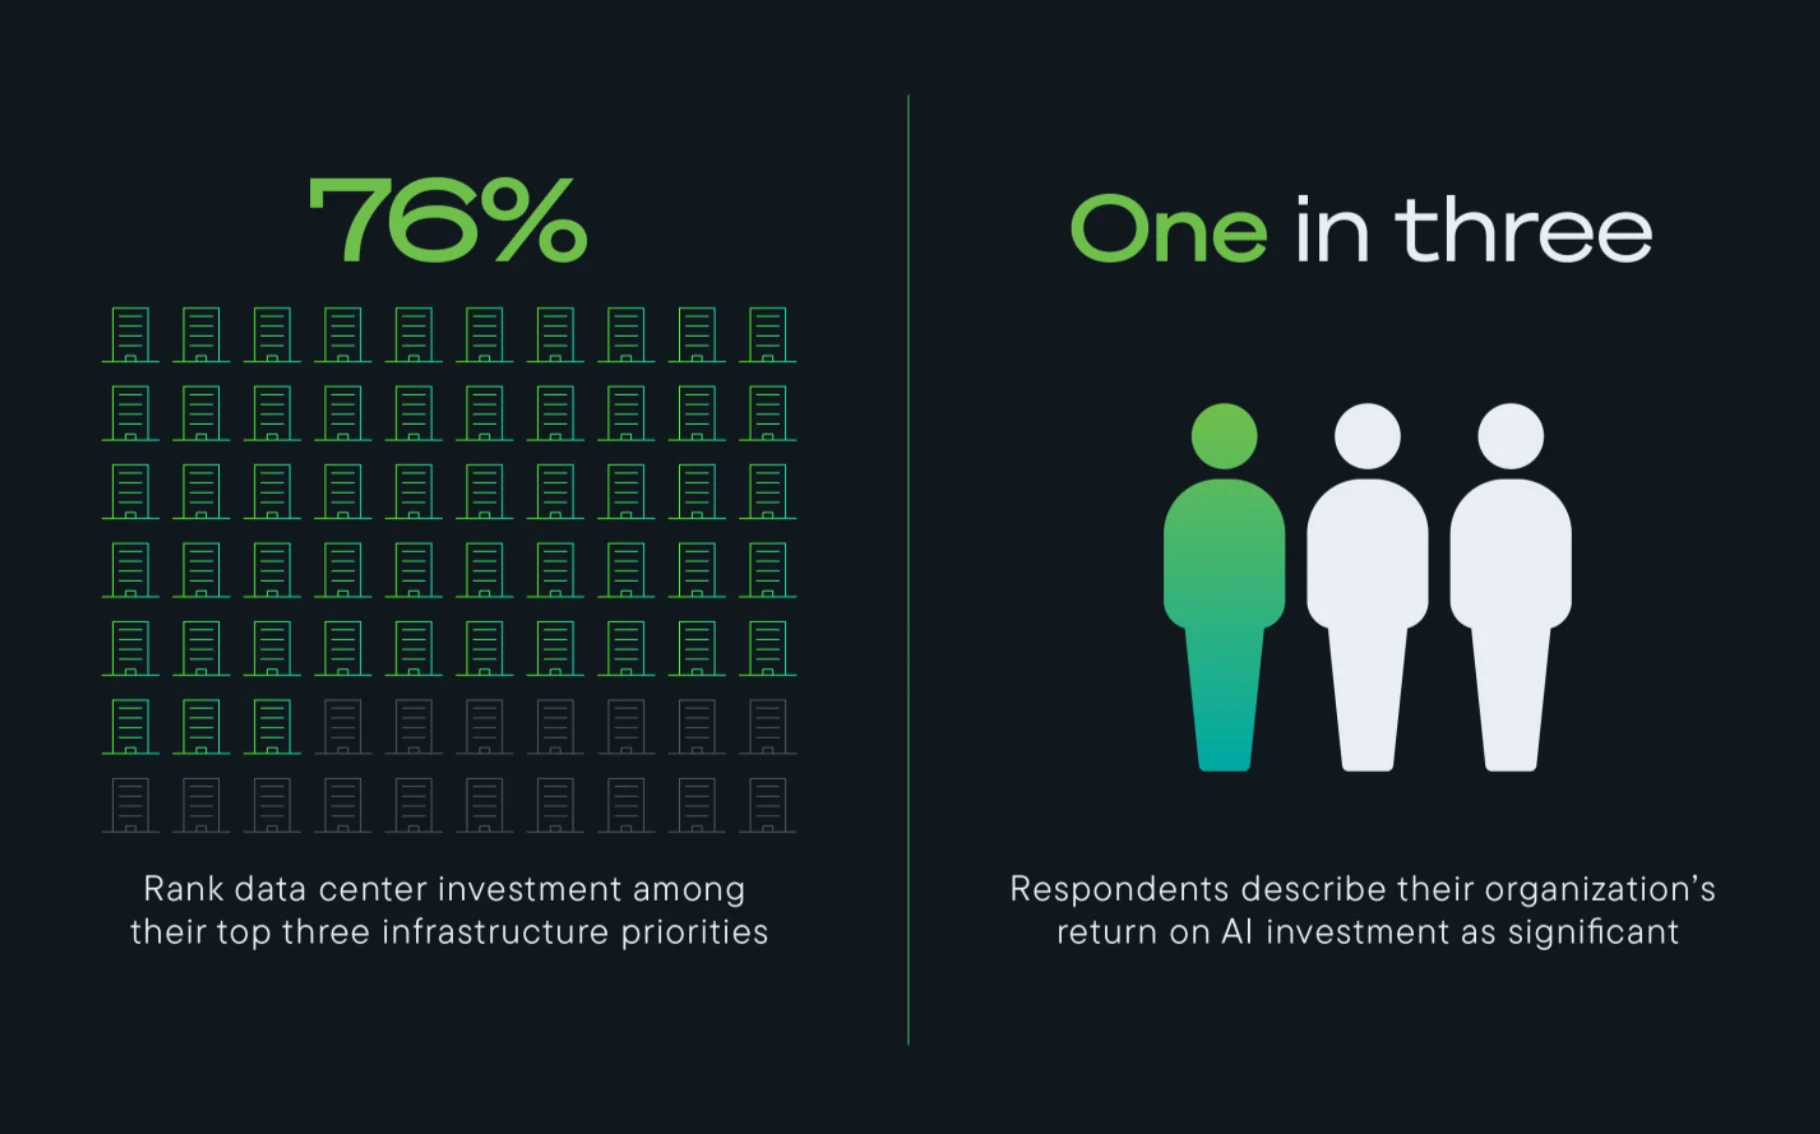
ในเวลาเดียวกัน รายงาน Data Infrastructure Readiness พบว่าเกือบ 9 ใน 10 องค์กร 86% ระบุว่าได้ ROI จากการลงทุนด้าน AI ในระดับปานกลางถึงสูง โดยหนึ่งในสามสามารถวัดผลตอบแทนได้ชัดเจน นี่คือความย้อนแย้งสำคัญ ยิ่ง AI ให้ผลตอบแทน องค์กรก็ยิ่งเพิ่มการใช้งาน AI ส่งผลให้ข้อมูลไหลเข้าระบบมากขึ้น แต่โครงสร้างพื้นฐานด้านการจัดเก็บกลับตามไม่ทัน ความท้าทายจึงไม่ใช่เพียงการขยายความจุ แต่คือการออกแบบ AI โครงสร้างพื้นฐานข้อมูล ให้รองรับการเติบโตแบบทบต้นตั้งแต่แรก ไม่เช่นนั้นทุกก้าวที่เดินหน้า AI จะเพิ่มหนี้ทางเทคโนโลยีและต้นทุนแฝงในอนาคต
เมื่อ Compute ไม่พออีกต่อไป: การเลื่อนศูนย์กลางจากซีพียูสู่ข้อมูล
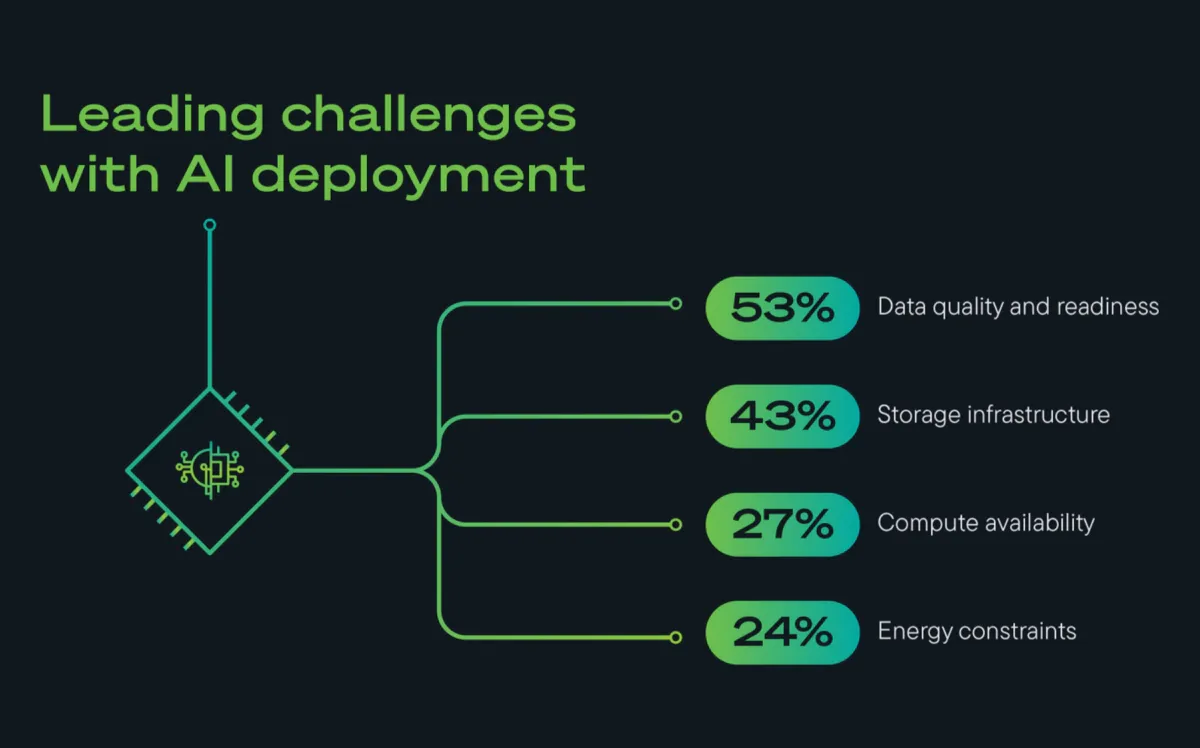
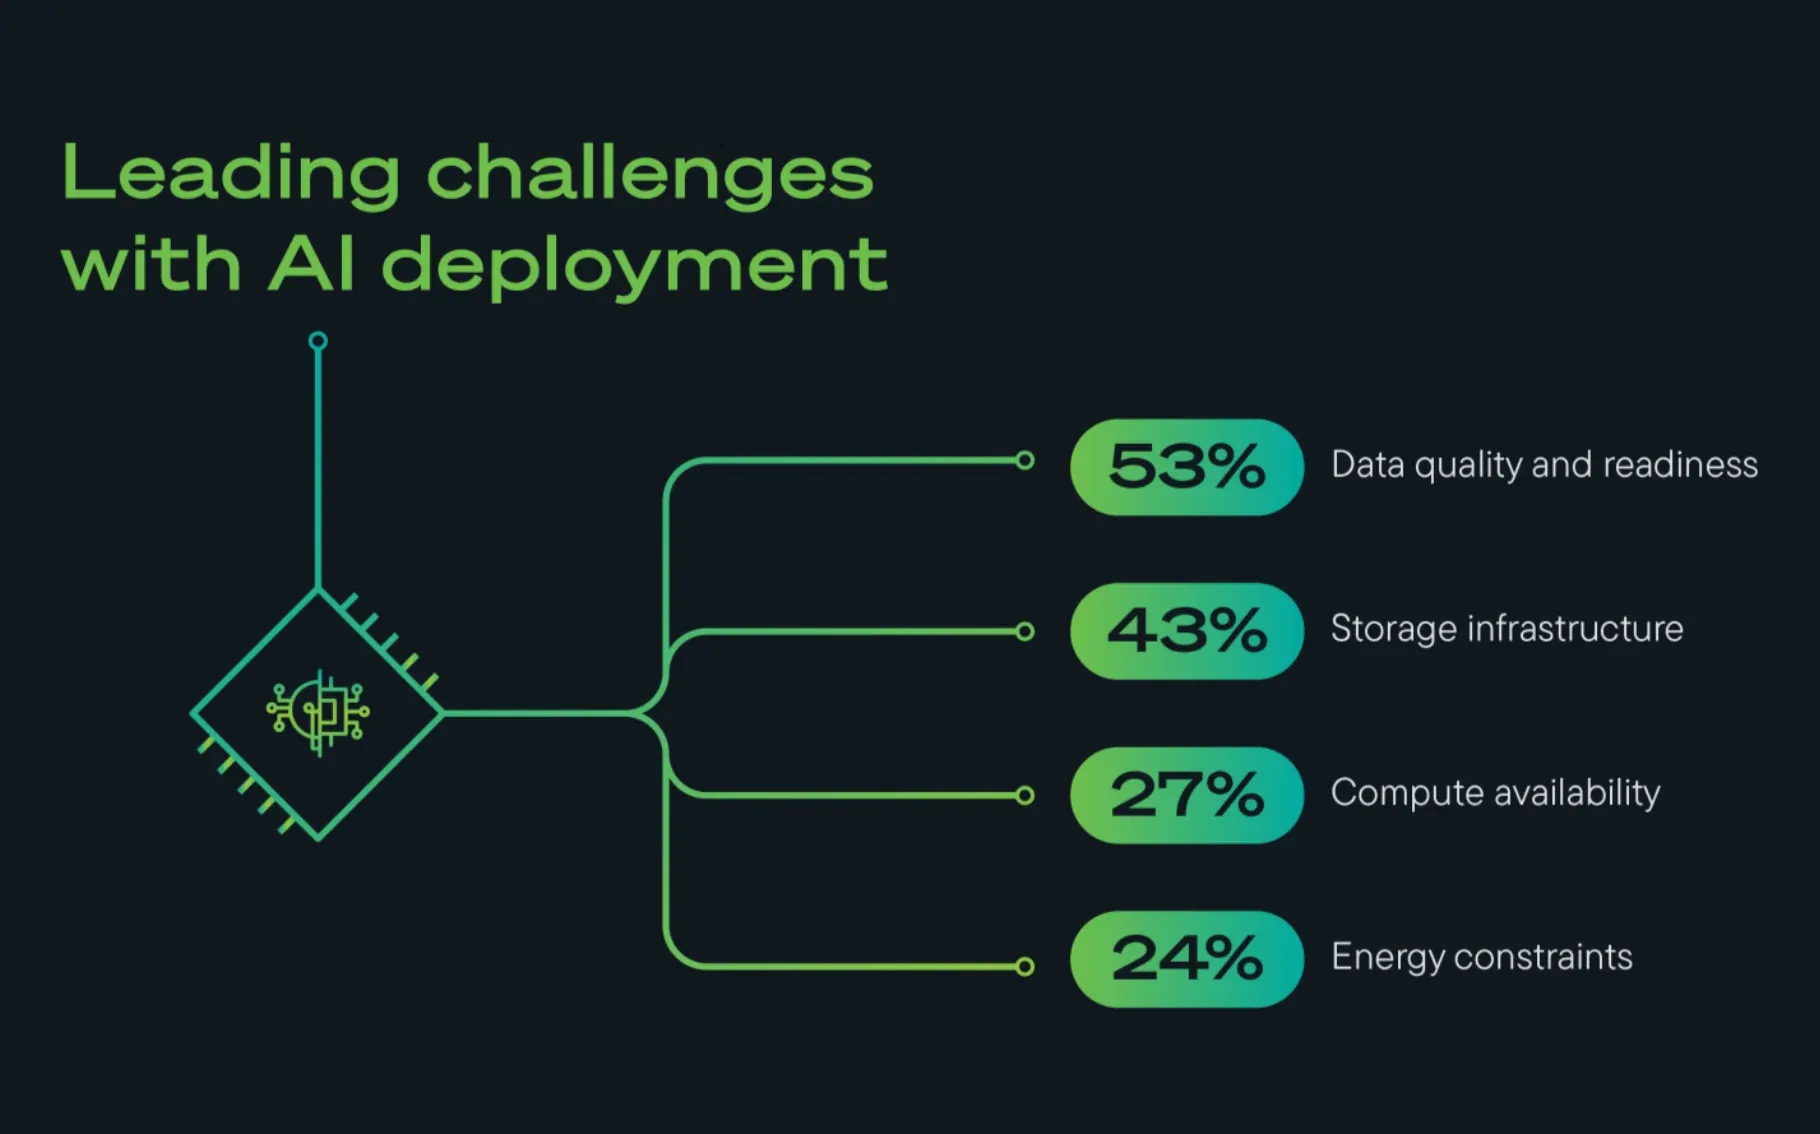
หลายปีที่ผ่านมา การพูดถึงโครงสร้างพื้นฐาน AI มักเริ่มที่ GPU ซีพียู และกลไกประมวลผลเป็นหลัก แต่ผลวิจัยใหม่กำลังเปลี่ยนมุมมองนี้ รายงาน Data Infrastructure Readiness ระบุว่า คุณภาพและความพร้อมของข้อมูล 52% รวมถึงโครงสร้างพื้นฐานด้านการจัดเก็บข้อมูล 43% คือความท้าทายหลักในการขยายการใช้งาน AI ในองค์กร สูงกว่าข้อจำกัดด้านทรัพยากรประมวลผลที่ 27% และข้อจำกัดด้านพลังงานที่ 24% อย่างชัดเจน นี่คือสัญญาณว่าคอขวดที่แท้จริงกำลังย้ายจาก Compute มาที่ข้อมูล
งานวิจัยของ IDC เสริมภาพเดียวกัน โดยชี้ว่า AI กำลังสร้างวงจรข้อมูลที่เติบโตอย่างต่อเนื่อง ข้อมูลไม่ได้หายไปหลังจากจบการประมวลผล แต่ยังถูกจัดเก็บ สะสม และนำกลับมาใช้งานเพิ่มขึ้นเรื่อย ๆ นั่นทำให้การจัดชั้นข้อมูลแบบ Warm Cool Cold การวาง Data Lake และการคุมต้นทุนต่อเทราไบต์กลายเป็นงานเชิงกลยุทธ์ ไม่ใช่แค่การจัดเก็บเชิงปฏิบัติการอีกต่อไป องค์กรที่ยังมอง AI เป็นโครงการด้าน Compute จะเผชิญปัญหา 94% ขององค์กรที่กำลังเหนื่อยกับการจัดการปริมาณข้อมูลที่พุ่งสูง เพราะขาดมุมมองโครงสร้างพื้นฐานข้อมูลแบบองค์รวม
ข้อมูลไม่เคยตาย: การเก็บระยะยาวกับเศรษฐศาสตร์โครงสร้างพื้นฐานใหม่
โลกแบบเก่ามองข้อมูลเก่าเป็นภาระ แต่โลก AI มองข้อมูลเก่าเป็นสินทรัพย์ระยะยาว งานวิจัยที่สนับสนุนโดย WD พบว่าเกือบ 95% ขององค์กรเห็นว่ามูลค่าข้อมูลเพิ่มขึ้นเมื่อใช้ AI และ Generative AI มากขึ้น 83% ระบุว่าการใช้ AI ทำให้องค์กรเก็บข้อมูลนานขึ้น และ 79% นำข้อมูล Cold-tier ที่เคยเก็บระยะยาวและไม่ค่อยถูกเรียกใช้กลับมาออนไลน์มากขึ้นเพื่อรองรับการใช้งาน AI ข้อมูลประวัติศาสตร์และชุดข้อมูลมรดกจึงกลายเป็นวัตถุดิบสำคัญสำหรับการฝึก ฝึกซ้ำ และปรับแต่งโมเดล
ความต้องการนี้ยิ่งชัดเมื่อดูตัวเลข 96% ขององค์กรคาดว่าจะต้องเรียกคืนข้อมูลจากระบบจัดเก็บถาวรได้เร็วขึ้น เพื่อรองรับ AI Inference และรูปแบบการใช้งานแบบ Retrieval-Augmented Generation หรือ RAG นั่นหมายถึงสถาปัตยกรรมจัดเก็บที่เคยออกแบบเพื่อเก็บถูก จึงต้องถูกออกแบบใหม่ให้เก็บนาน เข้าถึงเร็ว และต่อขยายได้ ขณะเดียวกันรายงาน Data Infrastructure Readiness ชี้ว่า 98% ขององค์กรเชื่อว่า AI กำลังยกระดับระบบจัดเก็บข้อมูลให้เป็นโครงสร้างพื้นฐานเชิงกลยุทธ์สำหรับธุรกิจ เมื่อข้อมูลไม่เคยตาย เศรษฐศาสตร์โครงสร้างพื้นฐานจึงเปลี่ยนจากการลดต้นทุนต่อหน่วย มาเป็นการจัดการอายุข้อมูลทั้งวงจรให้คุ้มค่าที่สุด
จากโครงสร้างพื้นฐานแพงเกินจำเป็นสู่ Sustainable Scaling ที่เน้นข้อมูล
โจทย์สำคัญตอนนี้ไม่ใช่จะลงทุนใน AI หรือไม่ แต่คือจะลงทุนอย่างไรให้ไม่ติดกับดักต้นทุนในระยะยาว รายงาน Data Infrastructure Readiness เสนอแนวคิด Sustainable Scaling หรือการเติบโตอย่างยั่งยืน หมายถึงการวางโครงสร้างพื้นฐานให้รองรับการเติบโตของ AI และข้อมูลไปพร้อมกับการเพิ่มประสิทธิภาพและความยั่งยืนในการใช้ทรัพยากร นั่นคือการยอมรับว่า AI โครงสร้างพื้นฐานข้อมูล ไม่ได้เป็นเพียงชั้นรองรับ Compute แต่เป็นฐานยุทธศาสตร์ที่กำหนดความสามารถในการแข่งขันในระยะยาว
ในทางปฏิบัติ นี่แปลว่าองค์กรต้องออกแบบนโยบายการจัดเก็บข้อมูล AI ตั้งแต่ต้นทาง ตั้งแต่การคัดเลือกข้อมูล การกำกับคุณภาพ การแยกชั้น Warm Cool Cold การวาง Data Lake ให้รองรับข้อมูลจาก AI ทั้งข้อมูลสังเคราะห์ ผลลัพธ์จากการประมวลผล และบันทึกการทำงานของโมเดลที่กำลังดันให้ปริมาณข้อมูลใน Data Lake โตขึ้นอย่างมาก ควบคู่กับการวางแผนลงทุนดาต้าเซ็นเตอร์ซึ่งกว่า 76% ขององค์กรจัดให้เป็นหนึ่งในสามลำดับความสำคัญสูงสุดด้านโครงสร้างพื้นฐาน บทสรุปคือ หากไม่ย้ายจากแนวคิด “ซื้อ Compute แล้วค่อยคิดเรื่องข้อมูลทีหลัง” ไปสู่ “วางยุทธศาสตร์ข้อมูลแล้วขยาย AI ทับลงไป” ตัวเลข 38% ที่พร้อมวันนี้อาจจะยืดเยื้อ และส่วนแบ่งความสำเร็จของ AI จะตกอยู่ในมือองค์กรกลุ่มเล็กเท่านั้น