
AI agent security คืออะไร และทำไมการให้สิทธิ์เกินจำเป็นจึงอันตรายกว่าที่คิด
AI agent security คือแนวทางออกแบบและควบคุมสิทธิ์ของระบบ AI ที่เรียกใช้โค้ด เครื่องมือ และ API ให้มีขอบเขตแคบที่สุดเท่าที่งานต้องการ เพื่อป้องกันการบุกรุกที่หลบเลี่ยงการตรวจสอบแบบเดิม การเบี่ยงเบนสถาปัตยกรรมระบบโดยไม่รู้ตัว และการกระทำอัตโนมัติที่ไม่มีใครสั่งแต่เกิดขึ้นเพราะโมเดลเชื่อข้อความในบริบทมากเกินไป การรักษาความปลอดภัยของ AI agent จึงต้องมองทั้งสิทธิ์เข้าถึงทรัพยากร บริบทของโค้ดเบสที่มันทำงานด้วย และหลักฐานการทำงานที่สามารถทำซ้ำ ตรวจทาน และทดสอบได้
ปัญหาใหญ่ไม่ใช่แค่โมเดลอาจตอบผิด แต่คือทีมมักต่อ AI agent ตรงเข้าระบบโปรดักชันด้วยคีย์แอดมิน เพราะการกำหนดขอบเขตเครื่องมือรายคำสั่งดูเหมือนงานจุกจิกที่ไว้ทำทีหลัง เมื่อเวลาผ่านไป คำสั่งจากเว็บเพจที่ดึงมา สกิลที่มีเจตนาร้าย หรือ dependency ที่ถูกวางยา สามารถแทรกคำสั่งเข้าไปในบริบท แล้ว agent ก็ทำตามด้วยทุกสิทธิ์ที่เราเคยให้มัน ไม่มีใครเห็น เพราะไม่มีระบบเฝ้าดูว่ามันใช้สิทธิ์เหล่านั้นทำอะไรเลย นี่คือช่องโหว่เงียบที่ผ่านการรีวิวสิทธิ์แบบเดิมอย่างหมดจด แต่เปิดทางให้การบุกรุกในระดับที่ทีมยังไม่เคยออกแบบให้รับมือ
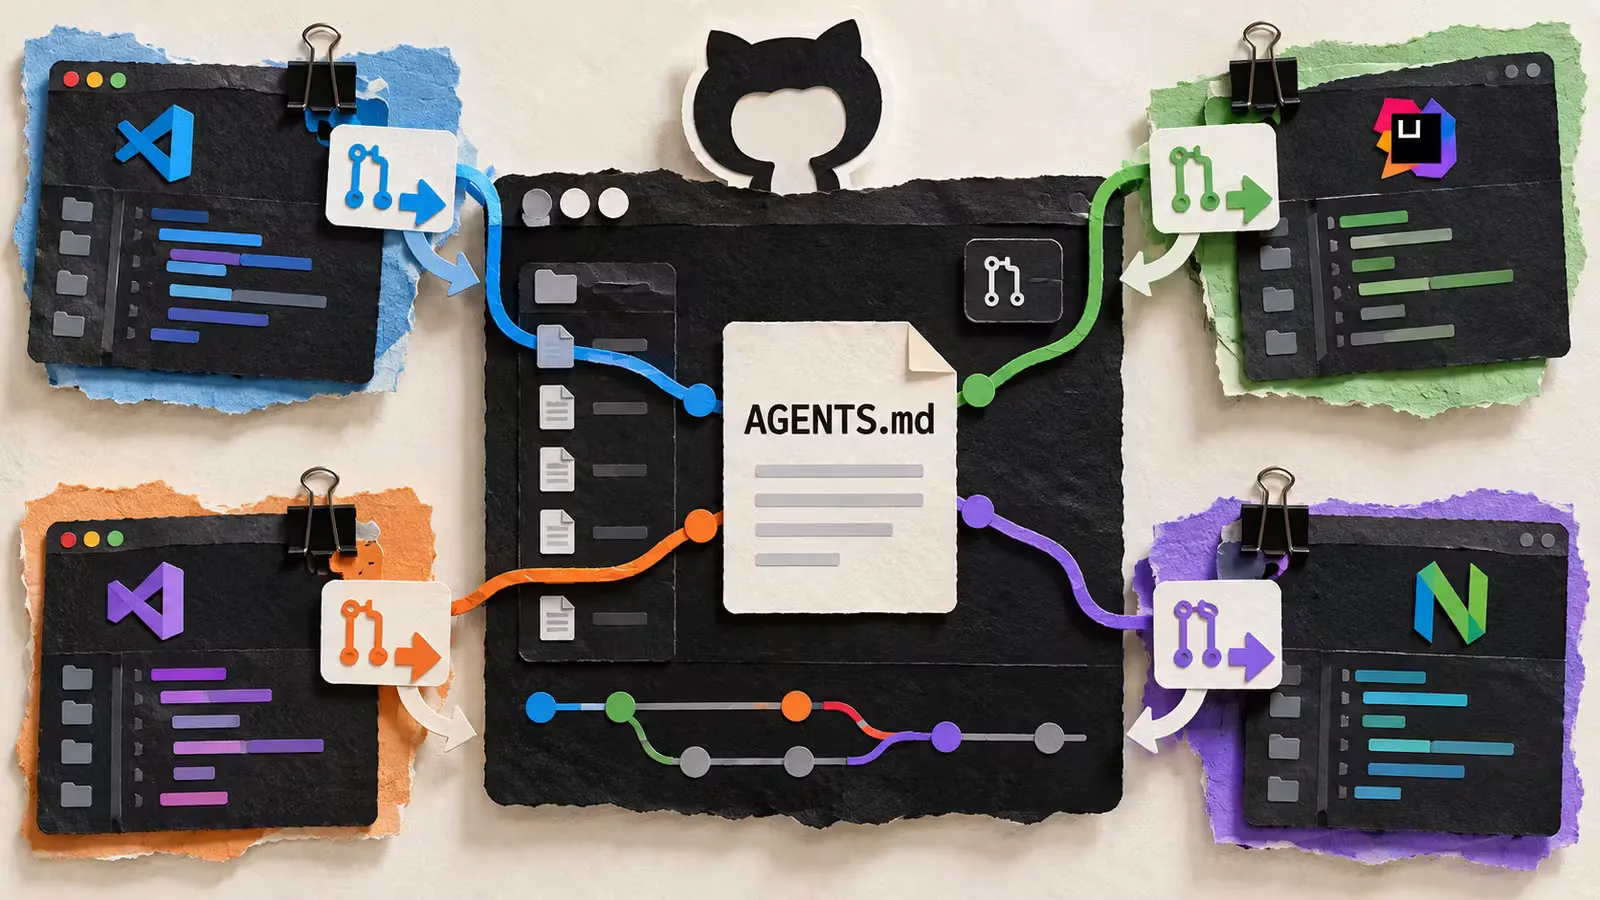
codebase context awareness ลด drift ลดโค้ดสกปรก และลดดอกเบี้ยเทคนิคอลเดต
AI coding agent ที่ทำงานในรีโพของคุณไม่เคยเห็นสถาปัตยกรรมจริงของระบบ ไม่เคยอ่านขอบเขตโมดูลที่ทีมตั้งใจ ไม่รู้คอนเวนชันที่ตกลงกัน หรือบทเรียนจากอินซิเดนต์ที่ทำให้ทีมแบนบางแพตเทิร์น ผลลัพธ์จึงเป็นโค้ดที่คอมไพล์ผ่าน อ่านผ่านตา แต่ค่อยๆ ลื่นไหลออกจากโครงสร้างที่ระบบควรจะเป็น ช่องว่างระหว่างโค้ดที่รันได้กับโค้ดที่เข้ากับระบบจริงไม่ใช่เรื่องรสนิยม แต่มันสร้างต้นทุนสะสมที่หนักขึ้นเรื่อยๆ เมื่อทุกการรันของ agent ต้องอ่านโค้ดที่เริ่มสกปรกและซ้ำซ้อนมากขึ้น
คำตอบไม่ได้อยู่ที่การเขียนพรอมป์ให้ยาวขึ้น แต่คือการยอมรับว่าตัว agent กำลังเดาโครงสร้างระบบเพราะไม่มีใครบอกความจริงให้มันรู้ จุดที่ทีมส่วนใหญ่ข้ามคือเฟส Guide ซึ่งหมายถึงการฉีดบริบทเฉพาะโปรเจ็กต์เข้าไปก่อนให้ agent สร้างโค้ด เพื่อให้โค้ดที่ออกมาไม่ใช่โค้ดกลางๆ จากสถิติ แต่ยึดมาตรฐานของรีโพจริง หรือในคำอธิบายที่คมมากคือ “ให้บริบทและข้อจำกัดจริงก่อน ให้มี drift น้อยลงตั้งแต่ต้น” หากละเลย ส่วนต่างนี้จะทบต้นทุกวัน และคุณกำลังจ่ายดอกเบี้ยบนโค้ดที่ agent เคยเขียนมากขึ้นเรื่อยๆ
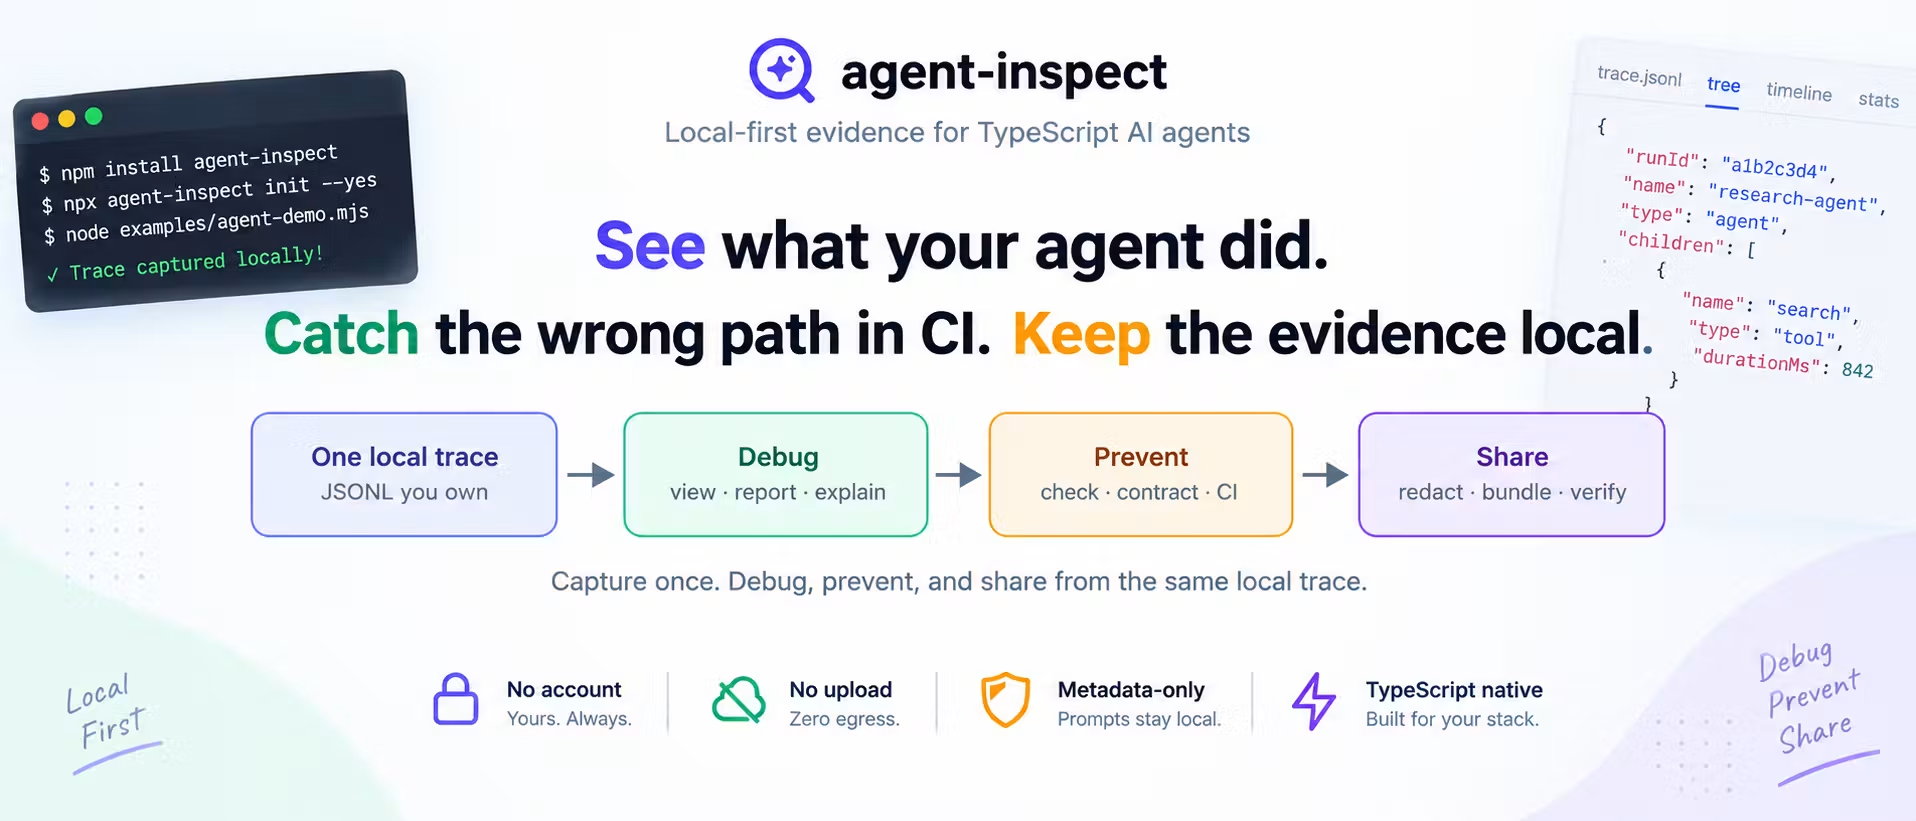
reproducible AI execution หลักฐานที่เล่าทุกก้าวของ agent ไม่ใช่แค่คำตอบสุดท้าย
ทีมส่วนใหญ่ทดสอบ AI agent ด้วยสายตาที่เน้นคำตอบสุดท้าย ถ้าข้อความดูดี อ้างอิงถูก และผ่าน assertion ง่ายๆ ก็ถือว่ารันนั้นโอเค แต่กรณีที่อันตรายที่สุดคือการรันที่ดูเหมือนสำเร็จแต่ขั้นตอนภายในผิดหมด เช่นการสร้างคำตอบก่อนดึง policy การเรียก tool ซ้ำ หรือไปใช้เครื่องมือผิดจนล้มเหลว แล้วก็ยังส่งข้อความที่ดูน่าเชื่อถือออกมาได้ จึงต้องยกมาตรฐานให้การรันของ agent กลายเป็น artifact วิศวกรรมที่ทำซ้ำได้ ตรวจทานได้ และทดสอบได้อย่างเป็นระบบ ไม่ใช่เพียงชุดลอกราบเดียว
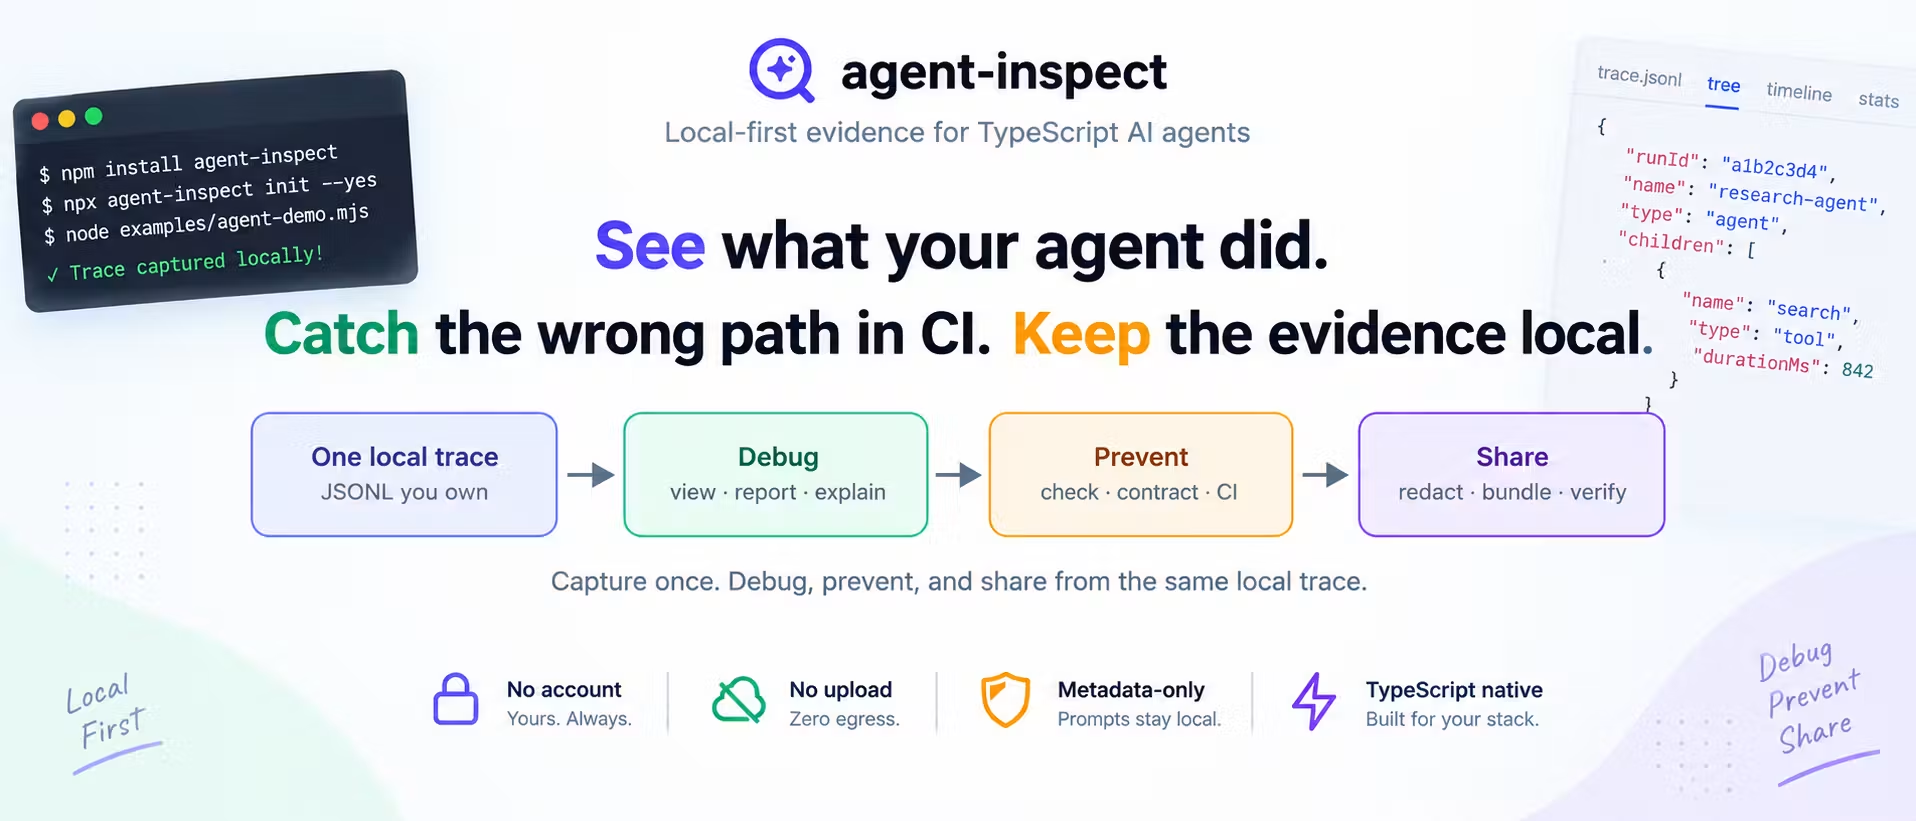
artifact ที่ดีเริ่มจากการแคปเจอร์ trace แบบโลคัล แล้วแปลงเป็น execution tree ที่เห็นลำดับและความสัมพันธ์ของแต่ละก้าว จากนั้นตรวจ trajectory ด้วยกฎเชิงดีเทอร์มินิสติก สร้าง Evidence bundle ที่ผ่านการ share-check แล้วตรวจสอบแบบออฟไลน์ มีการไลฟ์ไซเคิลตั้งแต่ capture → normalize → inspect → check → redact → package → verify → attach เข้ากับงานที่รีวิวอยู่ CI ไม่ควรถามโมเดลอีกตัวว่ารันนี้โอเคหรือไม่ แต่ควรถามคำถามเชิงวัตถุประสงค์จากหลักฐานที่แน่นอนแทน หากไม่มีระดับนี้ของหลักฐาน คุณไม่มีทางรู้เลยว่า agent เดินตามเส้นทางที่ระบบออกแบบไว้หรือหลุดไปทำอะไรบางอย่างนอกสคริปต์ระหว่างทาง
เข้มกับ code access control และ AI intrusion detection ก่อนให้ agent แตะโปรดักชัน
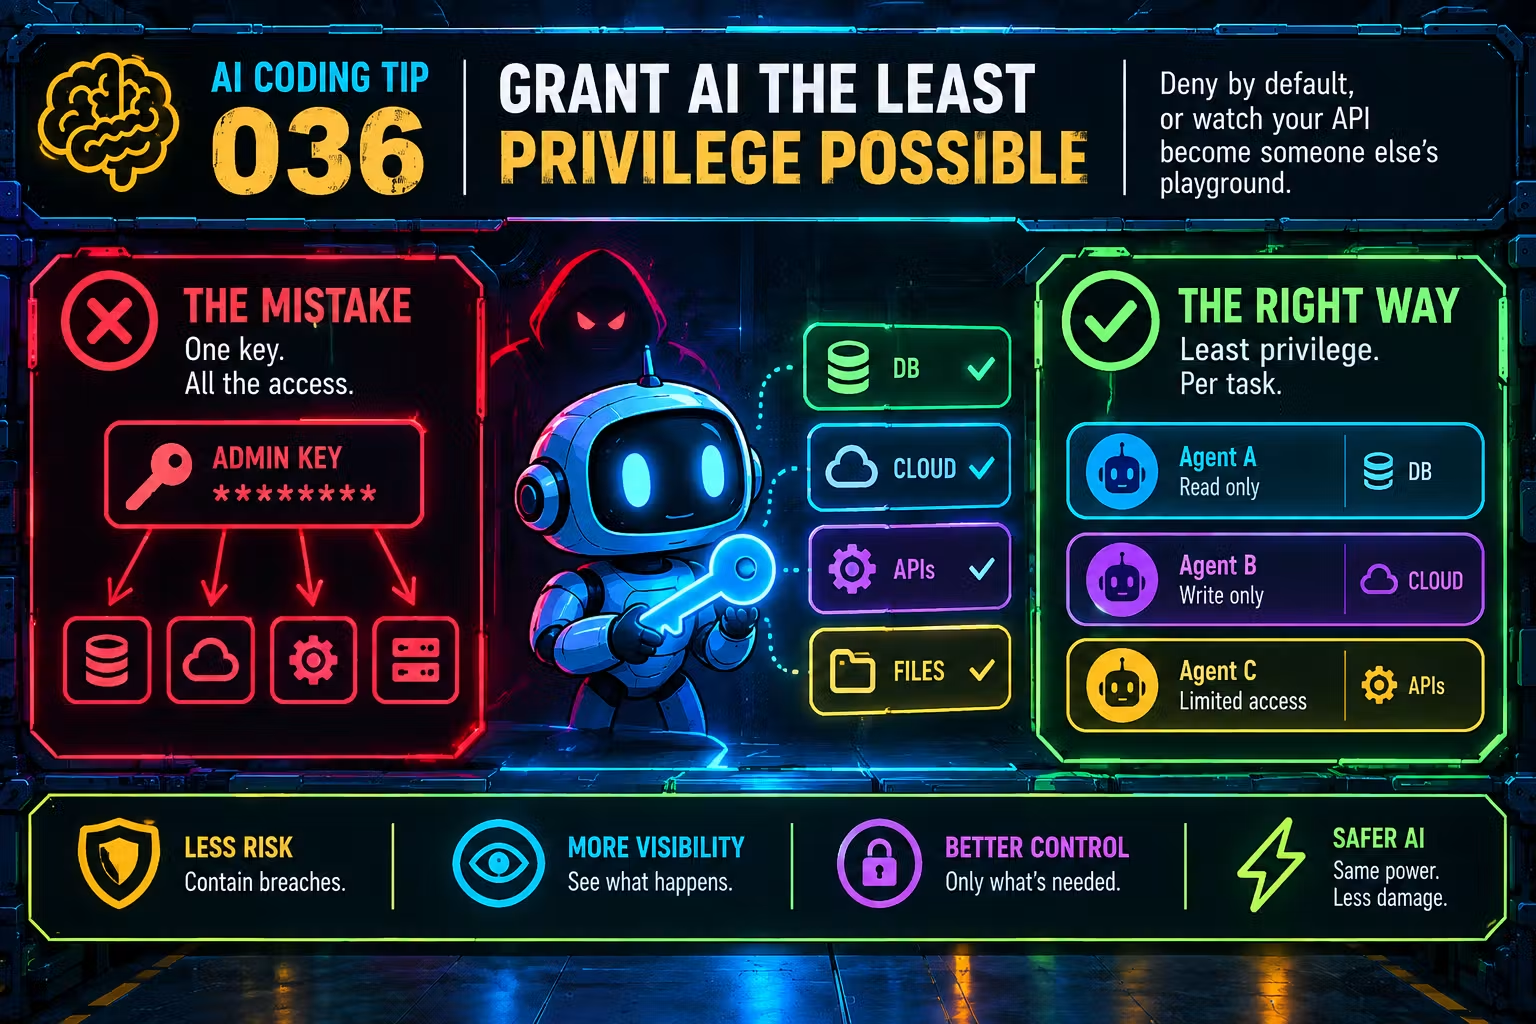
แนวคิด deny by default เป็นเส้นแบ่งชัดเจนระหว่างทีมที่ API กลายเป็นสนามเด็กเล่นของคนอื่น กับทีมที่เห็นทุกการเคลื่อนไหวของ agent ตั้งแต่วันแรก “ให้ทุก AI agent เฉพาะสิทธิ์ที่งานต้องใช้ และเฝ้าดูการบุกรุกที่ไม่มีใครอนุญาต” ไม่ใช่คำแนะนำแบบนุ่มนวล แต่มาจากประสบการณ์ตรงเมื่อ prompt injection ฝังคำสั่งในคอนเทนต์ที่โมเดลถูกขอให้สรุป แปล หรือรีวิว แล้ว agent ที่มีสิทธิ์เครื่องมือกว้างเกินไปก็ทำตามคำสั่งเหล่านั้นก่อนใครจะได้อ่านผลลัพธ์ หากไม่มี intrusion detection การรันที่ถูกยึดอาจทำงานไปหลายสัปดาห์ ผ่านการส่งออกข้อมูลกลางดึก สนใจตาราง users ผิดปกติ โดยไม่มีใครสังเกต
วิธีรับมือเริ่มจากการให้สิทธิ์แบบแคบที่สุดแก่แต่ละ agent สกิล หรือ MCP connector เฉพาะ scope ที่งานต้องใช้ ไม่ใช่ scope ที่ดูสะดวกสำหรับทุกงานในอนาคต แยกคีย์ต่อ agent ต่อทาสก์ เพื่อให้คีย์ที่รั่วหรือถูกฮิจแฮกเปิดทางได้แค่ความสามารถแคบ ไม่ใช่ทั้ง backend เหมือนกรณีคีย์ OAuth ที่ถูกใช้เป็นทางผ่านเข้าไปยัง environment variables ภายในของผู้ให้บริการโฮสติ้งรายหนึ่งในเดือนเมษายน ฐานข้อมูลที่ใช้คีย์เดียวอ่าน เขียน ลบ และ drop ตาราง แล้วให้ agent สิบกว่าตัวแชร์คีย์เดียวกันอาจดูมีประสิทธิภาพ แต่ในมุมความปลอดภัย มันคือจุดล้มเหลวเดียวของทั้งบริษัท
ด้านการเฝ้าระวัง ให้ล็อกทุกการเรียกเครื่องมือของ agent พร้อมรายละเอียดพอที่แพตเทิร์นแปลกๆ จะโดดเด่น เช่นยอดอ่านพุ่งสูงกว่าปกติ หรือการเขียนข้อมูลที่ไม่มีใครรีเควสต์ ตั้ง alert อัตโนมัติเมื่อมีความผิดปกติอย่างจำนวนคำเรียก API สูงผิดจังหวะ ล็อกอินนอกเวลา หรือการแตะตารางสำคัญครั้งแรก ส่วนโครงสร้างระบบให้แยกบริการออกเป็นชั้น สกิลเล็กแคบ ไม่ถือคีย์ดิบ agent ทำหน้าที่ orchestration และให้ MCP connector เป็นชั้นเดียวที่แตะ API จริง แต่ละ boundary ต้อง enforce ด้วยการตั้งค่าระบบ ไม่ใช่เพียง system prompt ที่โมเดลสามารถถูกโน้มน้าวให้ตีความใหม่ได้
สรุปเชิงปฏิบัติการ ทีมควรทำอะไรตอนนี้ก่อน AI agent ทำร้ายระบบเราเอง
ก่อนให้ AI agent แตะโปรดักชัน ควรคิดว่าทุกการรันคือกิจกรรมด้านความปลอดภัย ไม่ใช่แค่การช่วยลดเวลาการเขียนโค้ด ทีมต้องรู้ว่า agent ทำอะไร เดินไปตามเส้นที่ออกแบบหรือไม่ และรันที่ล้มเหลวสามารถแชร์ให้คนอื่นรีวิวโดยไม่ทำข้อมูลหลุดได้อย่างไร แนวทางที่ปลอดภัยกว่าคือแยก source trace ที่อยู่โลคัล อ่านอย่างเดียวและควบคุมการเข้าถึง ออกจาก artifact ที่ถูกสร้างขึ้นแบบ redacted มีขอบเขตชัดเจน ผ่านการประเมินตามนโยบาย มี manifest บอกแฮช แหล่งที่มา สคีมา และการประเมิน แล้วให้มนุษย์รีวิวก่อนแชร์
- กำหนดสิทธิ์แบบ minimal ให้แต่ละ agent สกิล และ MCP connector เฉพาะ scope ที่งานต้องใช้ และรอให้มันร้องขอสิทธิ์เพิ่มก่อนค่อยรีวิว
- ใช้แนวคิด deny access by default แล้วเปิดความสามารถทีละรายการ เพื่อไม่ให้ tool ที่ไม่เคยถูกให้สิทธิ์ถูกโน้มน้าวให้โผล่มารันตอน runtime
- ทำ sandbox การรัน agent ให้ชัดเจน สร้าง local trace และ Evidence artifact ก่อนให้สิทธิ์เข้าระบบโปรดักชันจริง แยกชั้นสกิล agent และ MCP connector ตามแนวทางระบบที่ปลอดภัย
- ตั้งระบบล็อกทุกการเรียกเครื่องมือและ API จาก agent พร้อม alert แบบ anomaly สำหรับ call volume เวลาเข้าถึงผิดปกติ และการแตะตารางหรือทรัพยากรสำคัญครั้งแรก
- pentest AI pipeline แบบเดียวกับการ pentest API ทั่วไป ใส่พรอมป์มุ่งร้าย ผลตอบแทนเครื่องมือที่ผิดรูป และคำสั่งที่ถูก inject แล้วตรวจว่าขอบเขตความเสียหายอยู่ตามที่ออกแบบ ไม่ใช่ตามที่หวัง
ทีมที่ทำตามห้าข้อนี้ไม่ได้แค่ลดความเสี่ยงด้านความปลอดภัย แต่ได้ระบบที่โค้ดใหม่ไม่ drift ไปจากสถาปัตยกรรมเดิม ไม่สร้างดอกเบี้ยเทคนิคอลเดตเกินจำเป็น และพร้อมรองรับ agent รุ่นใหม่ได้อย่างมีหลักฐานรองรับทุกการรัน