
AI agent production safety คืออะไร และทำไมต้องคิดตั้งแต่วันแรก
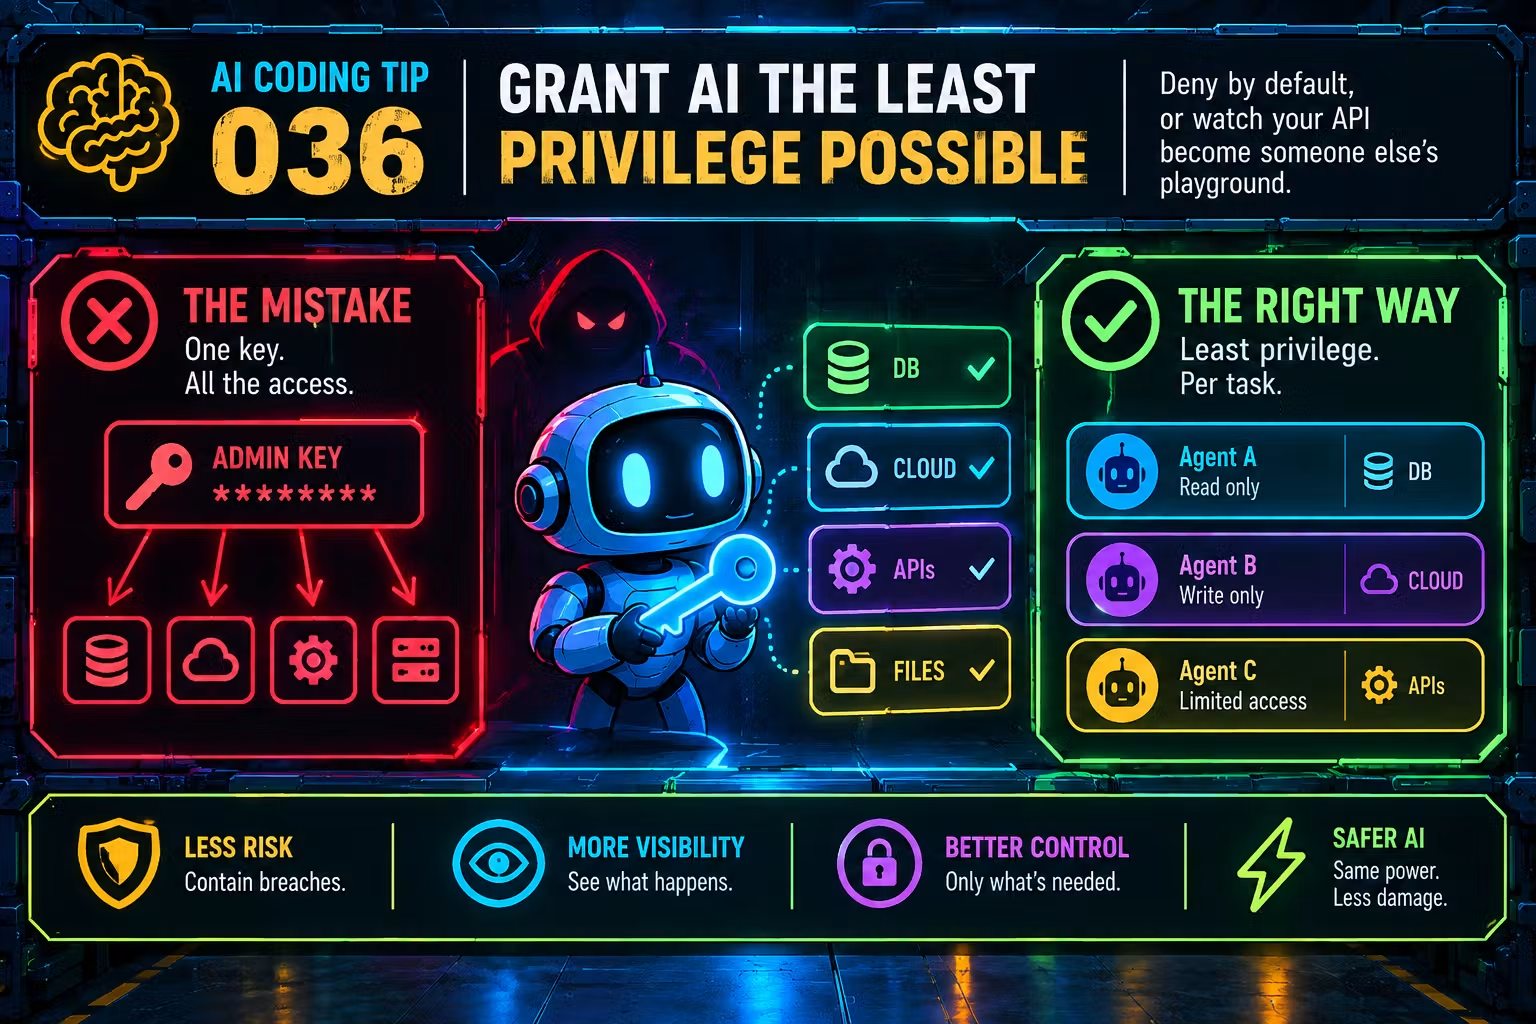
AI agent production safety คือแนวทางออกแบบและควบคุมการทำงานของเอเจนต์ในสภาพแวดล้อมโปรดักชันเพื่อให้การตัดสินใจทุกครั้งไม่สร้างผลกระทบผิดพลาดต่อโลกจริง ตั้งแต่การเรียกใช้เครื่องมือ การเขียนโค้ด ไปจนถึงการเปลี่ยนสถานะทางธุรกิจ โดยเน้นให้โมเดลเสนอการกระทำได้ แต่ระบบรันไทม์ต้องเป็นผู้ควบคุมผลลัพธ์สุดท้ายอย่างเข้มงวด เป้าหมายไม่ใช่ให้เอเจนต์ฉลาดเพียงอย่างเดียว แต่ต้องทำงานซ้ำได้ ตรวจสอบย้อนหลังได้ และไม่ทำให้ทีมวิศวกรต้องมานั่งดับไฟจากบั๊กที่มองไม่เห็นในทุกสปรินต์
เมื่อเราเริ่มใช้เอเจนต์มาช่วยเขียนโค้ดและกระทำกับระบบจริง ความเร็วในการปล่อยฟีเจอร์พุ่งสูงขึ้น แต่ก็มีภาษีแอบแฝงคือคุณภาพงานที่ผู้เชี่ยวชาญต้องมานั่งตรวจทีละบรรทัด จุดเสี่ยงใหญ่คือการปล่อยให้โมเดลส่งผลกระทบโดยตรงต่อระบบธุรกิจโดยที่รันไทม์ไม่ได้กำหนดขอบเขตหรือสัญญาให้ชัดเจน หลักคิดสำคัญคือ "โมเดลเสนอแอ็กชัน รันไทม์เป็นคนลงมือ" หากปล่อยให้โมเดลลองผิดลองถูกกับโลกจริง AI agent production safety จะกลายเป็นคำสวยหรูที่ช่วยอะไรโปรดักชันไม่ได้
| Spec | A | B |
|---|---|---|
| ขอบเขตเอเจนต์ | เสนอแอ็กชันเท่านั้น ไม่ลงมือเอง | เรียกเครื่องมือและเปลี่ยนสถานะธุรกิจโดยตรง |
| ความเสี่ยงโปรดักชัน | ตรวจสอบได้ คุมผลกระทบได้ | เสี่ยงบั๊กเงียบและผลกระทบซ้ำซ้อน |
ออกแบบ idempotent side-effect contracts ให้เอเจนต์ไม่ทำงานซ้ำซ้อน
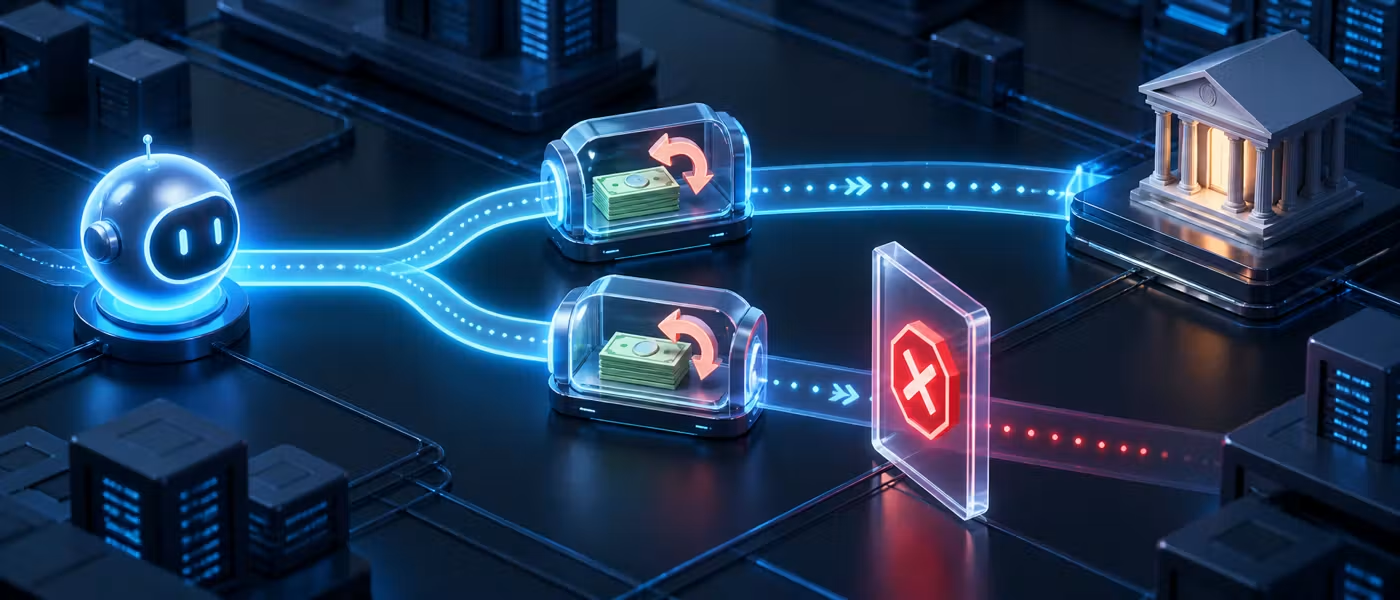
การออกแบบ idempotent side-effect contracts คือหัวใจของการทำให้เอเจนต์ปลอดภัยเมื่อมีการ timeout หรือ retry เพราะ agent runtime มักมอง error เป็นสัญญาณให้ลองใหม่ ถ้าไม่มีสัญญาที่แยกให้ชัดว่าอะไรคือผลลัพธ์ของเครื่องมือและอะไรคือผลลัพธ์ทางธุรกิจ self healing จะกลายเป็น self duplicating ทันที HTTP นิยามเมธอดที่เป็น idempotent ว่าตั้งใจให้ผลกระทบสุดท้ายเท่าเดิมแม้มีคำขอซ้ำหลายครั้ง โดยอาจยังมีผลข้างเคียงเช่นการล็อกหลายครั้งอยู่เบื้องหลัง ภาพแบบนี้ช่วยให้เราคิดโครงสัญญาเครื่องมือในเอเจนต์ได้เป็นระบบ
แนวทางที่มีเหตุผลคือทำให้พฤติกรรม retry ฝังอยู่ในนิยามของเครื่องมือ ไม่ใช่กระจายตัวอยู่ในพรอมต์และบล็อกดักข้อผิดพลาด เราอาจจำแนก sideEffectClass เป็นสี่กลุ่ม read_only idempotent_write deduplicated_write และ non_repeatable_write เพื่อบังคับให้ทีมตอบคำถามสำคัญ เช่น เรียกซ้ำเปลี่ยนสถานะได้หรือไม่ ต้องใช้คีย์ไอดีมโพเทนซีหรือเปล่า เมื่อผลลัพธ์หายไประหว่างทางต้อง reconcile ตัวผลลัพธ์อย่างไร แนวคิดที่ว่า "Unknown Outcomes Need Reconciliation, Not Hope" สะท้อนชัดว่าเมื่อไม่รู้ว่าผลกระทบเกิดไปแล้วหรือยัง ระบบต้องหาความจริงก่อนเสมอไม่ใช่สั่งทำซ้ำแบบเดาสุ่ม
| Spec | A | B |
|---|---|---|
| คลาสผลกระทบ | read_only | non_repeatable_write |
| การ retry อัตโนมัติ | ทำได้ ปลอดภัยต่อสถานะธุรกิจ | ห้าม เว้นแต่พิสูจน์ได้ว่าคำขอแรกไม่ commit |
จับ code hallucination ก่อนเข้าที่เก็บด้วย adversarial pipeline หลายเอเจนต์
ปัญหาหนักที่สุดของการใช้เอเจนต์เขียนโค้ดคือ code hallucination ที่ดูถูกต้องทุกอย่างแต่ผิดเชิงสถาปัตยกรรมหรือสถานะภายใน ระบบอาจคอมไพล์ผ่าน ลินเตอร์ไม่เตือน แต่ใต้พื้นผิวกลับละเมิด boundary ของโมดูลหรือทำเครื่องจักรสถานะพังโดยที่ไม่มีใครเห็นทัน เมื่อทีมปล่อยให้โค้ดแบบนี้ไหลเข้ารีโปอย่างต่อเนื่อง AI agent architecture patterns ที่ประมาทจะสร้างหนี้เชิงสถาปัตยกรรมที่สะสมยากจะแก้ภายหลัง การสร้าง adversarial pipeline เป็นเกราะหน้าโปรดักชันช่วยรับบท "ศาลโค้ด" ที่บังคับให้เอเจนต์ตรวจสอบงานของตัวเองแบบมีคู่ต่อสู้ก่อนเปิด pull request
สถาปัตยกรรมหนึ่งที่ใช้งานได้จริงคือ pipeline แบบ multi agent ที่จัดบทบาทเป็น Prosecutors หรือ Finders และ Defense หรือ Refuters ฝั่ง Prosecutors ใช้เอเจนต์สแกน diff ทั้งชุดเพื่อหาบั๊กตรรกะ สถานะที่ไม่ได้ทดสอบ และการละเมิดคอนเวนชัน โดยตั้งใจให้แพ้ false positive ได้เพื่อให้จับทุกอย่างให้หมด ในทางกลับกันฝั่ง Defense พยายามหักล้างข้อกล่าวหา โค้ดที่ถูกกล่าวหาต้องผ่านการโต้แย้งแบบเป็นระบบก่อนจะถูกปล่อยออกไป เมื่อเราบังคับให้ AI ทบทวนงานของตัวเองผ่านเลนส์เชิงปฏิปักษ์เช่นนี้ เราจะหยุดกระแสหนี้สถาปัตยกรรมไม่ให้ไหลเข้าสู่รีโปโดยไม่รู้ตัว
| Spec | A | B |
|---|---|---|
| บทบาทเอเจนต์ | Prosecutors / Finders | Defense / Refuters |
| หน้าที่หลัก | จับบั๊กและการละเมิดกฎให้มากที่สุด | พิสูจน์ว่าโค้ดปลอดภัยและข้อกล่าวหาใดเกินจริง |

ใช้ AGENTS.md แบบ stack-agnostic เพื่อยึดกฎส่วนกลางและสถาปัตยกรรมให้ชัด
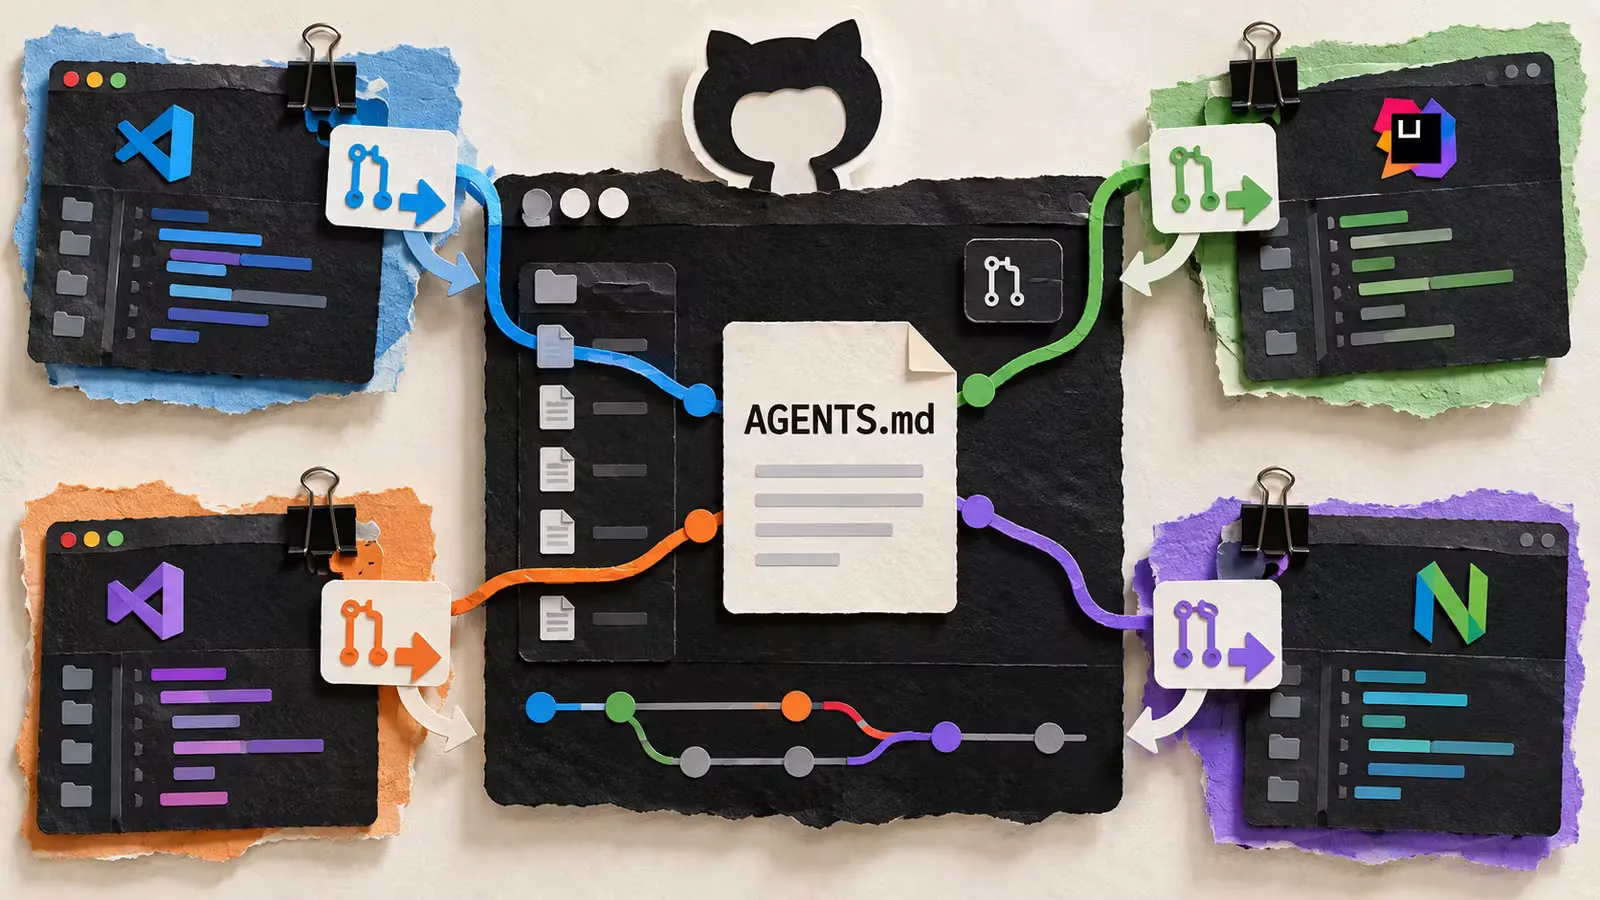
อีกแนวทางหนึ่งของ AI agent architecture patterns คือการมีแฟ้มคำสั่งส่วนกลางอย่าง AGENTS.md ที่ใช้ได้กับทุกเอเจนต์และทุกสแตก โดยผู้พัฒนาได้แยกวิเคราะห์แฟ้มคำสั่งของเอเจนต์ยอดนิยมแล้วสกัดแนวคิดที่ดีที่สุดมารวมในเวอร์ชันที่เป็น stack-agnostic จุดเด่นคือ "One core for the work every agent does" กล่าวคือมีกฎแกนกลางหนึ่งชุดสำหรับงานที่ทุกเอเจนต์ต้องทำไม่ว่าใช้เฟรมเวิร์กไหน ทั้งการทำความเข้าใจคำขอ การจำกัดขอบเขตการเปลี่ยนแปลง การจัดการข้อมูลอ่อนไหว การดีบัก และการตรวจสอบผลลัพธ์ให้มีหลักฐานชัดเจน
ไฟล์ AGENTS.md ยังทำหน้าที่เป็นรั้วความปลอดภัย เช่น บอกชัดว่าเอเจนต์ห้ามลบไฟล์ ห้าม rewrite Git history ห้าม force push หรือทำให้เช็กที่ล้มเหลวกลับผ่านด้วยการลดความเข้มของเงื่อนไขโดยไม่ได้รับคำสั่ง การกระทำที่ต้องห้ามต้องถูกบล็อกด้วยสิทธิ์ ฮุก หรือ CI เพิ่มเติมอยู่ดี ตามคำอธิบาย "These are instructions for the agent; actions that must be blocked without exception still need permissions, hooks, or CI" แนวคิดนี้สะท้อนว่าเอกสารอย่าง AGENTS.md เป็นวิธีจัดบริบทและสถาปัตยกรรมให้เอเจนต์เข้าใจ แต่การบังคับใช้จริงยังต้องพึ่งโครงสร้างรันไทม์ของทีม
| Spec | A | B |
|---|---|---|
| การใช้กฎ | AGENTS.md เดียวทุกสแตก | เขียนกฎใหม่ตามเฟรมเวิร์ก |
| ผลต่อทีมพัฒนา | แพตเทิร์นใช้ซ้ำได้ ลดสับสน | กฎกระจัดกระจาย ตรวจสอบยาก |
วางสถาปัตยกรรมและบริบทโค้ดให้แน่น เพื่อไม่ให้เอเจนต์ล้มเหลวแบบเงียบ
ในโลกที่เอเจนต์ช่วยเขียนโค้ดและส่งงานขึ้นโปรดักชัน เรากำลังปล่อยโค้ดในความเร็วที่ไม่เคยมีมาก่อน ทว่าเบื้องหลังความเร็วนี้คือภาระงานรีวิวที่ถาโถมใส่วิศวกรรุ่นใหญ่ ซึ่งต้องจัดการ pull request ที่เต็มไปด้วยงานจากเอเจนต์ที่ไม่เข้าใจสถาปัตยกรรมจริงของระบบ การออกแบบสถาปัตยกรรมเอเจนต์ให้ดีจึงไม่ใช่เรื่องหรูหรา แต่เป็นเงื่อนไขบังคับ เราต้องบังคับบริบทสถาปัตยกรรมใส่ในเอเจนต์ผ่านไฟล์อย่าง .cursorrules และ claude.md เพื่อให้เอเจนต์เห็นภาพ boundary ของโมดูลและกฎโครงสร้างตั้งแต่ก่อนเริ่มเขียนโค้ด
โค้ดที่เอเจนต์ผลิตอาจไม่ระเบิดทันทีในโปรดักชัน แต่สร้างบั๊กเงียบ เช่น state machine ที่ทำงานผิดบางกรณีหรือการข้ามเลเยอร์สถาปัตยกรรมแบบไม่ได้ตั้งใจ เพื่อหลีกเลี่ยงความล้มเหลวเงียบ เราต้องผูกสถาปัตยกรรม การกำกับบริบท และ pipeline ตรวจสอบแบบ adversarial เข้าด้วยกัน เมื่อเราบังคับให้ AI agent ทำงานภายใต้สัญญาผลกระทบที่ชัดเจน มีกฎส่วนกลางแบบ AGENTS.md และถูกตรวจสอบด้วยหลายเอเจนต์ที่โต้แย้งกันเอง หนี้สถาปัตยกรรมจะถูกหยุดไว้หน้าประตูรีโป ไม่ใช่ถูกปล่อยให้ไหลเข้าไปสะสมทีละก้อน
| Spec | A | B |
|---|---|---|
| การจัดบริบทให้เอเจนต์ | ใช้ไฟล์กฎ เช่น .cursorrules และ AGENTS.md | ปล่อยให้เอเจนต์เดาจากโค้ดที่เห็น |
| ผลลัพธ์ในโปรดักชัน | ลดบั๊กเงียบ หนี้สถาปัตยกรรมถูกควบคุม | มีบั๊กแฝงและพังเชิงสถาปัตยกรรมในระยะยาว |