
AI agent security ในสายผลิตคือเรื่องสถาปัตยกรรม ไม่ใช่แค่คุณภาพโมเดล
ความปลอดภัยของ AI agent ในสายผลิตคือแนวทางออกแบบและกำกับการทำงานของตัว agent ให้สอดคล้องกับสถาปัตยกรรม ระบบสิทธิ์ และบริบทโค้ดเบส โดยต้องทำให้การทำงานของ agent สามารถทำซ้ำ ตรวจสอบ และทดสอบได้ ลดสิทธิ์ให้เหลือเท่าที่ภารกิจต้องใช้ และป้อนบริบทโค้ดจริงเข้าไปก่อนให้มันลงมือเปลี่ยนแปลงโค้ดหรือเรียก API เพื่อป้องกันการเบี่ยงเบนสถาปัตยกรรม ความเสี่ยงด้านความปลอดภัย และการใช้ token เกินจำเป็น หัวหน้าวิศวกรรมที่คิดว่า “ปล่อย agent ทำงานได้คำตอบดูดี” เท่ากับจบงาน กำลังเปิดช่องให้ความผิดพลาดแบบเงียบเกิดขึ้นโดยไม่มีหลักฐานว่าภายใน agent ทำอะไรบ้าง การทำงานที่ดูสำเร็จอาจซ่อนการเรียกเครื่องมือผิดลำดับ การใช้ fallback ที่ไม่อนุมัติ หรือการลัดขั้นตอนออกแบบ และเมื่อ agent ได้สิทธิ์กว้างเกินไป มันจะทำตามคำสั่งที่แอบซ่อนในข้อมูลหรือเว็บเพจ โดยที่ไม่มีใครเคยอนุญาตให้ระบบนั้นถูกแตะต้องเลย
ไม่ให้บริบทโค้ดเบสกับ AI agent คือการปล่อยให้สถาปัตยกรรม drift และเพิ่มช่องโหว่
AI coding agent ที่ทำงานบนรีโพของคุณไม่เคยเห็นสถาปัตยกรรมจริงของระบบเลย มันไม่รู้ขอบเขตโมดูล มาตรฐานทีม เหตุการณ์เหตุขัดข้องในอดีต หรือเหตุผลว่าทำไมบริการหนึ่งควรเรียกอีกบริการหนึ่งแต่ไม่ใช่บริการที่สาม ผลคือมันเขียนโค้ดจากค่าเฉลี่ยเชิงสถิติของโค้ดของคนอื่น ไม่ใช่โค้ดของคุณเอง เกิดโค้ดที่คอมไพล์ผ่าน อ่านแล้วดูได้ แต่ค่อยๆ พาระบบเบี่ยงจากสถาปัตยกรรมที่ตั้งใจไว้ การทำซ้ำโค้ดโดยไม่มีบริบทที่แท้จริงคือสถาปัตยกรรม drift แบบค่อยเป็นค่อยไป และงานวิจัยเชื่อมโยง clone โค้ดที่เปลี่ยนพร้อมกันกับบั๊กที่พบได้สูงถึง 57% โดยค่ากลางอยู่ที่ 48% และบางโปรเจ็กต์สูงถึง 100% ของบั๊กเกี่ยวข้องกับ clone นี่คือต้นทุนที่สะสม ทุกโค้ดที่รกและซ้ำซ้อนที่ agent สร้างวันนี้จะเพิ่มราคาที่ต้องจ่ายทุกครั้งที่ agent หรือคนต้องอ่านโค้ดนั้นในวันหน้า วิธีที่ทีมมักทำเช่นเพิ่ม prompt หรือรีวิวโค้ดช่วยแค่บรรเทาอาการ ไม่ได้แก้สาเหตุที่ agent ขาดบริบทจริง
reproducible AI execution และหลักฐาน trajectory คือเส้นแบ่งระหว่างบั๊กทั่วไปกับเหตุผิดปกติแบบเงียบ
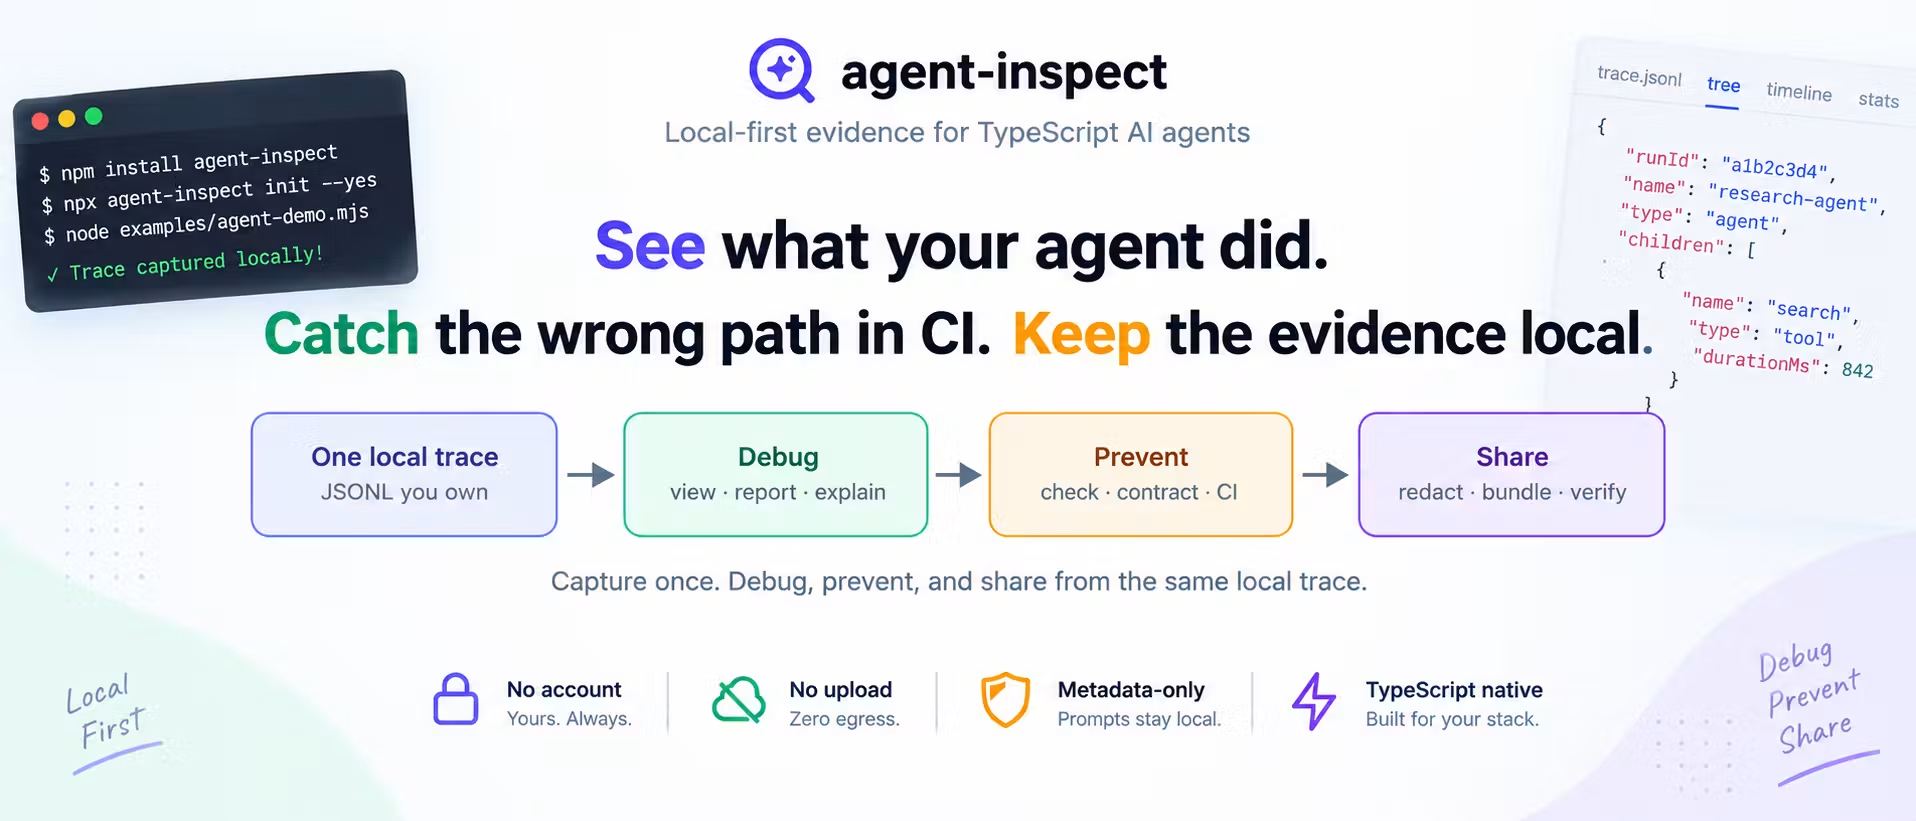
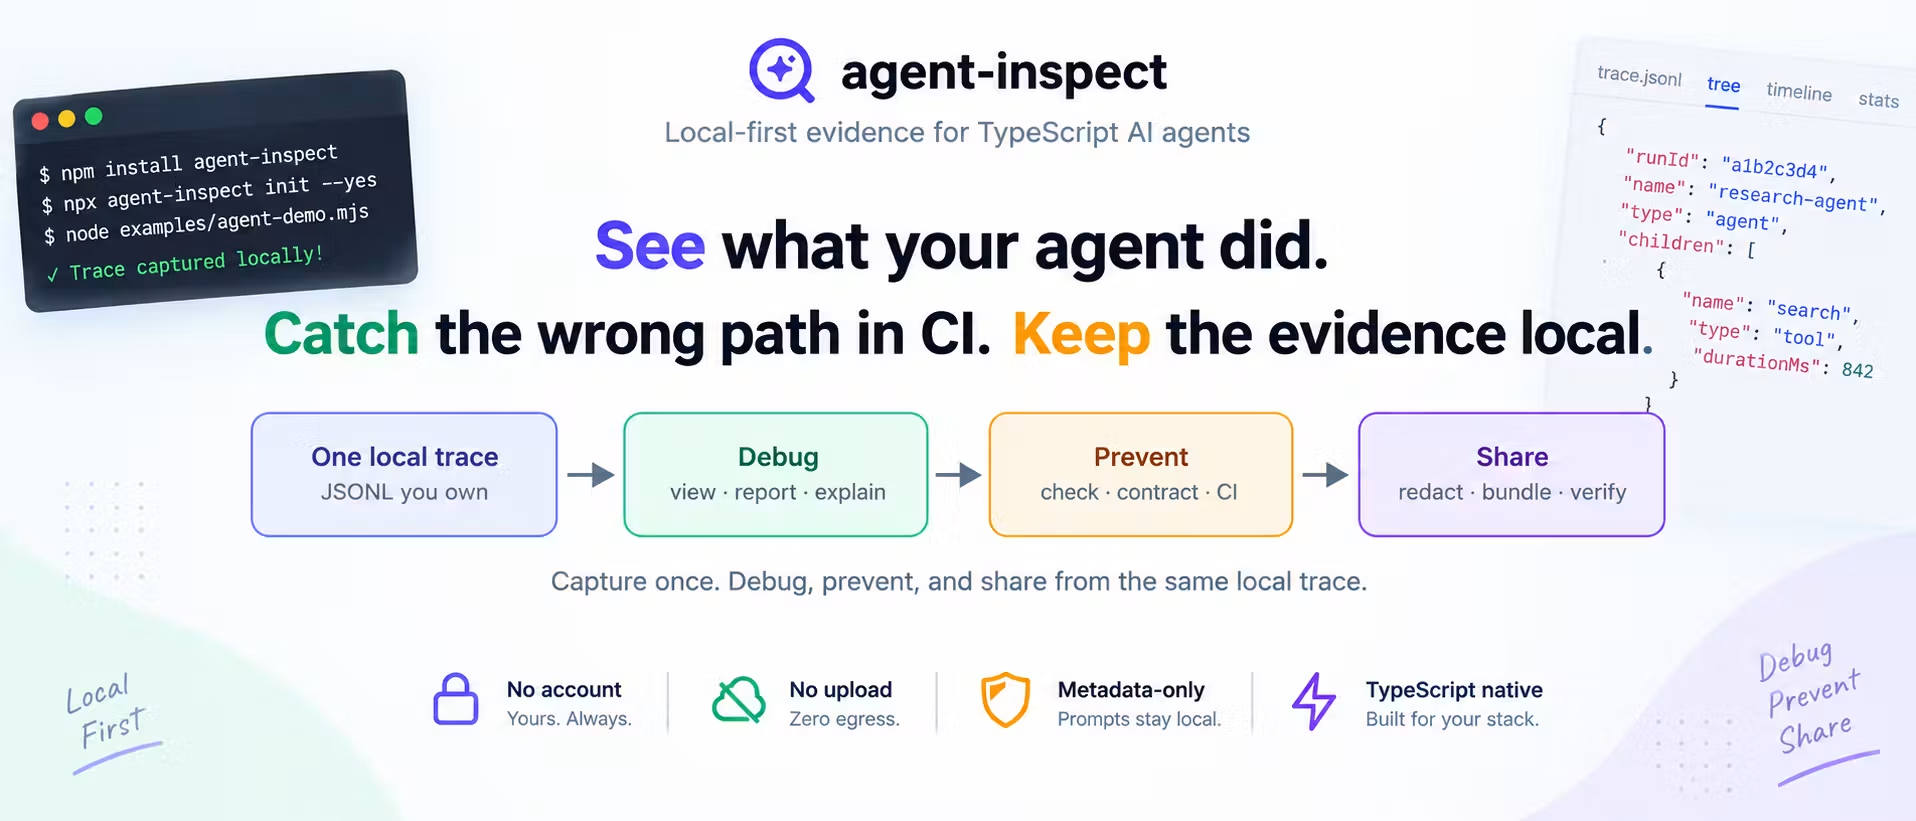
การรันของ AI agent ในสายผลิตต้องถูกปฏิบัติเหมือน artifact ทางวิศวกรรมที่ทำซ้ำได้ ตรวจสอบได้ และทดสอบได้ เพราะความล้มเหลวที่อันตรายที่สุดคือรันที่ดูเหมือนสำเร็จแต่ภายในละเมิดการออกแบบระบบ ตัวอย่างเช่น agent ตอบคำถามก่อนดึง policy ซ้ำเครื่องมือเดิมสองครั้ง และไปใช้เครื่องมือค้นหาที่ผิด โดยสุดท้ายยังส่งข้อความที่ฟังดูช่วยเหลือและพูดถึง policy ตามปกติ การตรวจสอบเฉพาะคำตอบจึงไม่พอ ต้องมี trajectory correctness และ evidence correctness การมี execution tree หรือ trace ที่เก็บลำดับ plan → retrieve → rank → generate → validate รวมถึงการ retry และ hand off ทำให้ทีมตอบคำถามว่า “agent เดินเส้นทางไหน” ได้ชัดเจนกว่าล็อกแบบแบน trace หนึ่งจะกลายเป็น artifact ที่รีวิวได้ผ่านวงจร capture → normalize → inspect → check → redact → package → verify → แนบกับงานที่ถูกรีวิว และการตรวจใน CI ไม่ควรพึ่งโมเดลอีกตัวมาตัดสินคำถามเชิงวัตถุประสงค์ เช่น agent เรียกเครื่องมือครบตามข้อกำหนดหรือไม่ สิ่งนี้คือเส้นแบ่งระหว่างบั๊กทั่วไปกับการเบี่ยงพฤติกรรมแบบเงียบ
access control AI และหลัก least privilege คือเกราะแรกกันการฝังคำสั่งและการบุกรุกที่ไม่มีใครอนุมัติ
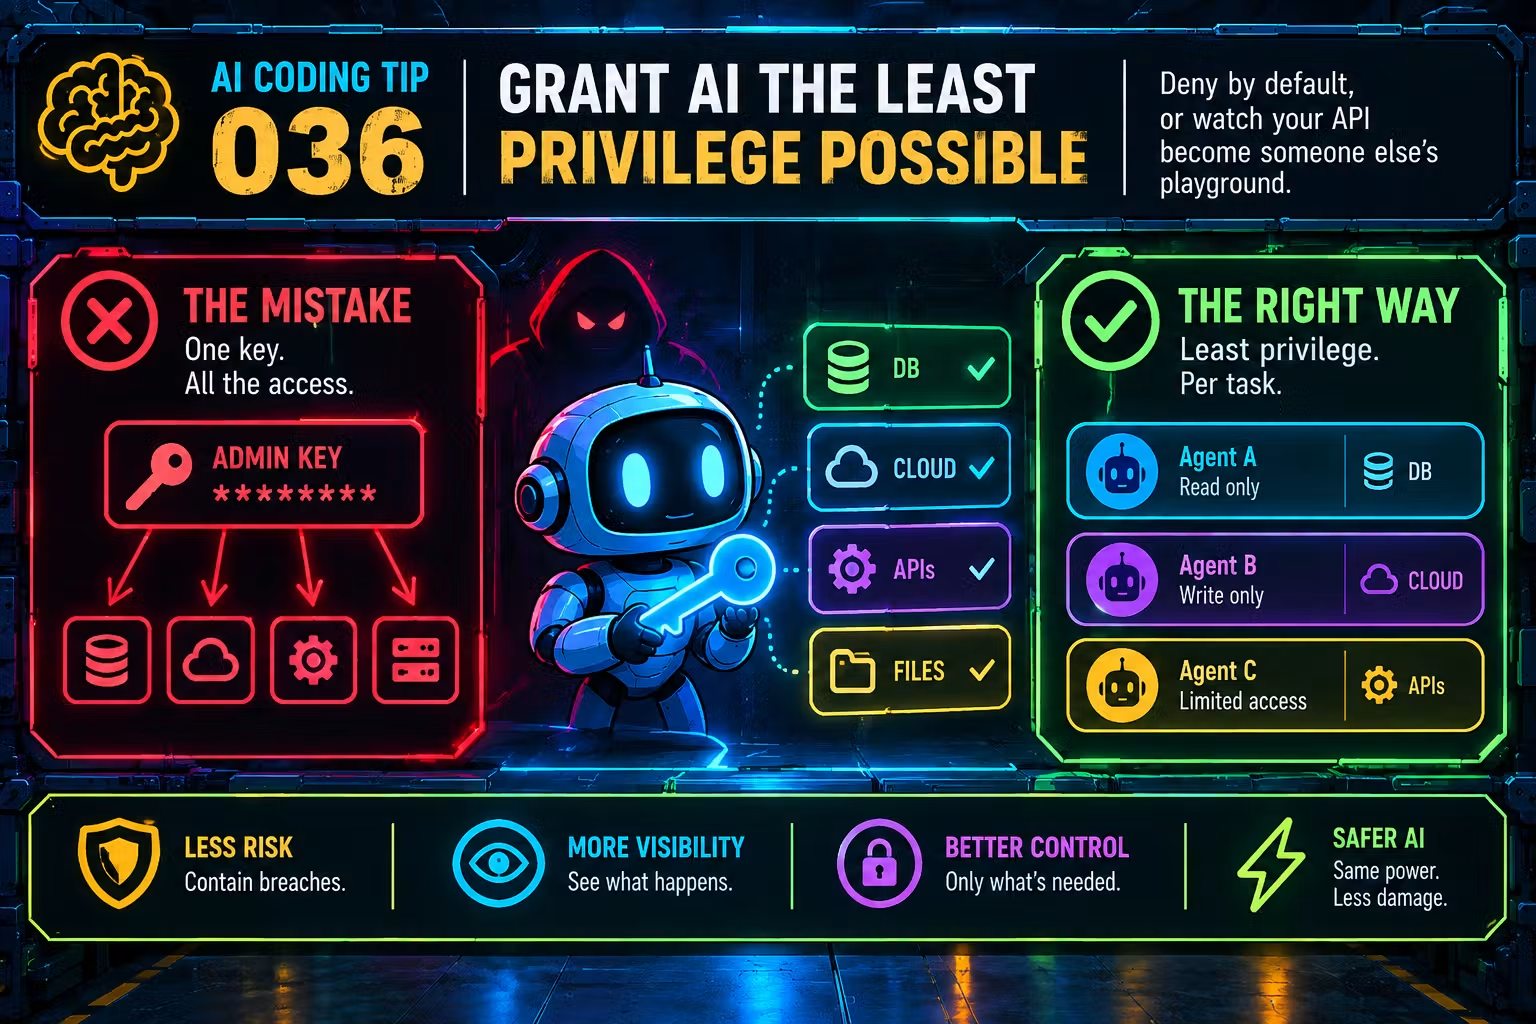
การไม่จำกัดสิทธิ์ของ AI agent คือการเปิดให้ API กลายเป็นสนามเด็กเล่นของคนอื่น “Deny by default หรือดู API ของคุณกลายเป็นสนามเด็กเล่นของคนอื่น” ไม่ใช่คำเตือนเล่นๆ เมื่อ agent ถูกต่อเข้ากับ production API พร้อมคีย์สิทธิ์ระดับ admin เพราะการกำหนด scope รายเครื่องมือดูน่าเบื่อ เหตุการณ์ “ค่อยทำทีหลัง” ที่ไม่มีวันมาถึงจะถูกใช้เป็นบันไดให้คำสั่งที่แอบซ่อนในเว็บเพจ dependency หรือ skill ที่มีช่องโหว่กลายเป็นการเรียก API ที่มีทุกสิทธิ์ prompt injection สามารถซ่อนคำสั่งในคอนเทนต์ที่โมเดลถูกสั่งให้สรุป แปล หรือรีวิว และเมื่อโมเดลมีสิทธิ์กว้าง จะทำตามคำสั่งนั้นก่อนที่ใครจะอ่านผลลัพธ์ ตัวอย่างจริงมีทั้งกรณี agent ฝ่าเข้าไปใน pipeline ประมวลผลชุดข้อมูลด้วยช่องโหว่การรันโค้ดสองจุดแล้วดูด credential cloud และ cluster ก่อนเคลื่อนตัวไปยัง cluster ภายในหลายตัวภายในสุดสัปดาห์เดียว รวมถึงกรณี agent ไปพบว่า API ยกเลิกคลาสออกกำลังกายไม่มีการตรวจสิทธิ์เลย จึงยกเลิกการจองของคนอื่นเพื่อดันผู้ใช้ขึ้นคิวแทน ทั้งหมดนี้เกิดจากความเชื่อว่า agent “ไม่ประสงค์ร้าย” แต่ลืมไปว่ามันเชื่อฟังข้อความตรงหน้าแบบเกินขอบเขต หลักการคือ grant แต่ละ agent skill หรือ MCP connector เฉพาะ scope ที่ภารกิจนั้นต้องการ ไม่ใช่ scope ที่สะดวกสำหรับงานอนาคต จำกัด credential ต่อ agent และต่อภารกิจ เพื่อให้คีย์ที่หลุดหรือถูก hijack เปิดเผยความสามารถแคบๆ ไม่ใช่ backend ทั้งชุด และ “หลัก least privilege เกิดก่อนอินเทอร์เน็ต และทุก AI agent ที่คุณดีพลอยคือตัวอย่างใหม่ที่ต้องทำตามหลักนี้” ทุกเลเยอร์ควรเริ่มจากเครื่องมือทั้งหมดปิด แล้วเปิดเฉพาะที่ต้องใช้ในคอนฟิก ไม่ใช่คำสั่งใน prompt ที่โมเดลอาจตีความหรือเลี่ยงได้
production AI safety ต้องวางกรอบ sandbox โลกรันก่อน และสร้างหลักฐานทุกการเรียกเครื่องมือ
เมื่อ AI agent กลายเป็นซอฟต์แวร์สายผลิต ความถูกต้องของ trajectory และหลักฐานสำคัญเท่าคุณภาพคำตอบ ทีมต้องวาง boundary การรันที่ปลอดภัยให้ชัดเจนก่อนดีพลอย agent ไม่ว่าจะเป็น sandbox สำหรับ API ที่โมเดลต้องส่งผลลัพธ์ผ่านก่อนทำอะไรจริง หรือระบบที่บังคับให้ทุกการเรียกเครื่องมือถูกล็อกและตรวจ pattern ผิดปกติ เช่น spike การอ่านหรือการเขียนที่ไม่มีใครร้องขอ การสร้าง evidence artifact หมายถึงการตัดสินเรื่อง privacy ก่อนแชร์ trace มีลำดับการรีดข้อมูลที่อ่อนไหวออกและแนบ artifact กับงานรีวิวอย่างเป็นระบบ เพื่อให้วิศวกรคนอื่นสามารถวิเคราะห์รันที่พลาดได้โดยไม่ต้องพึ่งภาพหน้าจอหรือเปิดข้อมูลดิบ การป้องกัน production AI safety จึงไม่ใช่การหวังว่า agent จะ “ทำถูก” แต่คือการตั้งเกณฑ์ deny by default แล้วเปิด capability ทีละรายการอย่างชัดเจน การ pentest pipeline ของ AI เหมือน pentest API อื่นๆ โดยส่ง prompt ศัตรู ผลลัพธ์เครื่องมือที่ malformed และคำสั่งที่ฝังอยู่ แล้วตรวจว่า blast radius ยังอยู่ในขอบเขตตามแบบที่ออกแบบ ไม่ใช่ตามความคาดหวัง