
AI Agents ไม่ได้ต้องการแค่ “ความจำ” แต่ต้องการการจัดการสถานะที่เข้าใจความจริง
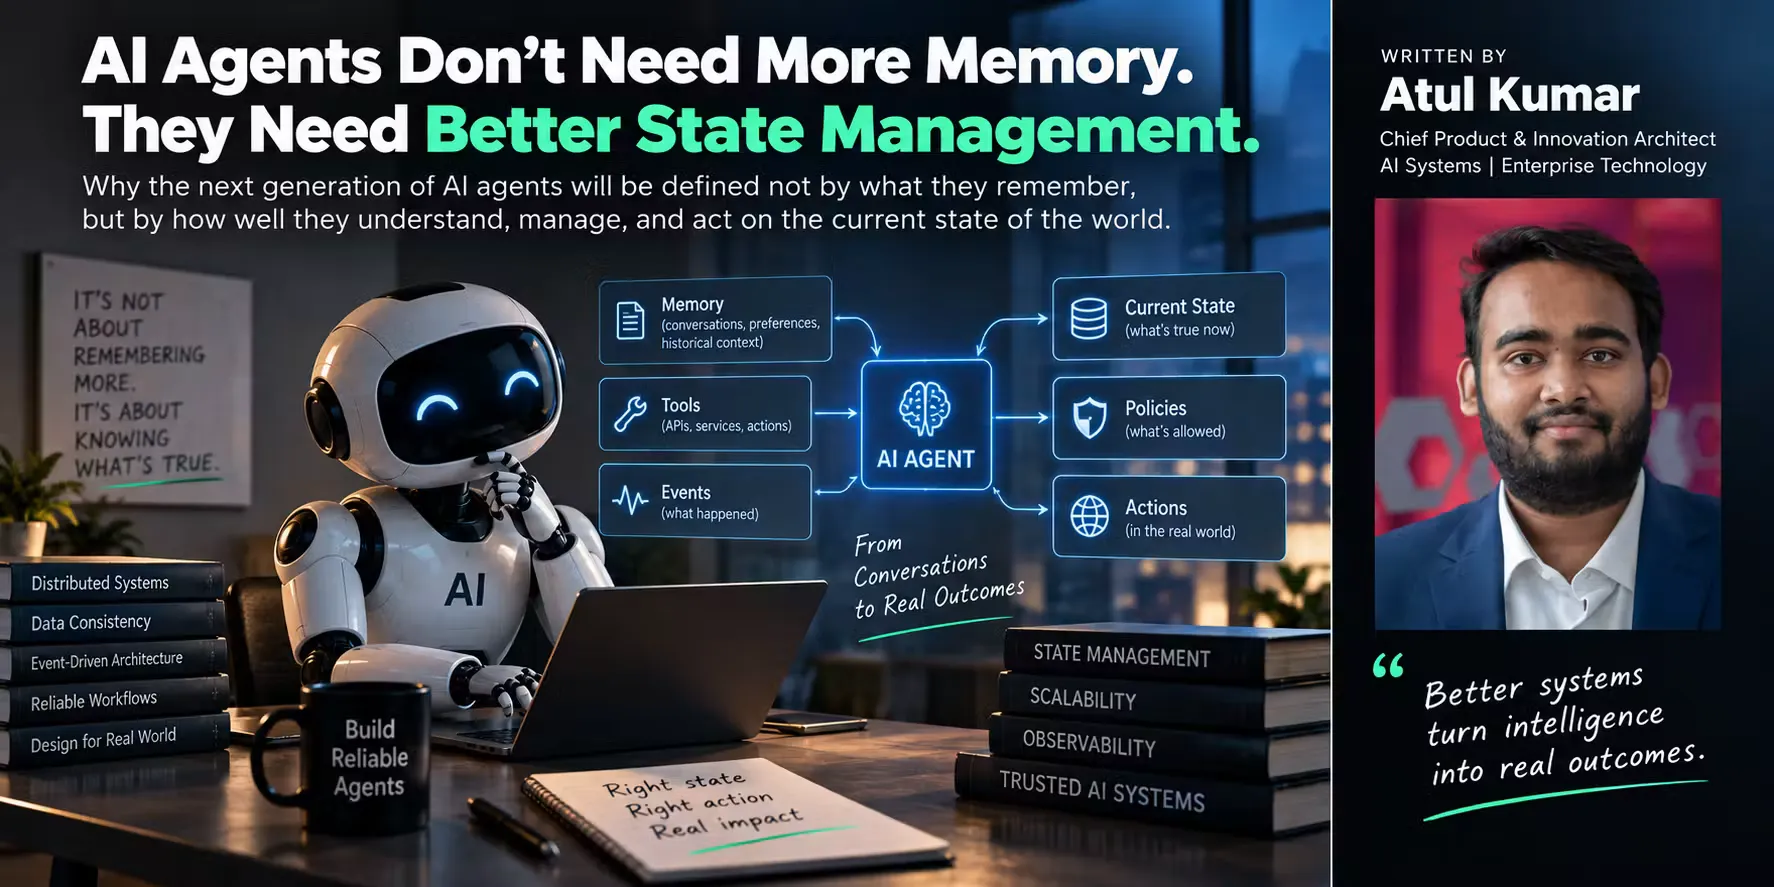
การจัดการสถานะ AI คือแนวทางออกแบบและควบคุมข้อมูลที่บอกว่าอะไรคือความจริงปัจจุบันของระบบ ตัวเอเจนต์ และธุรกิจ เพื่อให้โมเดลภาษาซึ่งเป็นส่วนไม่เก็บสถานะ สามารถตัดสินใจได้จากบริบทที่อัปเดตเสมอ ไม่หลงเชื่อข้อมูลเก่าหรือสรุปผิดจากคอนเท็กซ์ที่ถูกย่อมากเกินไป แม้เอเจนต์จะมีเลเยอร์ความจำก็ยังต้องรู้ว่าข้อมูลไหนเป็นสถานะเชิงธุรกิจที่มีเจ้าของชัดเจน ข้อมูลไหนเป็นประวัติสนทนา หรือเหตุการณ์ชั่วคราว การจัดการสถานะที่ดีจึงไม่ใช่การเก็บทุกอย่าง แต่คือการรู้ว่าอะไรสะท้อนความจริง ณ ตอนนี้ และออกแบบสถาปัตยกรรมให้ข้อมูลประเภทต่าง ๆ อยู่ในที่ที่เหมาะสมและถูกใช้ถูกจังหวะ ทุกครั้งที่ AI agent ลืมหรือให้คำตอบย้อนแย้ง สัญชาตญาณของทีมมักคือเพิ่มความจำ ขยาย context window เสริม vector database หรือสร้างสรุปยาว ๆ แนวคิดนี้ดูเหมือนถูก แต่ในโปรดักชันกลับยิ่งทำให้สับสน เพราะเอเจนต์เริ่มมีข้อมูลล้นมือ โดยไม่มีตัวบอกว่าข้อมูลชิ้นไหนคือสถานะล่าสุดของระบบธุรกรรมจริง ๆ ถ้าดึงข้อมูลเก่าเข้าคอนเท็กซ์ โมเดลสามารถให้เหตุผลต่อข้อมูลนั้นได้ดีมาก แต่ผลงานที่ได้อาจผิดเต็ม ๆ เพราะข้อมูลตั้งต้นผิด ปัญหาจึงไม่ใช่ความจำไม่พอ แต่คือการจัดการ state ที่ไม่ชัดว่าความจริงตอนนี้คืออะไร
แยก “โมเดลที่ไร้สถานะ” ออกจาก “รันไทม์ที่มีสถานะ” เพื่อรับมือระบบกระจายจริง
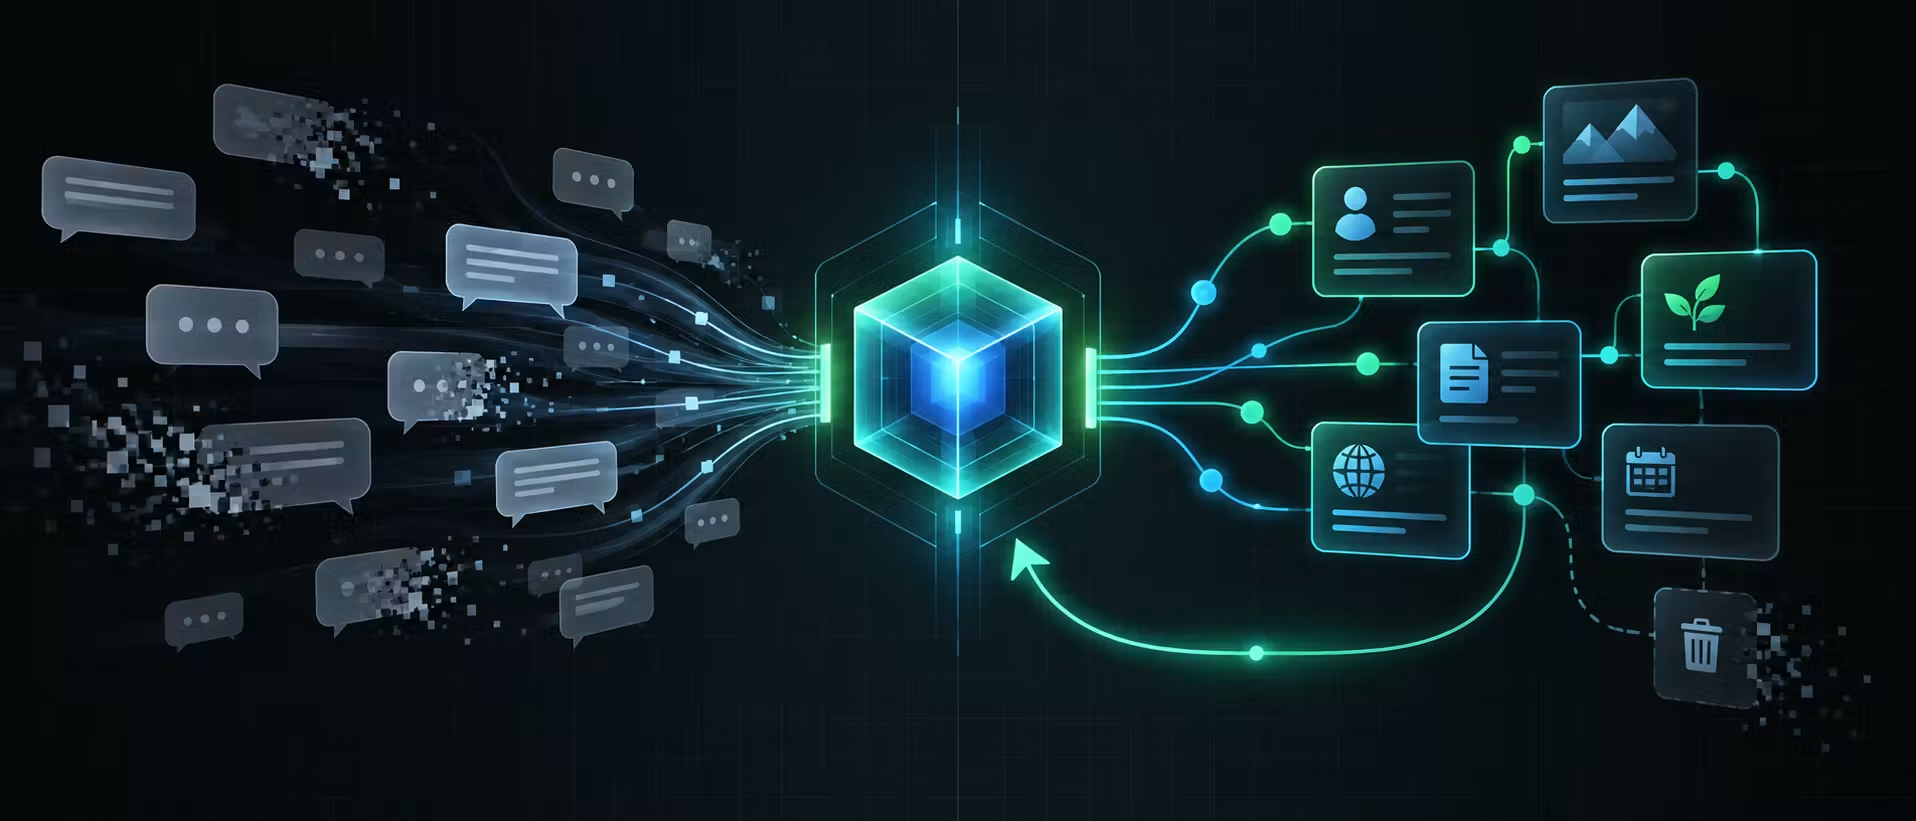
หัวใจของ AI agent state management คือการทำให้โมเดล LLM คงความเป็นองค์ประกอบไร้สถานะ ขณะที่รันไทม์รอบ ๆ เป็นตัวแบกภาระเรื่องเซสชัน การคงสถานะเวิร์กโฟลว์ การเรียกเครื่องมือ และการกู้คืนเมื่อมีเหตุขัดข้อง แนวทางนี้ทำให้โมเดลรับบริบทย่อยที่จำเป็นต่อการตัดสินใจแต่ละครั้ง ขณะที่ระบบโดยรวมยังรักษาความต่อเนื่องของงานได้ การจัดการสถานะ AI แบบนี้ไม่ได้หน้าตาเหมือนงานปรับ prompt แต่มากกว่านั้นคือศาสตร์ของ distributed AI systems ที่ต้องคิดเรื่อง timestamp เวอร์ชัน optimistic concurrency idempotency ธุรกรรม log เหตุการณ์ checkpoint lease ขอบเขตความสอดคล้อง และนโยบายการกู้คืน ลองดูตัวอย่างเอเจนต์จัดการ onboarding พนักงานใหม่ มันสร้างเรคคอร์ดพนักงาน ขอสิทธิ์เข้าหลายระบบ แล้วรออนุมัติ ระหว่างนั้นโปรเซสเอเจนต์ล้ม เมื่อกลับมาทำงานใหม่ สิ่งที่มันต้องการไม่ใช่ทุกประโยคในบทสนทนาเดิม แต่คือการสร้าง execution state กลับมาให้รู้ว่าโพรเซสอยู่ขั้นไหนแล้ว ขั้นใดสำเร็จ ขั้นใดต้องทำซ้ำ ในระบบกระจาย ยังต้องรับมือเคสที่มีเอเจนต์สองตัวแก้ไขบัญชีลูกค้าเดียวกันโดยอ่านจากเวอร์ชันสถานะเดียวกันและอัปเดตต่างส่วนพร้อมกัน การออกแบบให้การเขียนสถานะมีเวอร์ชันและกฎ concurrency ที่ชัดจึงเป็นเงื่อนไขพื้นฐานของ AI production reliability ไม่ใช่ฟีเจอร์เสริม
จำให้ถูกเรื่อง: สถาปัตยกรรมความจำของเอเจนต์ต้องรู้ต่างระหว่าง memory กับ state
เลเยอร์ความจำของเอเจนต์คือบริการที่ให้เอเจนต์สามารถเก็บ ดึง และใช้คอนเท็กซ์ข้ามอินเทอร์แอ็กชัน ทำให้ทุกเซสชันไม่เริ่มจากศูนย์ ระบบความจำในโปรดักชันมักเดินตามลำดับเดียวกัน คือต้องจับเหตุการณ์ที่เกิดขึ้น เลือกสิ่งที่ควรจำ แล้วเก็บเป็นเรคคอร์ดให้ใช้ในอนาคต หนึ่งวิธีที่ช่วยให้สถาปัตยกรรมชัดคือแบ่งออกเป็นสามแนวคิด events strategies และ memory records events คืออินพุตดิบ เช่นข้อความ การแก้ไข การตัดสินใจ พร้อมเมทาดาทาอย่างเวลา ผู้กระทำ และคอนเท็กซ์เซสชัน strategies คือกติกาในการกลั่นว่าอะไรควรถูกเก็บ ส่วน memory records คือชุดข้อเท็จจริง ความชอบ และเป้าหมายที่เอเจนต์สามารถเรียกใช้ในภายหลัง สิ่งที่ทำให้หลายทีมหลงทางคือใช้คำว่า memory ครอบทุกอย่าง ตั้งแต่ transcript สนทนา เวิร์กโฟลว์เช็กพอยต์ ไปจนถึงผลตอบเครื่องมือ ทั้งที่ความหมายต่างกันมาก transcript บอกว่าใครพูดอะไร semantic memory บอกสิ่งที่ระบบเชื่อว่าน่าจะมีประโยชน์จากอดีต workflow state บอกว่ากระบวนการอยู่จุดใด ส่วนระบบธุรกิจที่ถือสิทธิ์ข้อมูลบอกว่าความจริงทางธุรกิจคืออะไร สิ่งเหล่านี้แทนกันไม่ได้ การพยายามให้โมเดลจำทุกอย่างจึงเสี่ยง เพราะโมเดลเก่งด้านการตีความและวางเหตุผล แต่มันไม่รู้เองว่าข้อเท็จจริงไหนหมดอายุแล้ว “โมเดลให้เหตุผล รันไทม์ให้ความต่อเนื่อง” แนวคิดนี้ช่วยตัดสินใจได้ชัดขึ้นว่าอะไรควรอยู่ในเลเยอร์ความจำ อะไรควรเป็น state ที่มีเจ้าของชัดเจน
จาก black box สู่ระบบที่สังเกตได้: tracing เต็มชั้น สรุปแบบ typed และสัญญาเอาต์พุต
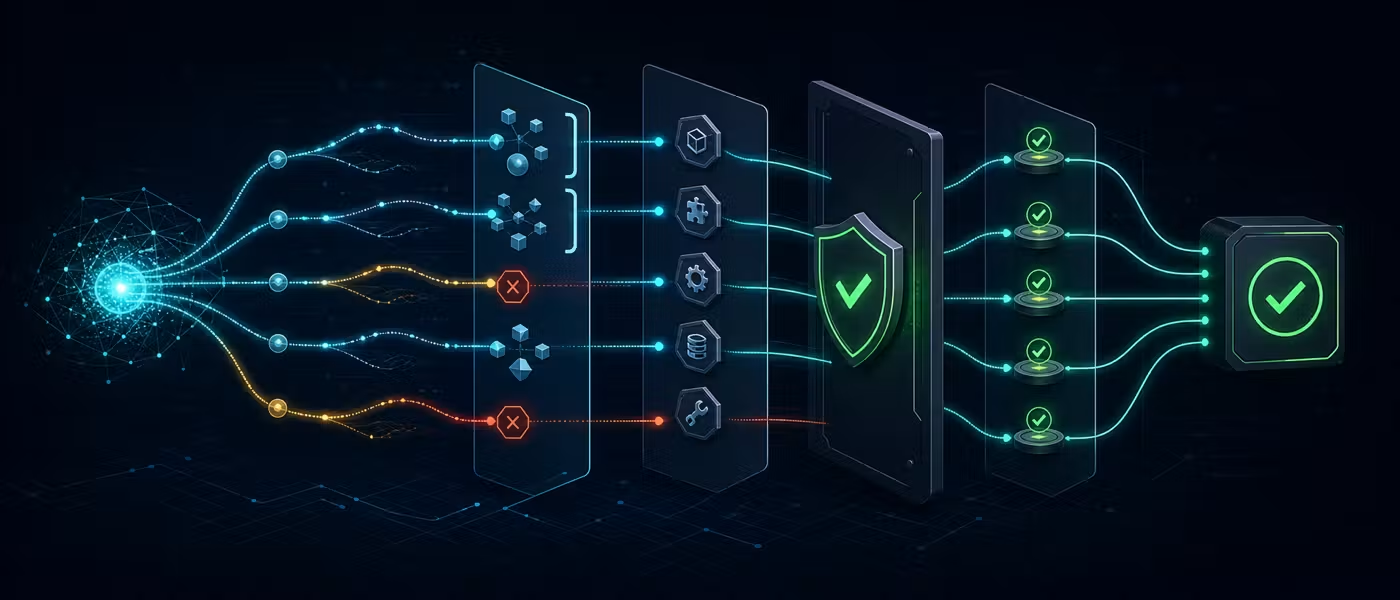
ถ้าอยากให้ AI production reliability เกิดได้จริง สายตาเราต้องมองทะลุเอเจนต์ ไม่ปล่อยให้มันเป็นกล่องดำ แนวคิด observability-first มองว่าความสามารถในการเฝ้าดูคือรากฐานของความน่าเชื่อถือ ในงานเอเจนต์ยุค LLM ที่ผลลัพธ์ไม่แน่นอน การออกแบบชั้น tracing เสร็จก่อนจะเขียนลูปหลักของเอเจนต์ช่วยให้เรามีแผนภาพครบว่ามีการเรียกโมเดลเมื่อไร ใช้เครื่องมืออะไร ได้ผลลัพธ์แบบไหน และสรุปสถานะแต่ละขั้นอย่างไร การจัดเก็บสแปนที่มีประเภทชัด เช่น turn model call tool execution ทำให้เราสามารถวิเคราะห์ย้อนหลังได้ว่าเอเจนต์คิดอะไร ทำอะไร และล้มเหลวตรงไหน พร้อมทั้งให้อีวาลระบบใช้บันทึกเดียวกันเพื่อตรวจสอบเชิงกลจักร ก่อนส่งสำเนาไปยังระบบสำหรับมนุษย์อ่าน ในฝั่งอินเทอร์เฟซ โดยเฉพาะแอปมือถือ ช่องว่างที่ทำให้ฟีเจอร์ AI พังเงียบ ๆ คือการพยายามผูก UI เชิงดีเทอร์มินิสติกเข้ากับผลตอบ LLM ที่เป็นความน่าจะเป็น จุดแก้ไม่ใช่ปรับ prompt ให้เนียนกว่า แต่คือการปฏิบัติต่อผลลัพธ์ของโมเดลเป็นสัญญาเอาต์พุตที่มีสคีมา เวอร์ชัน และการตรวจสอบก่อนให้ UI แตะต้อง ต้องตั้งสคีมาจากความต้องการของหน้าจอ เช่นช่องคำบรรยาย รายการรูป สถานะการโหลด ไม่ใช่รอดูว่าระบบจะส่งอะไรมา ถ้าเราไม่สามารถวาดหน้าจอจากสคีมาเพียงอย่างเดียว แปลว่าสคีมายังไม่เสร็จ การเขียน prompt เพิ่มไม่ช่วย และมีหลักเหล็กข้อหนึ่งคือ “ห้ามเชื่อผลตอบโมเดลดิบ ต้องผ่าน validation ก่อนทุกครั้ง” ทั้งเชิงโครงสร้างและความหมาย เมื่อมี fallback ที่ชัดว่าถ้าผิดสคีมาจะเรนเดอร์อย่างไร UI ก็ไม่ล้ม แม้โมเดลตอบผิดรูป
ทำไมไพล็อตที่สวยหรูยังล้มในโปรดักชัน และเกณฑ์ความพร้อมที่ควรคิดใหม่
ในโลกการทดสอบ หลายองค์กรกำลังให้ความสำคัญกับ AI แต่ใช้มันในงานหลักน้อยกว่าที่คิด ตามรายงานหนึ่ง มีผู้ตอบแบบสอบถาม 88 เปอร์เซ็นต์มองว่า AI เป็นกลยุทธ์สำคัญของการทดสอบในอนาคต ขณะที่มีเพียง 12.6 เปอร์เซ็นต์ที่ใช้มันอย่างแพร่หลายในกิจกรรมทดสอบหลัก ช่องว่างนี้ไม่ได้แปลว่า AI ในการทดสอบล้มเหลว แต่สะท้อนว่าทีมยังสับสนว่าจะวัดความสำเร็จอย่างไร หลายทีมรันไพล็อตเล็ก ๆ แล้วใช้มาตรวัดของการ rollout ทั่วองค์กรมาจับ เมื่อผลไม่สวยก็สรุปว่าเครื่องมือไม่เก่ง ทั้งที่ไพล็อตไม่ได้ถูกออกแบบมาเพื่อตอบคำถามนั้น ในทางกลับกัน ไพล็อตที่สะอาดราบรื่นมักถูกตีความว่าเครื่องมือพร้อมรันเต็มองค์กร ทั้งที่จริงมันถูกทดสอบแค่เคสเดียวที่นิยามชัดเจน รายงานคุณภาพโลกชี้ให้เห็นว่าองค์กรมีระดับการใช้ GenAI ที่หลากหลาย ตั้งแต่กลุ่มที่ใช้ทั่วทั้งองค์กร กลุ่มที่ยังทดลอง กลุ่มที่ใช้จำกัดเคส ไปจนถึงกลุ่มที่ไม่ใช้เลย แต่ละขั้นมีเป้าหมายต่างกัน ไพล็อตถือว่าผ่านถ้ามันทำงานได้ดีในกรอบที่ออกแบบไว้ โปรแกรมขยายสเกลถือว่าผ่านถ้าทีมยังใช้ได้ต่อเนื่องโดยภาระบำรุงรักษาไม่กินผลผลิต ส่วน rollout ทั้งองค์กรต้องให้คุณภาพสูงและมูลค่าทางธุรกิจที่จับต้องได้ การใช้เกณฑ์ผิดขั้นจึงให้ตัวเลขที่ดูแย่ด้วยเหตุผลที่ไม่เกี่ยวกับความสามารถของเครื่องมือเลย และคำเตือนสำคัญคือ “ไพล็อตที่ผ่านคือจุดเริ่ม ไม่ใช่ใบรับรองพร้อมโปรดักชัน”