
ลดงานกระจัดกระจายก่อนเริ่มฝึกโมเดล
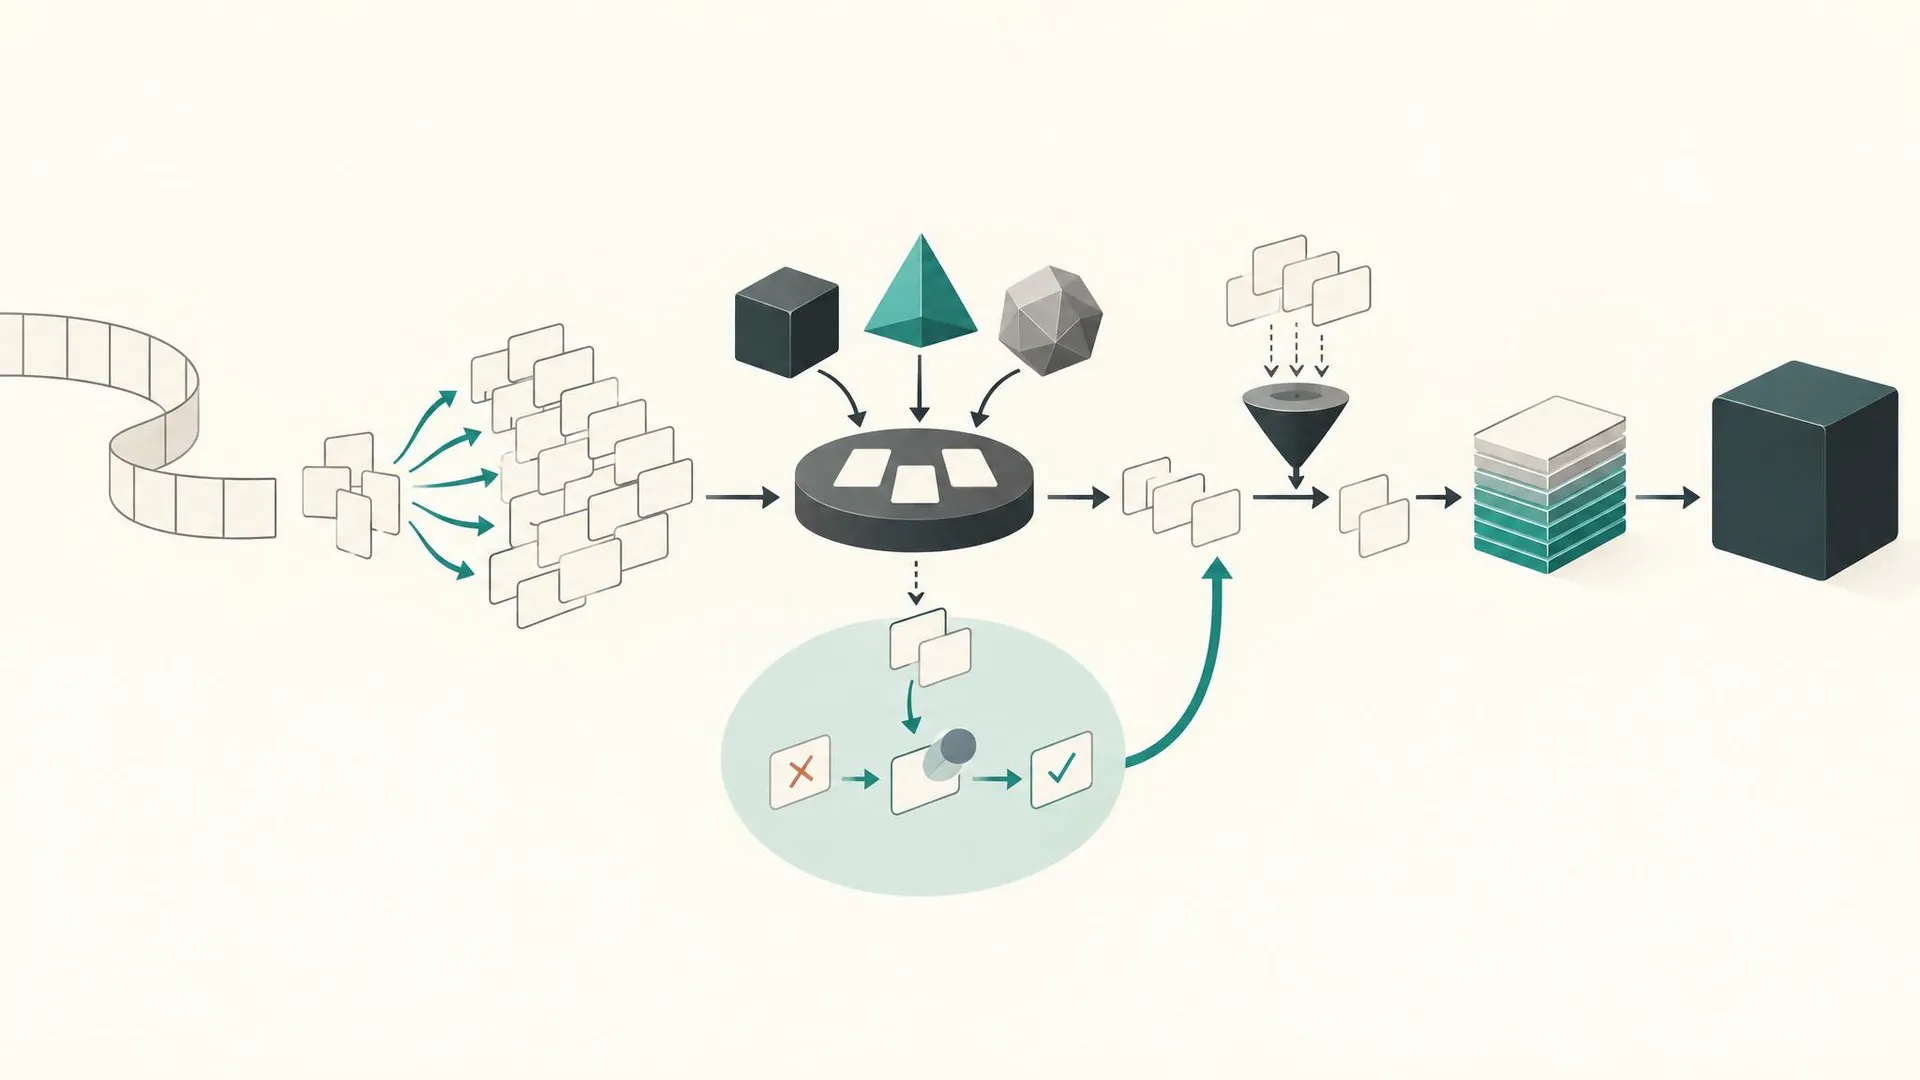
การเตรียมข้อมูล AI คือขั้นตอนสร้าง ตรวจสอบ และจัดรูปแบบข้อมูลให้พร้อมสำหรับการฝึกหรือประเมินโมเดล โดยครอบคลุมทั้งการเติมข้อมูลที่ขาด การตรวจหาข้อผิดพลาด และการกำหนดป้ายกำกับให้สอดคล้องกัน เมื่อวันที่ 17 พฤศจิกายน 2026 AWS ประกาศเพิ่มเครื่องมือเตรียมข้อมูล AI ใน Amazon SageMaker AI ทั้งการสร้างข้อมูลสังเคราะห์ การประเมินคุณภาพ การแปลงข้อมูล การติดป้ายกำกับอัตโนมัติ และการตรวจสอบโดยมนุษย์ จุดสำคัญไม่ใช่แค่มีฟีเจอร์เพิ่ม แต่คือการนำงานที่มักแยกกันอยู่ในเครื่องมือติดป้ายกำกับ สคริปต์สร้างข้อมูล และขั้นตอนตรวจสอบ มารวมไว้ในเวิร์กโฟลว์เดียว ทีมเลือกใช้เฉพาะความสามารถที่ต้องการ หรือเชื่อมต่อหลายขั้นตอนเข้าด้วยกันได้ ทำให้การเตรียมชุดข้อมูลเป็นส่วนหนึ่งของการพัฒนาโมเดล แทนที่จะเป็นภาระงานแยกที่ต้องประกอบขึ้นเอง
แนวทางนี้แก้ปัญหาที่เกิดขึ้นจริงในทีมพัฒนา AI: ข้อมูลอาจมีรูปแบบไม่ตรงกัน มีระเบียนซ้ำ หรือมีป้ายกำกับผิด แต่ความผิดพลาดเหล่านี้มักปรากฏชัดเมื่อเริ่มฝึกไปแล้ว การตรวจชุดข้อมูลก่อนใช้ทรัพยากรประมวลผลช่วยให้ทีมจัดการระเบียนที่บกพร่องได้ตั้งแต่ต้น และลดโอกาสเสียเวลาไปกับการฝึกจากข้อมูลที่ไม่น่าเชื่อถือ
สร้าง แปลง และตรวจคุณภาพในลำดับเดียว
เครื่องมือสร้างข้อมูลสังเคราะห์ใช้ข้อกำหนดและข้อมูลอ้างอิงที่ผู้ใช้เลือก เพื่อสร้างระเบียนสำหรับการฝึก การประเมิน หรือการทดสอบ ที่น่าสนใจคือระบบสร้างไปป์ไลน์ที่ใช้โค้ดให้ทีมตรวจสอบ แก้ไข และนำกลับมาใช้ซ้ำได้ จึงไม่ต้องมองข้อมูลที่สร้างขึ้นเป็นผลลัพธ์กล่องดำ ส่วนการประเมินคุณภาพรองรับกฎทางธุรกิจ เมตริกที่มีมาให้ และการให้โมเดลภาษาประเมินข้อมูล นอกจากนี้ยังค้นหารายการซ้ำหรือเกือบซ้ำ ตรวจสัญญาณรบกวนในป้ายกำกับ และหาความเสี่ยงที่คำตอบรั่วเข้าไปในข้อมูลฝึกได้
หลังตรวจคุณภาพ ทีมสามารถปรับข้อมูลด้วยการลบรายการซ้ำ รวม แบ่ง หรือกรองระเบียน รวมถึงใช้โค้ด Python ที่กำหนดเอง เมื่อต้องจัดรูปแบบชุดข้อมูลสำหรับการปรับแต่งโมเดลด้วยข้อมูลกำกับ การเพิ่มประสิทธิภาพความชอบโดยตรง หรือการเรียนรู้แบบเสริมกำลัง ขั้นตอนเหล่านี้ช่วยให้การแปลงข้อมูลและการตรวจสอบเกิดก่อนการฝึก ไม่ใช่ตามแก้หลังพบว่าโมเดลเรียนรู้จากตัวอย่างที่ผิดพลาด ความสามารถจึงมีประโยชน์ต่อทั้งคุณภาพผลลัพธ์และการใช้ทรัพยากรประมวลผลอย่างมีเหตุผล
ติดป้ายกำกับอัตโนมัติ แต่ยังเปิดทางให้คนตรวจ
การติดป้ายกำกับข้อมูลเริ่มได้จากชุดข้อมูลที่ยังไม่มีป้ายกำกับ ชุดตั้งต้นขนาดเล็กที่ติดป้ายแล้ว หรือข้อมูลที่ไม่มีตัวอย่างกำกับเลย งานที่รองรับมีทั้งการจำแนกประเภท การรู้จำเอนทิตี การตอบคำถามจากข้อความ การจัดอันดับ และการสรุปความ รวมถึงงานที่กำหนดเองได้ ก่อนประมวลผลทั้งชุด ระบบให้ตรวจข้อกำหนดการติดป้ายกำกับกับตัวอย่างก่อน ซึ่งเป็นจุดตรวจที่ควรใช้ให้เต็มที่ เพราะคำสั่งที่คลุมเครือย่อมทำให้ระบบสร้างป้ายกำกับที่คลาดเคลื่อนในวงกว้าง
สำหรับงานที่มีคำตอบให้เลือกตายตัว โมเดลหลายตัวทำหน้าที่เป็นคณะผู้ตัดสินและสร้างคะแนนความเชื่อมั่นจากระดับความเห็นพ้อง แถวที่คะแนนต่ำกว่าเกณฑ์จะส่งต่อให้มนุษย์ตรวจใน SageMaker Studio โดยผู้เชี่ยวชาญแก้ไขผลได้ และการแก้ไขจะย้อนกลับไปช่วยปรับระบบติดป้ายกำกับอัตโนมัติ วงจรนี้มีความสำคัญกว่าการพยายามทำให้ทุกขั้นตอนเป็นอัตโนมัติ เพราะช่วยสงวนเวลาคนไว้กับกรณีที่กำกวม ขณะเดียวกันทีมยังตรวจรายงานและเมตริกฉันทามติได้ เอกสารกำหนดให้ใช้ SageMaker Python SDK เวอร์ชัน 3.30.0 ขึ้นไป และงานเหล่านี้เปิดให้ใช้งานทั่วไปในรีเจียนที่ระบุ
การแข่งขันอยู่ที่การทำข้อมูลให้พร้อมใช้
การประกาศของ AWS เกิดขึ้นท่ามกลางแนวโน้มที่ผู้ให้บริการคลาวด์พยายามย้ายงานเตรียมข้อมูลเข้าใกล้แหล่งจัดเก็บข้อมูล เมื่อวันที่ 19 พฤศจิกายน 2026 Google Cloud เปิดตัวตัวอย่างบริการเพิ่มข้อมูลกำกับออบเจ็กต์ใน Cloud Storage ซึ่งดึงเมตาดาทาแบบมีโครงสร้างจากรูปภาพและเอกสาร PDF ให้ระบบวิเคราะห์หรือเอเจนต์นำไปใช้ได้ การเตรียมข้อมูลไว้ล่วงหน้าช่วยหลีกเลี่ยงการส่งภาพจำนวนมากเข้าโมเดลซ้ำทุกครั้งที่มีคำสั่ง ซึ่งกินโทเค็นและเพิ่มเวลารอ อีกทั้งยังลดความจำเป็นต้องตั้งระบบประมวลผลและคิวแยกต่างหาก
ตัวอย่างจาก Google ระบุว่าบริการช่วยติดป้ายกำกับคลังสินทรัพย์งานสร้างสรรค์ของ L’Oreal ได้เร็วขึ้น 100 เท่า เมื่อเทียบกับกระบวนการเดิม แต่ตัวเลขนี้เป็นกรณีของบริการและงานเฉพาะ ไม่ควรนำไปสรุปว่าเครื่องมือเตรียมข้อมูลทุกแบบจะให้ผลเท่ากัน ความแตกต่างของแนวทางชัดเจน: AWS เน้นเวิร์กโฟลว์ตั้งแต่สร้างและตรวจชุดข้อมูลไปจนถึงส่งให้คนทวน ส่วนบริการของ Google วางการดึงข้อมูลกำกับไว้ในชั้นพื้นที่จัดเก็บ Google ระบุว่าการเพิ่มข้อมูลด้วย Gemini แบบเนทีฟยังเป็นฟีเจอร์ที่กำลังจะเปิดให้ใช้ และแนะนำให้ผู้สนใจยื่นขอสิทธิ์เข้าถึงแยกต่างหาก ส่วนการจัดประเภท PDF ในรุ่นตัวอย่างเปิดให้ใช้ฟรีจนกว่าจะเปิดบริการทั่วไปในช่วงหลังของปี 2026
สำหรับทีมที่ใช้ SageMaker อยู่แล้ว คุณค่าของเครื่องมือชุดใหม่นี้อยู่ที่การทำให้ตรวจสอบที่มาของข้อมูลและแก้ขั้นตอนเตรียมชุดข้อมูลได้ ก่อนเริ่มใช้กำลังประมวลผลฝึกโมเดล การมีระบบอัตโนมัติช่วยลดงานซ้ำ แต่ไม่ได้แทนการตัดสินใจเรื่องคุณภาพหรือความเหมาะสมของข้อมูล ทางเลือกที่ดีจึงไม่ใช่การติดป้ายกำกับทุกอย่างโดยไม่ตรวจ หากเป็นการให้ระบบจัดการงานปริมาณมาก พร้อมส่งกรณีที่ไม่มั่นใจให้คนพิจารณา