
สรุปประเด็น: สกิลเยอะไม่เท่ากับฉลาดขึ้น
Claude skills optimization คือกระบวนการออกแบบ คัดเลือก และดูแลชุดสกิลของ Claude อย่างมีกลยุทธ์ เพื่อให้โมเดลใช้คำสั่งและเครื่องมือที่จำเป็นเท่านั้น ลดการใช้ AI token consumption ที่บานปลายจากข้อความอธิบายและกฎที่ยืดยาวเกินความจำเป็น และหลีกเลี่ยง custom skills performance ที่ถดถอยจากการซ้อนสกิลทับกันโดยไม่ทดสอบ คุณไม่ควรคิดว่าการเพิ่มจำนวนสกิลคือคำตอบของผลิตภาพ แต่ควรมองสกิลเป็นระบบเล็กๆ ที่ต้องผ่าน skill configuration best practices และถูกปรับปรุงสม่ำเสมอเพื่อให้สอดคล้องกับงานจริงที่คุณทำทุกวัน มุมมองที่ต้องกล้าพูดตรงๆ คือ หลายคนกำลังตกหลุมกับดัก “สกิลเยอะไว้ก่อน” แบบเดียวกับคนเขียนโค้ดที่ชอบยัดฟีเจอร์โดยไม่วัดผล เมื่อสกิลแต่ละอันคือข้อความระดับหลาย KB ที่ต้องถูกโหลดเข้า context ทุกครั้ง การสะสมไปเรื่อยๆ โดยไม่ตรวจสอบ ทำให้ Claude ใช้เวลาคิดมากขึ้น ใช้ token มากขึ้น แต่ผลลัพธ์ไม่ได้ดีขึ้นเลย นักพัฒนาระดับมืออาชีพพบว่าการเพิ่มสกิลแบบไม่ประเมินกลับสร้างภาระมากกว่าประโยชน์และเปิดประตูให้ AI เสื่อมสมรรถนะเงียบๆ
เคสจริง: สกิลช่วยเปลี่ยนชื่อเซสชันที่กลายเป็นตัวกินทรัพยากร
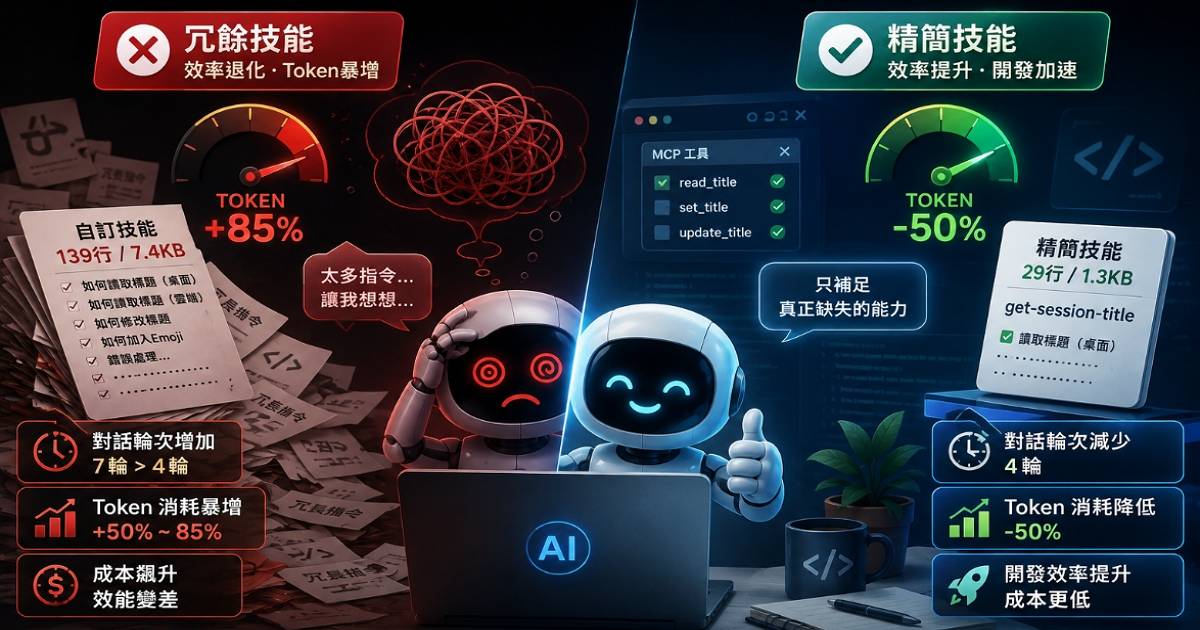
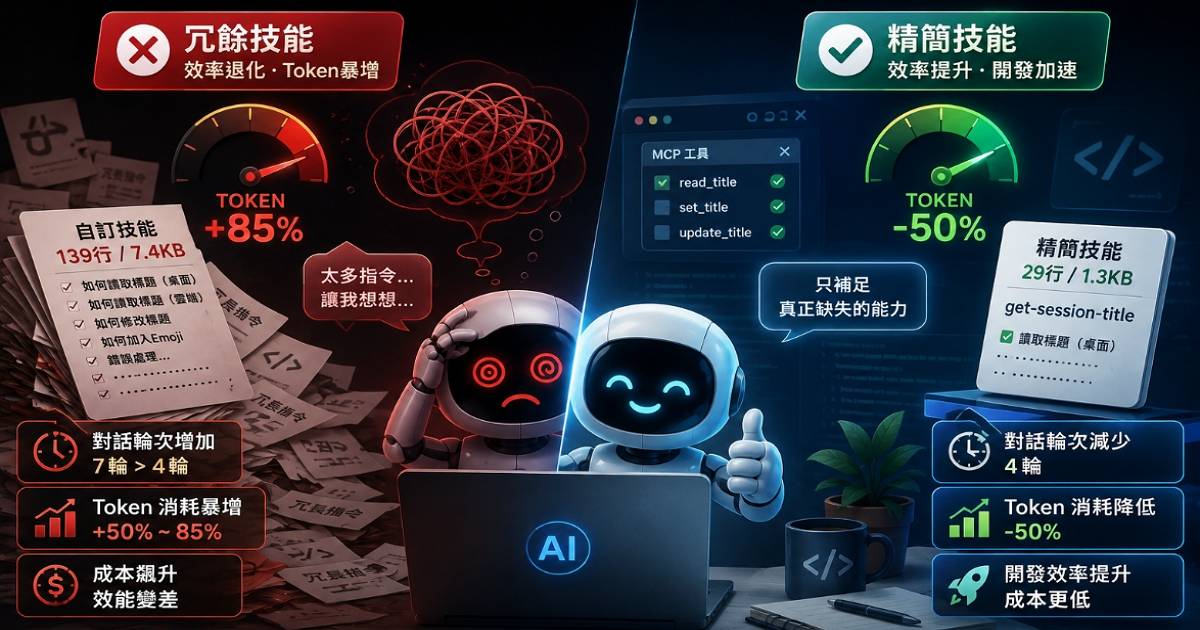
กรณีศึกษาที่น่าคิดมาจากวิศวกรซอฟต์แวร์ที่สร้างสกิล session-title เพื่อให้ Claude ช่วยเพิ่มอีโมจิหน้าชื่อเซสชันและอ่านเขียนชื่อจากเครื่องหรือคลาวด์ เมื่อย้ายงานไปใช้ Cloud Session เขาพบว่าแพลตฟอร์มมี MCP เครื่องมืออ่านและตั้งชื่อเซสชันอยู่แล้ว แต่กลับขยายสกิลเป็น 139 บรรทัดราว 7.4 KB เพื่อให้รองรับทั้งเดสก์ท็อปและคลาวด์ ทำให้เกิดคำถามว่าเรากำลังสอนสิ่งที่ Claude รู้อยู่แล้วหรือไม่ และข้อความสกิลที่เกินจำเป็นกำลังรบกวนโมเดลอยู่หรือเปล่า เมื่อรันทดสอบอัตโนมัติบนคลาวด์ เขาพบว่าแม้มีหรือไม่มีสกิล Claude ก็ทำงานสำเร็จ 100 เปอร์เซ็นต์ แต่เมื่อโหลดสกิลเข้าไป AI token consumption กลับพุ่งขึ้น 50 ถึง 85 เปอร์เซ็นต์โดยไม่เพิ่มคุณภาพงานเลย นี่คือประโยคที่ควรจดจำไว้ในทุกทีมที่ใช้ AI ว่า "ภารกิจสำเร็จไม่เท่ากับคุ้มค่าทรัพยากร" สกิลที่ไม่จำเป็นเปลี่ยนจากตัวช่วยเป็นสัมภาระที่ยึดพื้นที่ context และหน่วงเวลาตอบสนองอย่างชัดเจน เมื่อลงลึกในเดสก์ท็อป เขาพบว่าเฉพาะงานที่ต้องอ่านไฟล์ในเครื่อง สกิลช่วยลดรอบสนทนาและ token ได้จริง แต่สำหรับงานเปลี่ยนชื่อธรรมดา สกิลกลับทำให้จำนวนรอบเพิ่มจาก 4 เป็น 7 และ token ใช้มากขึ้นเท่าตัว สิ่งนี้ชี้ชัดว่าการพยายามสั่งสอน MCP ที่ Claude ใช้เป็นอยู่แล้วคือการวาดงูเติมขา การเขียนสกิลควรเน้นเติมความสามารถที่โมเดลขาดเท่านั้น เช่น วิธีอ่านชื่อเซสชันจากไฟล์ในเครื่อง ไม่ใช่เขียนกฎทับความสามารถฐานที่มีอยู่แล้ว
ทำไมสกิลยิ่งเยอะ ยิ่งเสี่ยงให้ Claude เสื่อมสมรรถนะ
ปัญหาใหญ่ไม่ใช่แค่สกิลตัวเดียว แต่คือแนวคิดที่เชื่อว่าการขยายสกิลอย่างต่อเนื่องโดยไม่ประเมินผลจะให้ custom skills performance ดีขึ้น วิศวกรรายเดิมยอมรับว่าตัวเองแทบไม่รีวิวโค้ดสกิลที่ AI เขียนให้ ขอแค่รันได้ก็ถือว่าผ่าน ซึ่งพอเอาไปใช้จริงกลับกลายเป็นว่า AI ทำงานสำเร็จภายใต้ภาพลวงตาว่าทุกอย่างราบรื่น แต่เบื้องหลังค่าใช้จ่ายด้าน token และเวลาคำนวณถูกกินเงียบๆ อย่างต่อเนื่อง เมื่อสกิลหนึ่งมีคำอธิบายยืดยาว บวกกับสกิลเก่าที่ไม่ได้ปรับตามรุ่นโมเดลใหม่ เครื่องมือ MCP ใหม่ หรือ workflow ที่เปลี่ยน ความเสี่ยงคือกฎเก่าซ้อนกฎใหม่ เกิดการตีความซ้ำซ้อน จน Claude ต้องอ่านทะลุทุกสกิลที่โหลดเข้ามาก่อนตอบคุณทุกครั้ง หากไม่ตั้งกระบวนการวัดรอบสนทนาและ AI token consumption อย่างชัดเจน การเสื่อมสมรรถนะลักษณะ "งานสำเร็จแต่ต้นทุนพุ่ง" จะกัดกินทรัพยากรทีมแบบเนียนๆ ในระยะยาว นี่จึงเป็นเหตุผลว่าทำไม Anthropic แนะนำให้มองสกิลเป็นชุดเครื่องมือหรือผู้เชี่ยวชาญคนเล็กที่ต้องอัปเดตอยู่เสมอ ไม่ใช่ไฟล์ markdown ที่เขียนเสร็จแล้วเก็บถาวร เพราะสกิลที่ไม่ปรับตัวตามประสบการณ์ใช้จริงและการเปลี่ยนแปลงของระบบจะค่อยๆ เสื่อมคุณภาพและกลายเป็นแหล่งความคลาดเคลื่อนและความสิ้นเปลืองมากขึ้นเรื่อยๆ
แนวทางปฏิบัติ: ทดสอบ ตรวจสุขภาพสกิล และบันทึกข้อผิดพลาด
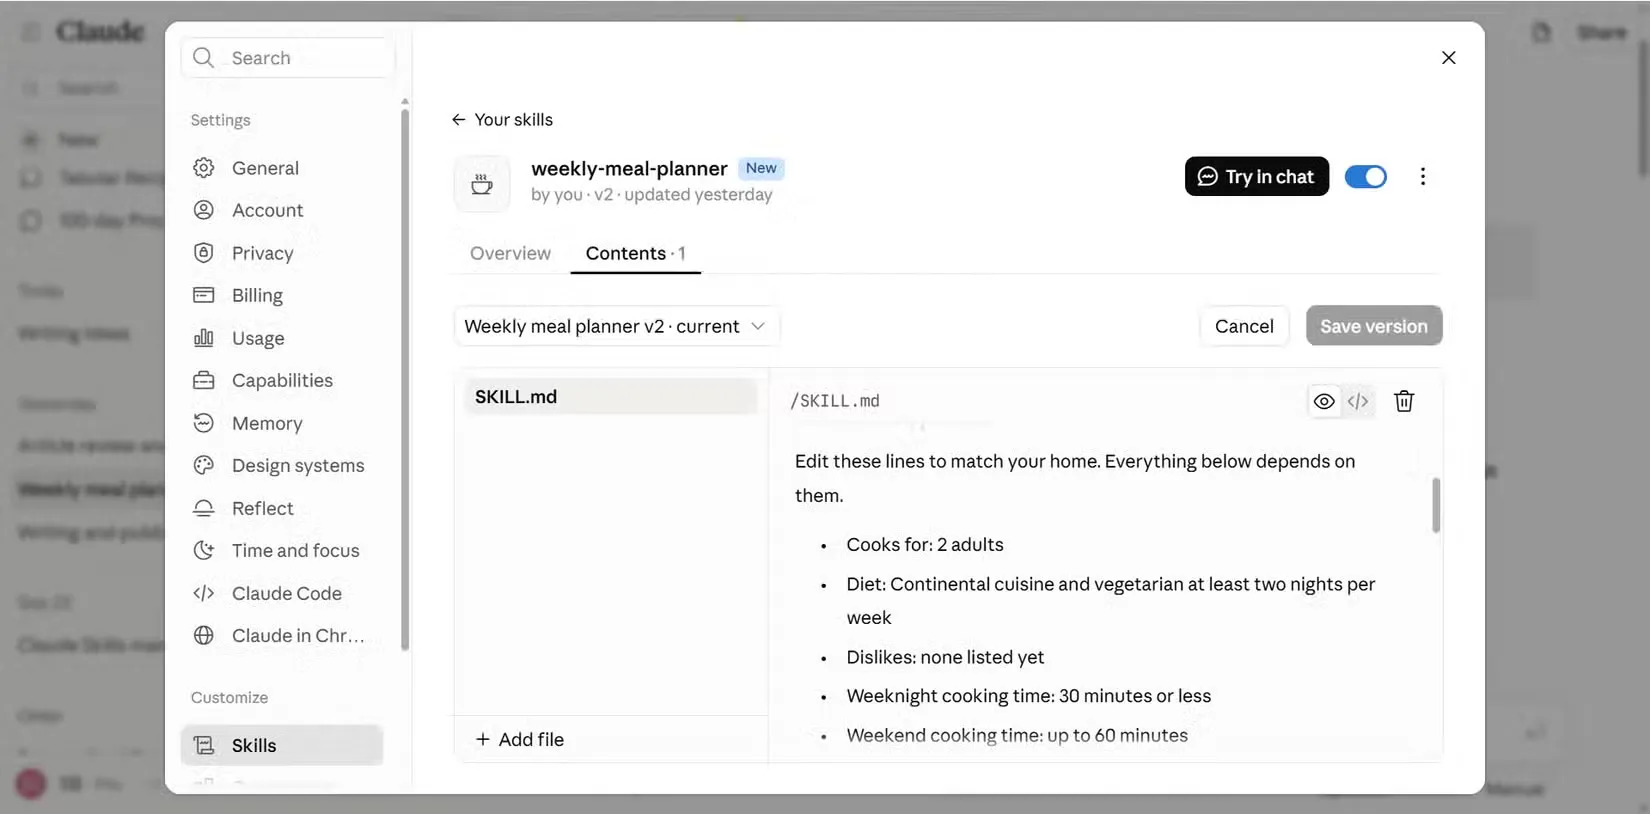
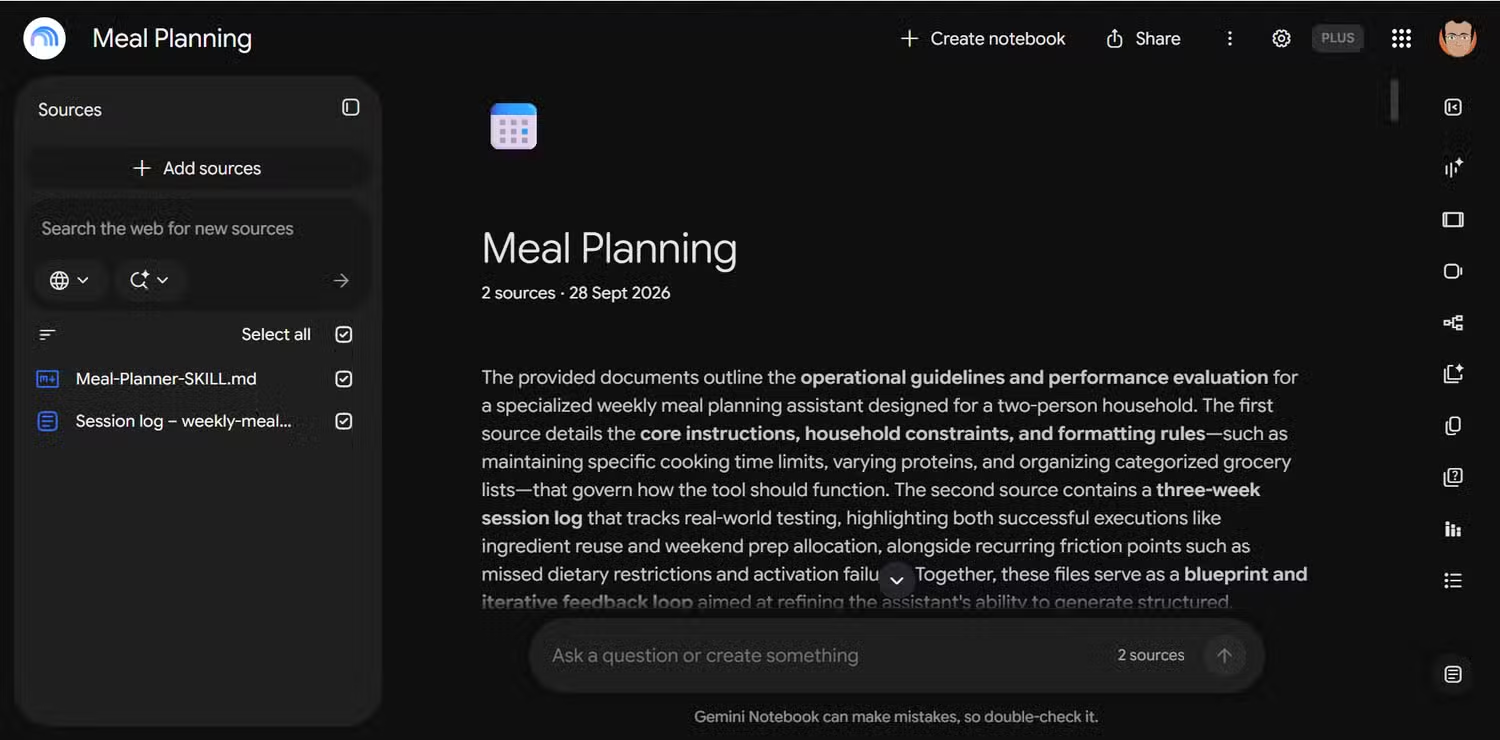
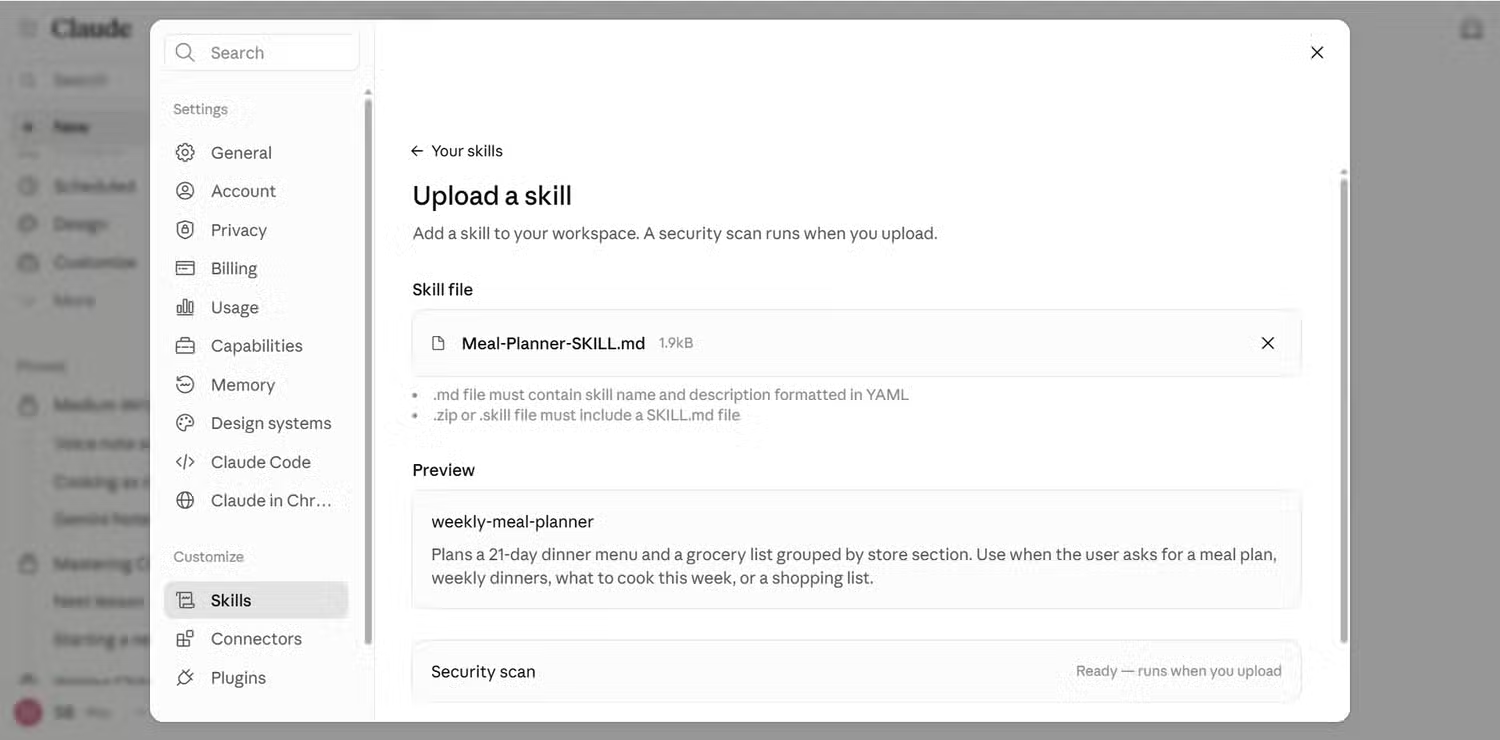
ทางออกไม่ได้อยู่ที่การเขียนสกิลเพิ่ม แต่คือวินัยในการทดสอบและคัดสรร Claude skills optimization ให้เหลือเท่าที่จำเป็น นักพัฒนาคนเดิมเสนอสามหลักการสำคัญ หนึ่ง ใช้หลัก "แทรกแซงให้น้อยที่สุด" เขียนสกิลเพื่อเติมความสามารถที่โมเดลไม่มี เช่นการอ่านไฟล์ในเครื่อง แทนการเขียน prompt ยืดยาวซ้ำสิ่งที่ MCP ทำได้อยู่แล้ว สอง บังคับให้มีระบบประเมินผลสำหรับสกิลที่อ้างว่าช่วยเพิ่มความสามารถ เขียนสคริปต์ทดสอบอัตโนมัติ วัดจำนวนรอบสนทนาและ token ก่อนและหลังโหลดสกิลอย่างสม่ำเสมอ สาม ตรวจและลบสกิลเก่าที่หน้าที่ถูกแทนด้วยความสามารถดั้งเดิมในรุ่นใหม่ เพื่อไม่ให้ AI Agent หลุดเข้าโหมด "ยิ่งขยายยิ่งเชื่องช้า" ในโลกการใช้สกิลกับงานทั่วไป แนวคิดนี้ไปไกลกว่าระดับโค้ด ตัวอย่างหนึ่งคือสกิลสร้างแผนอาหาร 21 วันตามความชอบ วัตถุดิบที่มี เวลาเตรียมอาหาร และจัดลิสต์ของซื้อพร้อมกันในตัว แทนการแก้กฎสกิลทุกครั้งที่มีปัญหา ผู้ใช้เลือกบันทึกข้อผิดพลาดและสิ่งที่ได้ผลดีในเอกสาร เช่น เมนูที่ต้องข้าม วัตถุดิบที่หาไม่ได้ เมนูที่ใช้เวลาทำนานหรือเหลืออาหารไม่พอ แล้วปล่อยให้เวลาผ่านไปเก็บตัวอย่างหลายสัปดาห์ จากนั้นค่อยนำไฟล์ SKILL และ log ไปให้ NotebookLM วิเคราะห์รู้แบบความคลาดเคลื่อนระหว่างกฎกับการใช้จริง เพื่อชี้จุดที่ควรแก้กฎและจัดลำดับความสำคัญ แนวทางนี้พลิกมุมมองจากการ "อัปเดตกฎเมื่อพลาดครั้งเดียว" มาเป็นการมองสกิลเป็นระบบที่ต้องดูหลักฐานซ้ำๆ ก่อนเพิ่มกฎใหม่ ทำให้เราหลีกเลี่ยงสกิลที่อ้วนด้วยเงื่อนไขจุกจิกแต่ไม่แก้ปัญหาจริง ใครใช้ Claude กับงานเอกสาร สามารถนำวิธีเดียวกันไปใช้ได้ เช่น เลือกหนึ่งสกิลที่ใช้บ่อย แล้วบันทึกคำผิด สำนวนองค์กรที่ต้องแก้ซ้ำ หรือ syntax ผิดในโค้ดให้เป็น log ก่อนค่อยใช้เครื่องมือวิเคราะห์มาช่วยบอกว่าควรปรับที่ตรงไหน
สรุป: ผลิตภาพที่แท้จริงมาจากการจัดระเบียบ ไม่ใช่สะสมสกิล
บทเรียนจากทั้งโลกการเขียนโค้ดและการวางแผนมื้ออาหารด้วย Claude สะท้อนภาพเดียวกันคือ การสะสมสกิลโดยไม่มีการคัดกรองคือทางลัดสู่ความเชื่องช้า AI ภายนอกอาจดูเหมือนทำงานเก่งขึ้น แต่เบื้องหลังคือ AI token consumption ที่บานปลายและเวลาคำนวณที่เพิ่มขึ้นโดยไม่จำเป็น หากเราไม่ยอมรับตรงๆ ว่า "สกิลบางอันควรถูกลบ" เราก็จะยังแบกสัมภาระที่เป็นข้อความหลาย KB เข้าไปในทุกบริบทงานโดยไม่รู้ตัว แนวทางที่ให้ผลจริงจึงไม่ใช่การนับจำนวนสกิล แต่คือการดูแลคุณภาพสกิลอย่างต่อเนื่อง ตั้งต้นจากการรีแฟกเตอร์สกิลให้เฉพาะเจาะจงกับความสามารถที่ขาด เช่นการแปลงสกิลยาว 139 บรรทัดเป็นสกิลอ่านชื่อเซสชันสั้นเพียง 29 บรรทัดและ 1.3 KB เพื่อกำจัดคำสั่งเปลี่ยนชื่อที่ไม่จำเป็นออกไป ควบคู่กับการใช้บันทึกการใช้งานจริงและเครื่องมืออย่าง NotebookLM มาช่วยวิเคราะห์ว่ากฎไหนช่วย กฎไหนเกะกะ แล้วอัปเดตสกิลด้วยการปรับเล็กน้อยแต่แม่นยำแทนการเพิ่มข้อความยาวๆ ทับไปเรื่อยๆ หากคุณมอง Claude skills optimization เป็นงานบำรุงรักษาระยะยาวเหมือนดูแลโค้ดโปรดักชัน ไม่ใช่งานแต่ง prompt ครั้งเดียวแล้วจบ คุณจะได้ AI ที่ตอบสนองเร็วขึ้น ใช้ทรัพยากรคุ้มค่า และสอดคล้องกับพฤติกรรมการทำงานจริงของคุณมากกว่าการเร่งสะสมจำนวนสกิลโดยไม่มีการตรวจสุขภาพ