
เริ่มจากสิ่งที่ต้องการนำไปใช้งาน
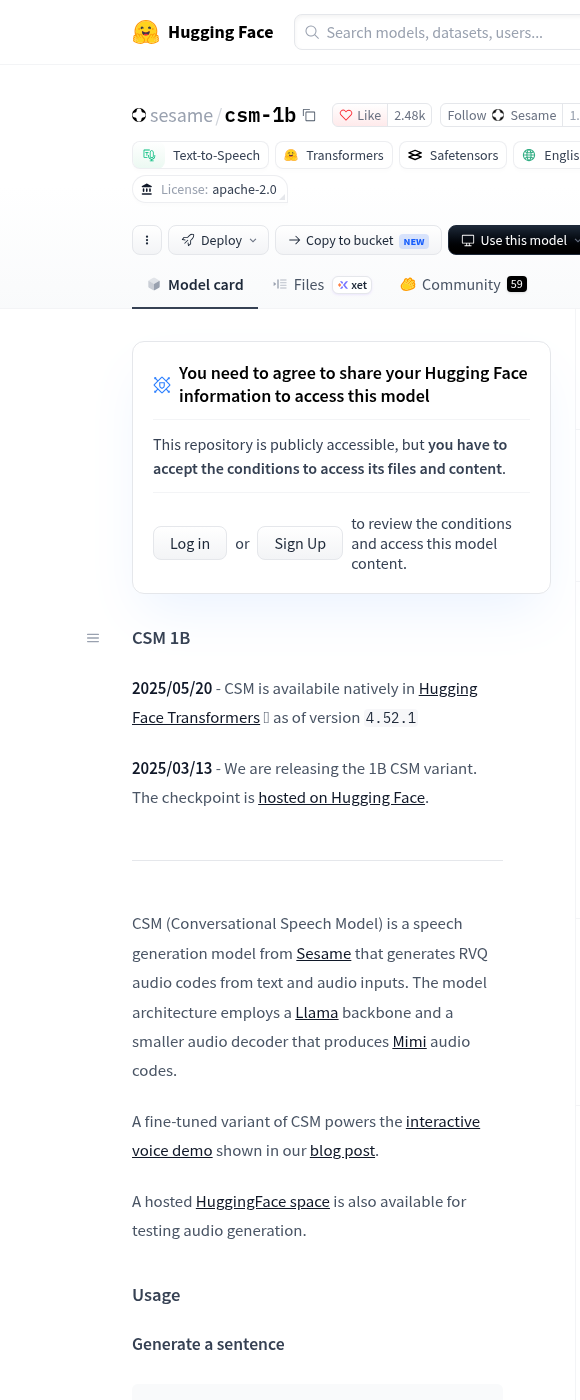
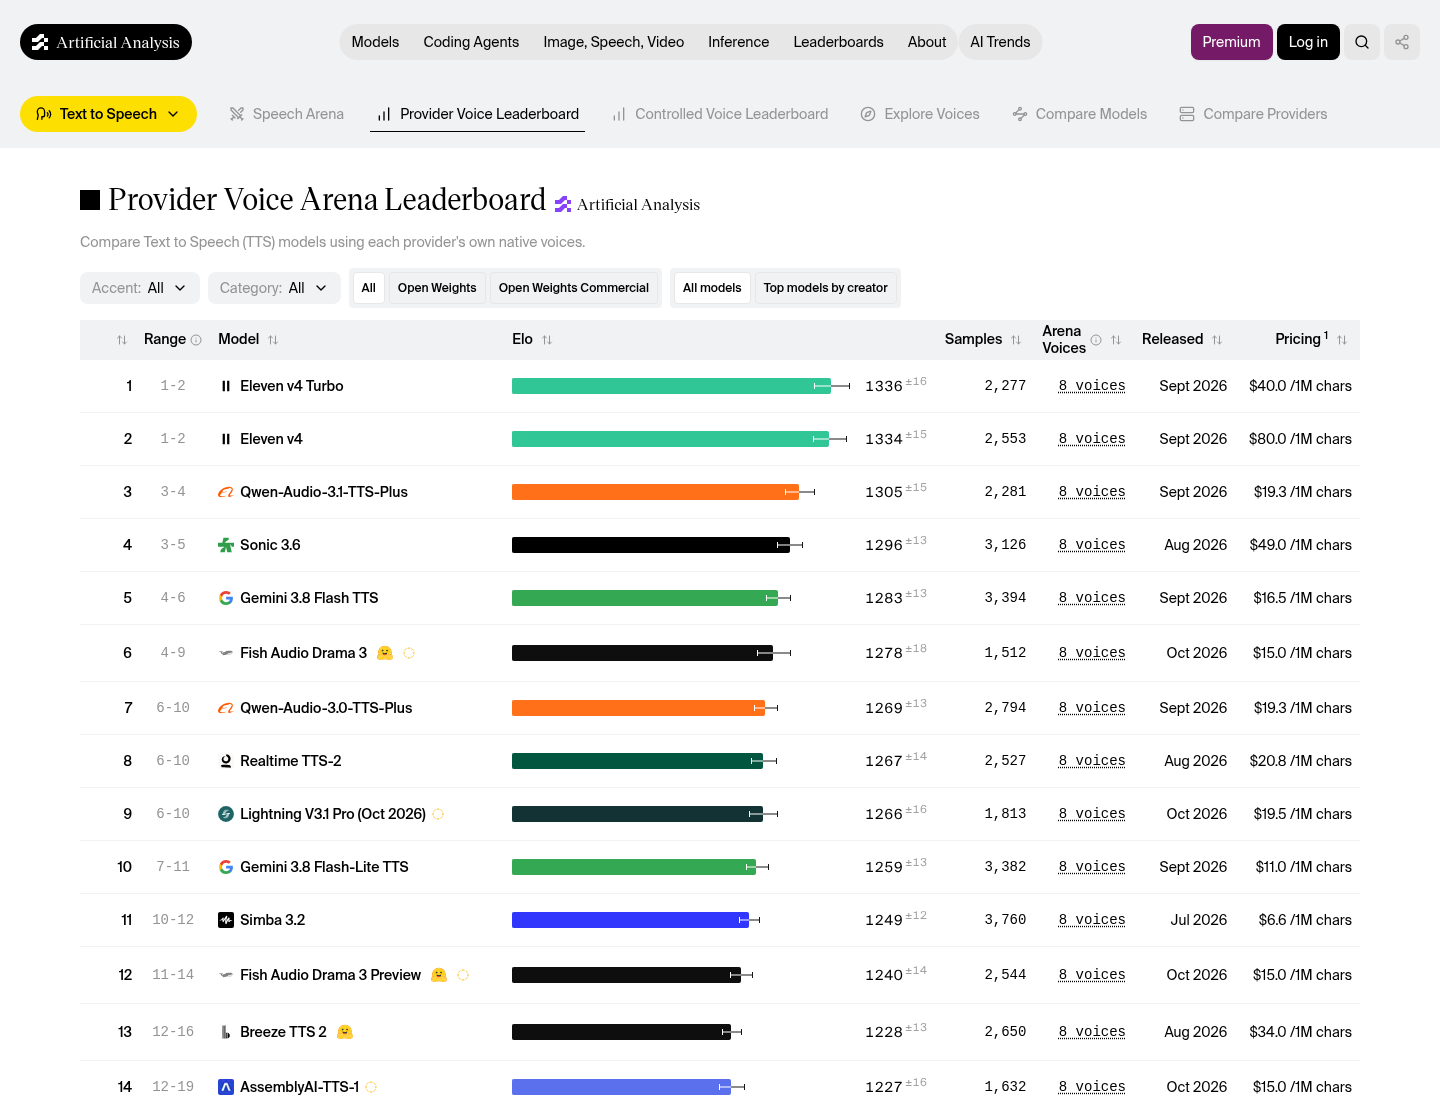
โมเดลแปลงข้อความเป็นเสียงคือระบบที่เปลี่ยนข้อความหรือบริบทการสนทนาให้เป็นเสียงพูด โดยอาจดาวน์โหลดมาติดตั้งในระบบของตนเอง หรือเรียกใช้ผ่านบริการที่ผู้ให้บริการดูแลโครงสร้างพื้นฐานให้ ถ้าต้องการควบคุมเสียง ข้อมูล และการติดตั้งเอง Ming-3.0-tts หรือ LFM3-Audio-2B เหมาะกว่า แต่ต้องมีทีมดูแลโมเดลและเครื่องประมวลผล ส่วนงานที่ต้องเปิดใช้ API ได้เลย Rime Prism และ AssemblyAI-TTS-1 เป็นบริการสร้างเสียง AI ที่ตรงโจทย์กว่า ส่วน Sesame Preview เหมาะสำหรับทดลองฟังและสัมผัสประสบการณ์สนทนา ไม่ใช่ API ที่นำไปฝังในผลิตภัณฑ์ได้ การเลือกจึงไม่ควรยึดเสียงตัวอย่างอย่างเดียว แต่ต้องดูสิทธิ์ใช้งาน ความหน่วง ความเป็นส่วนตัว และค่าใช้จ่ายในการดูแลระบบตลอดอายุงานด้วย
โมเดลที่เป็นเจ้าของ กับแอปที่ใช้ได้ทันที
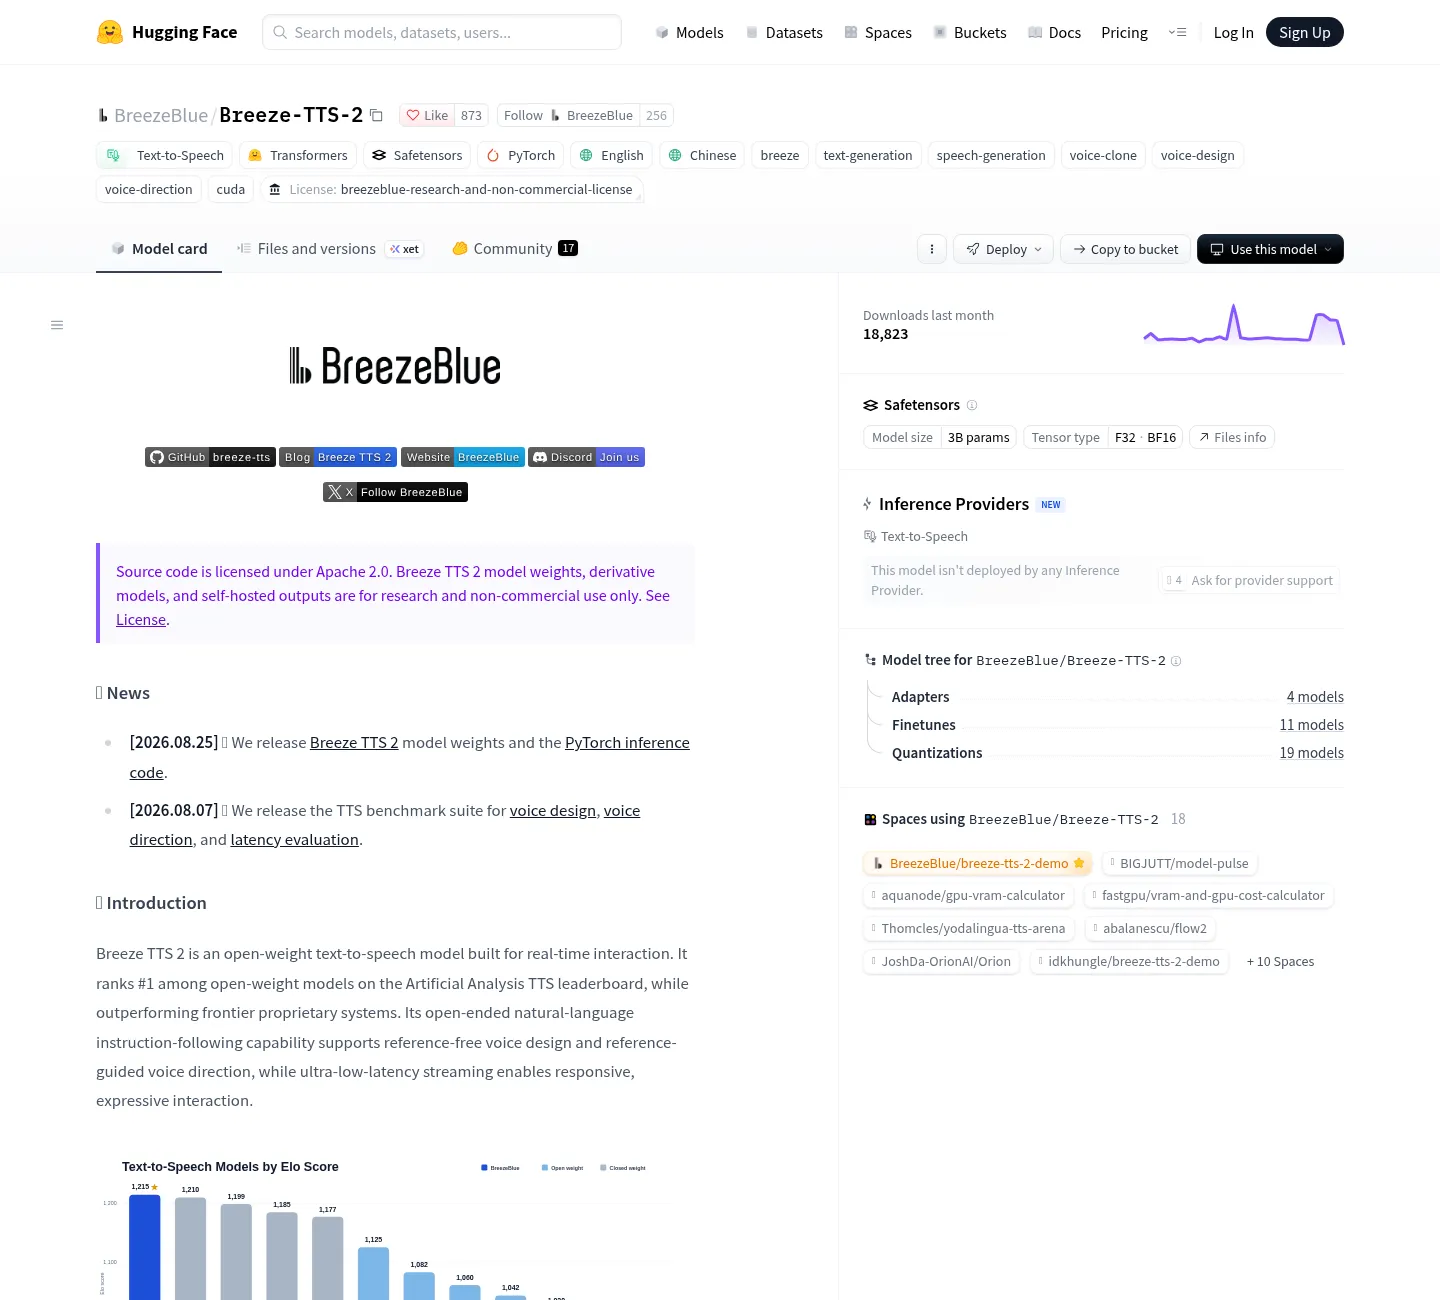
Ming-3.0-tts เป็นโมเดลเสียงแบบเปิดน้ำหนักจากทีม inclusionAI ของ Ant Group และโฮสต์โมเดลเสียงเองได้ภายใต้สัญญาอนุญาต MIT โดยรุ่น Ming-3.0-tts-0.5B เป็นโมเดลแบบ dense บนแบ็กโบน Qwen2.5-0.5B พร้อมหัว DiT และตัวแยกโทเค็นเสียง มีขนาดประมาณ 2.96 GB จุดแข็งคือการควบคุม: โคลนเสียงอ้างอิง ออกแบบเสียงจากข้อความ และกำกับเสียงหัวเราะหรือการถอนหายใจได้ หากต้องการเสียงตามสคริปต์และเงื่อนไขที่กำหนด Ming ให้พื้นที่ทำงานมากกว่า แต่ผู้ใช้ต้องจัดการการติดตั้งและการให้บริการเอง Sesame Preview เป็นแอปฟรีที่มีบุคลิกสนทนา 4 แบบ ไม่ใช่โมเดลที่เปิดให้ดาวน์โหลดหรือ API เสียงสำหรับนักพัฒนา เสียงระดับโปรดักชันเบื้องหลังแอปไม่ได้เปิดเผยให้ใช้งาน จุดเด่นคือประสบการณ์สนทนาที่พร้อมใช้และความหน่วงต่ำ แต่แลกกับการควบคุมระบบและการนำเสียงไปฝังในผลิตภัณฑ์ไม่ได้ หากต้องการ voice agent ที่จัดการบทสนทนา Sesame เป็นตัวเลือกในคู่นี้ที่ตอบโจทย์กว่า ส่วน Ming เหมาะกับผู้ที่ต้องการเสียงตามคำสั่งอย่างแม่นยำ
| ประเด็น | Ming-3.0-tts | Sesame Preview |
|---|---|---|
| รูปแบบ | โมเดลเสียงเปิดน้ำหนัก ดาวน์โหลดและโฮสต์เองได้ | แอปเดโมสำหรับผู้บริโภค ไม่ใช่โมเดลที่เปิดให้ใช้ผ่าน API |
| การควบคุม | โคลนเสียง ออกแบบเสียง และกำกับลักษณะการพูดได้ | ใช้บุคลิกเสียงและประสบการณ์สนทนาที่แอปกำหนด |
| การเชื่อมต่อ | ไม่มีเอนด์พอยต์เสียงพูดบนแพลตฟอร์มที่กล่าวถึง | ไม่มี API สาธารณะสำหรับเสียงระดับโปรดักชัน |
| ความหน่วง | ต้องปรับใช้และวัดผลในระบบของตน | ได้เปรียบด้านความหน่วงเมื่อเทียบกับ Ming |
| การใช้งานเหมาะกับ | ทีมที่ต้องการควบคุมโมเดลและติดตั้งภายใน | ผู้ใช้ที่ต้องการทดลองประสบการณ์ voice agent พร้อมใช้ |
ผลทดสอบ Controlled Voice Arena ของ Artificial Analysis ให้ Ming 1,069 Elo เป็นอันดับหนึ่งในกลุ่มโมเดล open-weight และราวอันดับ 13 โดยรวม แต่ผลนี้วัดเสียงในเงื่อนไขทดสอบ ไม่ได้แปลว่าจะชนะทุกงานจริง และไม่มีเอนด์พอยต์ของทั้ง Ming หรือ Sesame บนแพลตฟอร์มที่กล่าวถึง
ทางเลือกสำหรับทีมที่ต้องการดาวน์โหลดหรือเรียก API
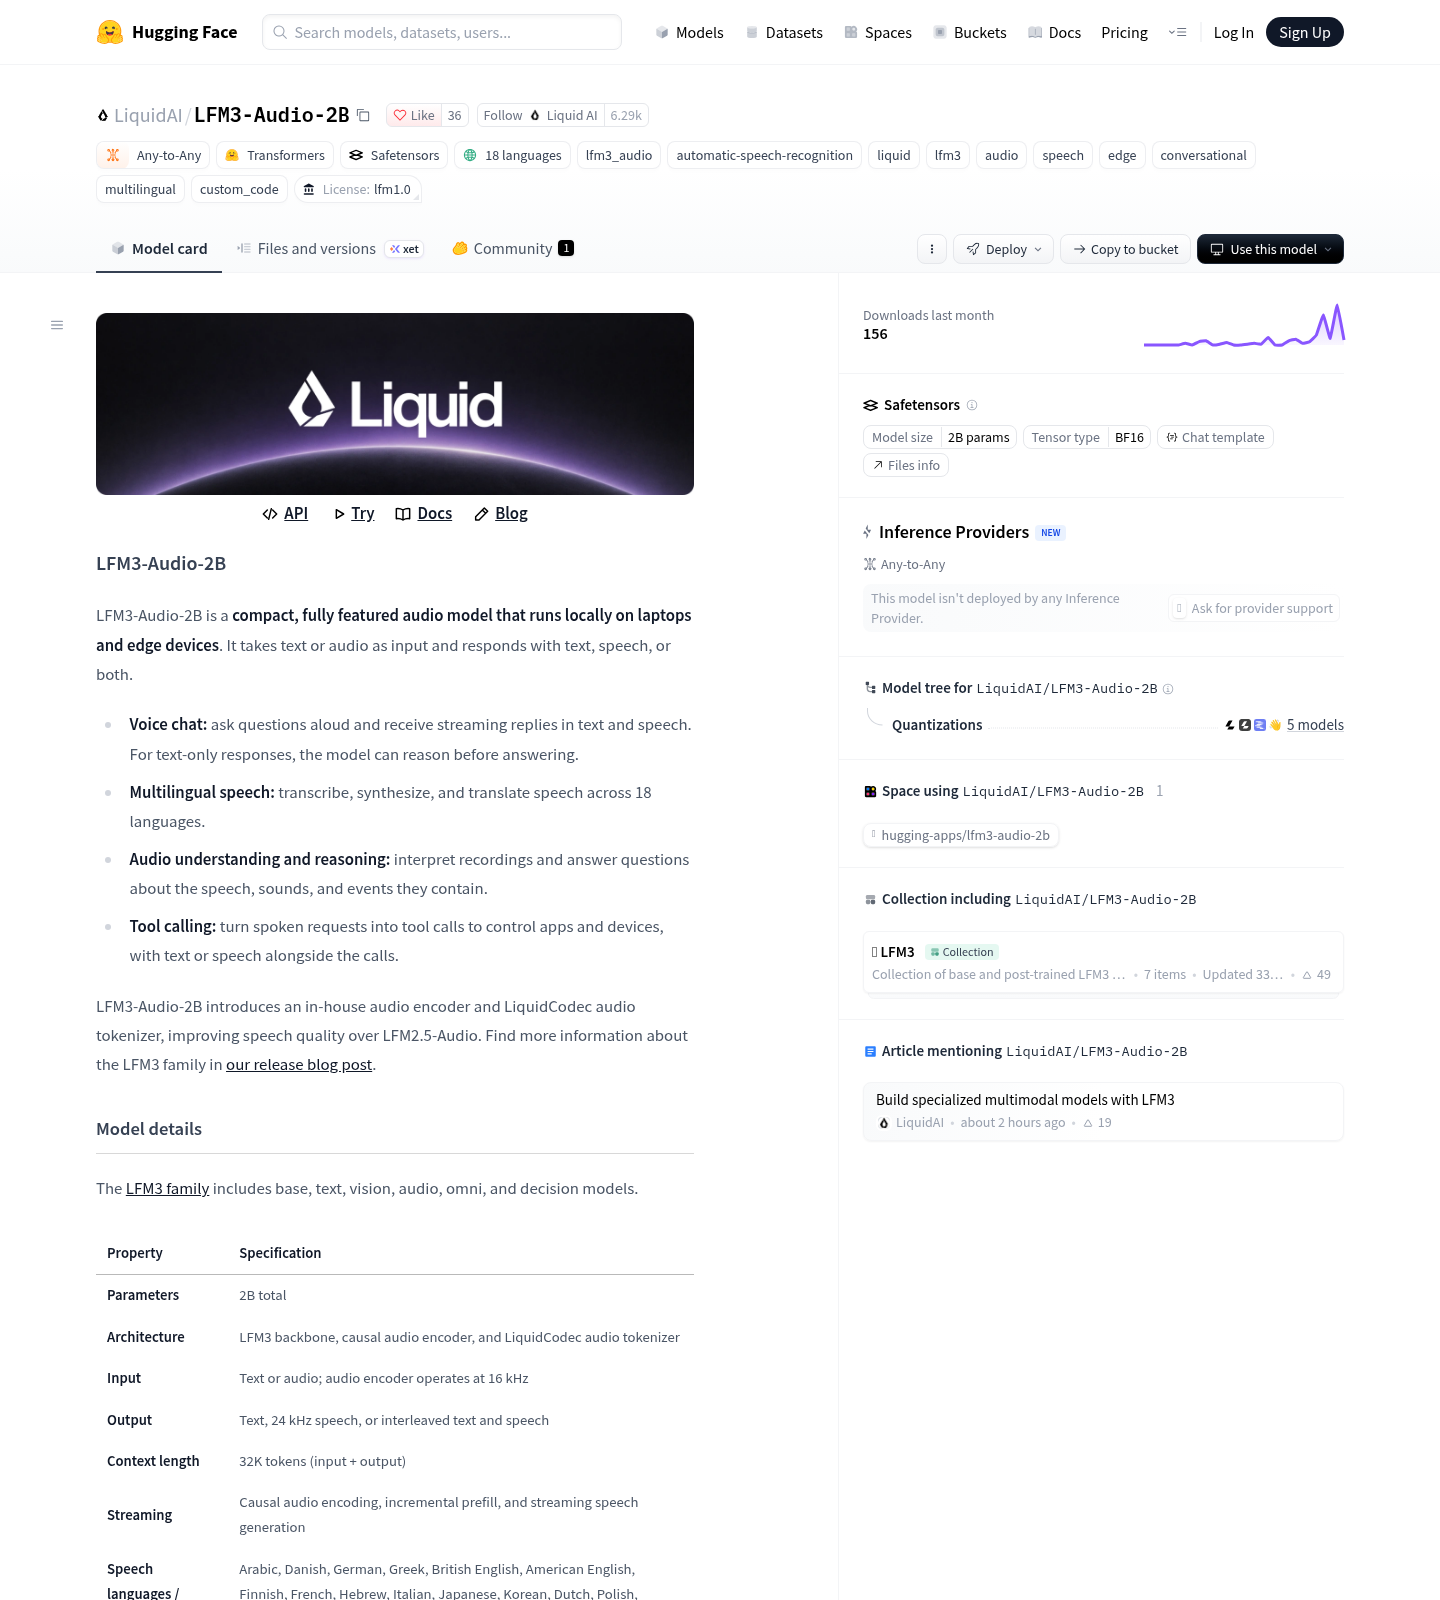
LFM3-Audio-2B เป็นเช็กพอยต์ขนาด 2B ที่ดาวน์โหลดไปรันบนแล็ปท็อปได้ และมีเส้นทางใช้งานหลายแบบ รวมถึง Transformers, llama.cpp, MLX บน Apple silicon และ ONNX Runtime จึงน่าสนใจสำหรับทีมที่ต้องการติดตั้งเองโดยไม่เริ่มจากระบบเสียงที่ปิดทั้งหมด อย่างไรก็ดี ตารางประสิทธิภาพที่เผยแพร่มีหกแถวและเทียบกับ LFM2.5-Audio-1.5B โดยไม่มีการทำซ้ำจากบุคคลที่สามสำหรับแถวใด จึงควรมองตัวเลขเป็นข้อมูลจากผู้ขาย ไม่ใช่หลักประกันผลลัพธ์จริง นอกจากนี้ ASR แบบเรียลไทม์รองรับเฉพาะภาษาอังกฤษ คอนเท็กซ์มี 32K โทเค็น และเงื่อนไขสิทธิ์เชิงพาณิชย์ต้องตรวจสอบตามรายได้ขององค์กร
ถ้าไม่ต้องการดูแลเครื่องเอง Rime Prism เป็น API แบบมีแพ็กเกจฟรีและแบบคิดค่าบริการ โดยเป็นโมเดล speech-to-speech ที่เน้นการสนทนา จุดต่างที่มีประโยชน์คือระบบสร้างคำตอบเป็นข้อความก่อนพูด แอปจึงตรวจนโยบายหรือกรองข้อมูลส่วนบุคคลจากประโยคได้ก่อนปล่อยเสียง และยังรับฟังต่อระหว่างนั้นได้ อย่างไรก็ตาม ทั้ง Prism และ Sesame Preview ไม่อยู่ใน Speech-to-Speech Index ของ Artificial Analysis จึงยังไม่มีข้อมูลในดัชนีนั้นให้ใช้เทียบกันโดยตรง AssemblyAI-TTS-1 เป็น API แปลงข้อความเป็นเสียงที่พร้อมใช้งานทั่วไปและสตรีมผ่าน HTTP หรือ WebSocket ส่วนข้อจำกัดคือเป็นบริการแบบคิดค่าใช้จ่ายและมีทางเลือกด้านภูมิภาคให้ตรวจสอบก่อนออกแบบระบบ ต่างจาก Sesame Preview ที่ไม่มี endpoint หรือรายการราคาสำหรับนักพัฒนา
| ตัวเลือก | วิธีใช้งาน | ข้อแลกเปลี่ยนที่ควรชั่งใจ |
|---|---|---|
| LFM3-Audio-2B | ดาวน์โหลดและรันเอง | คะแนนประสิทธิภาพมาจากผู้ขาย และมีข้อจำกัดด้านภาษาและสิทธิ์ |
| Rime Prism | API สำหรับเสียงสนทนา มีแพ็กเกจฟรี | ต้องทดสอบคุณภาพและรูปแบบค่าใช้จ่ายกับงานจริง |
| AssemblyAI-TTS-1 | API สตรีมผ่าน HTTP และ WebSocket | ค่าใช้จ่ายคิดตามตัวอักษรและมีตัวเลือกภูมิภาคที่ต้องพิจารณา |
| Sesame Preview | แอปเดโมสำหรับผู้บริโภค | ไม่มี API เสียงระดับโปรดักชันให้เชื่อมต่อ |
ตัดสินใจจากความเป็นส่วนตัว ต้นทุน และภาระดูแล
การโฮสต์เองช่วยให้เสียงและข้อมูลอยู่ในขอบเขตระบบที่ทีมควบคุมได้ เหมาะกับข้อมูลอ่อนไหวหรือข้อกำหนดด้านการเก็บรักษาข้อมูล แต่ความเป็นส่วนตัวจะเกิดขึ้นจริงก็ต่อเมื่อทีมจัดการบันทึกเสียง การเข้าถึง และการรักษาความปลอดภัยของเครื่องได้ดีด้วย ขณะเดียวกัน ภาระค่าใช้จ่ายไม่ได้จบที่การดาวน์โหลดโมเดล เพราะต้องคิดถึงกำลัง GPU เวลาวิศวกร การปรับขนาดระบบ และการดูแลเมื่อมีโหลดเพิ่ม บริการ API ลดภาระตั้งต้นและทำให้ทดลองเปิดใช้งานได้เร็วกว่า แต่ต้นทุนผูกกับปริมาณการใช้งานและเงื่อนไขผู้ให้บริการ จึงควรทดสอบค่าใช้จ่ายจากปริมาณคำขอจริง แทนการเทียบราคาอย่างเดียว สำหรับ Sesame Preview ให้ถือเป็นเครื่องมือดูประสบการณ์และความหน่วง ไม่ใช่แผนสำรองสำหรับระบบผลิต เพราะยังไม่มี endpoint สาธารณะ ส่วนการประเมินความหน่วงของโมเดลที่โฮสต์เองต้องวัดบนฮาร์ดแวร์และเครือข่ายของทีม ไม่ควรนำตัวเลขจากแอปมาใช้แทน
คำตอบว่าโฮสต์เองเหมาะหรือไม่จะมีน้ำหนักเมื่อทีมต้องการภาษาอังกฤษเท่านั้น มี GPU พร้อมวิศวกรที่ดูแลได้ และต้องการให้โมเดลอยู่ภายในขอบเขตระบบของตน หากขาดข้อใดข้อหนึ่ง บริการ API มักลดงานปฏิบัติการได้มากกว่า ส่วน LFM3-Audio-2B ควรผ่านการทดสอบของทีมก่อนตัดสินใจ เนื่องจากคะแนนที่ระบุยังไม่มีพยานอิสระมายืนยัน
Buy if / Skip if
- Buy the Ming-3.0-tts if ต้องการโฮสต์เอง ควบคุมการสร้างเสียง และมีทีมดูแลระบบประมวลผล
- Skip the Ming-3.0-tts if ต้องการ API พร้อมใช้หรือไม่ต้องการรับภาระติดตั้งและปรับระบบ
- Buy the Sesame Preview if ต้องการทดลอง voice agent และประสบการณ์สนทนาผ่านแอป
- Skip the Sesame Preview if ต้องการดาวน์โหลดโมเดล เชื่อมต่อ API หรือใช้เสียงในผลิตภัณฑ์ของตน
- Buy the LFM3-Audio-2B if ต้องการโมเดลดาวน์โหลดและรับได้กับการตรวจสอบคะแนนด้วยการทดสอบของทีมเอง
- Skip the LFM3-Audio-2B if ต้องพึ่งคะแนนที่ผ่านการยืนยันจากบุคคลที่สาม หรือต้องใช้ ASR แบบเรียลไทม์ในภาษาอื่นนอกจากอังกฤษ
- Buy the Rime Prism if ต้องการ API สนทนาและเห็นคุณค่าของการตรวจข้อความก่อนสร้างเสียง
- Skip the Rime Prism if ยังยืนยันคุณภาพและค่าใช้จ่ายกับรูปแบบงานจริงไม่ได้
- Buy the AssemblyAI-TTS-1 if ต้องการบริการสตรีมเสียงผ่าน HTTP หรือ WebSocket
- Skip the AssemblyAI-TTS-1 if ต้องการโฮสต์โมเดลภายในหรือไม่มีแผนรองรับค่าใช้จ่ายตามการใช้งาน