
AI vulnerability detection คืออะไร และข้อค้นพบหลักจากการทดสอบของ AWS
AI vulnerability detection คือการใช้โมเดลปัญญาประดิษฐ์วิเคราะห์ซอร์สโค้ดหรือสภาพแวดล้อมระบบเพื่อระบุจุดอ่อนที่อาจถูกโจมตี โดยพยายามแยกแยะว่าบล็อกโค้ดใดเป็นช่องโหว่จริง บล็อกใดปลอดภัย และช่องโหว่ใดสามารถถูกนำไปใช้ในโลกจริงได้ เป้าหมายคือช่วยทีมความปลอดภัยลดภาระการตรวจสอบด้วยมือ แต่หากความแม่นยำไม่พอ เครื่องมือแบบนี้อาจกลายเป็นภาระเพิ่มมากกว่าช่วยงาน เมื่อผู้ให้บริการคลาวด์รายใหญ่ประกาศเกณฑ์ Deception Benchmark เพื่อตรวจสอบความสามารถ AI security testing ในการตัดสินใจเรื่องช่องโหว่ โดยทดสอบโมเดลอเนกประสงค์ชั้นนำ 12 ตัวจาก 5 ราย พบว่าแม้ทุกโมเดลจะค้นพบช่องโหว่จริงส่วนใหญ่ แต่ปัญหา false positive rate และการรายงานตกหล่นยังสูงจนไม่น่าใช้แทนการประเมินด้วยผู้เชี่ยวชาญได้
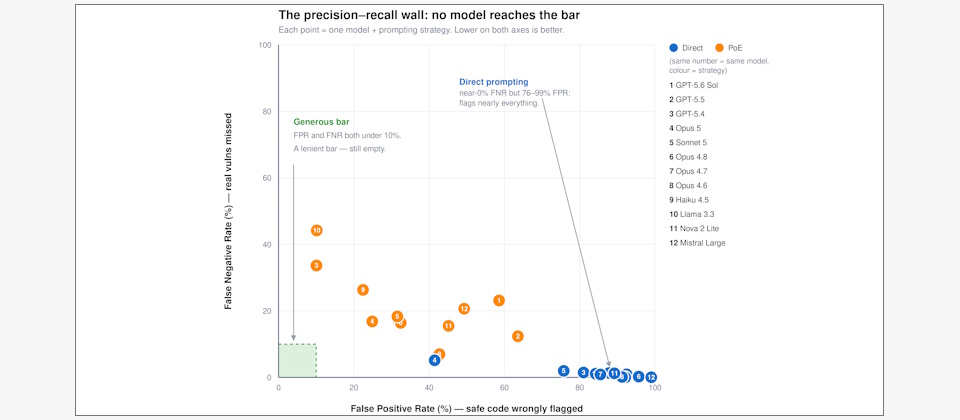
ตัวเลขที่น่ากังวล: เมื่อ false positive สูง และช่องโหว่จริงหลุดรอด
เกณฑ์ Deception Benchmark ใช้สองแนวทางคือให้โมเดลตัดสินใจตรงไปตรงมา และใช้คำสั่งแบบ Proof-of-Exploit หรือ PoE ที่บังคับให้โมเดลแสดงหลักฐานว่าช่องโหว่ถูกโจมตีได้จริง เพื่อวัด AI model accuracy อย่างเป็นระบบ ในโหมดตัดสินใจตรง โมเดลที่ทำได้ดีที่สุดสามารถค้นพบราว 95% ของช่องโหว่จริง แต่แลกมากับการตีโค้ดปลอดภัยให้เป็นช่องโหว่ถึง 41% ถึง 99% สะท้อนว่า false positive rate สูงจนวิศวกรต้องเสียเวลาตรวจสอบผลลวงจำนวนมาก เมื่อบังคับให้แสดง PoE ผลลวงลดลง 17 ถึง 74 จุดเปอร์เซ็นต์ แต่ต้องยอมให้ช่องโหว่จริงหลุดรอด 7% ถึง 44% ซึ่งในโลกความปลอดภัยที่ผู้โจมตีต้องการแค่ช่องโหว่เดียว ตัวเลขระดับนี้ถือว่าน่ากังวลอย่างมากสำหรับการใช้เป็นเครื่องมือหลักในการประเมินช่องโหว่
| โมเดล / วิธี | ความแม่นยำรวม | false positive | false negative |
|---|---|---|---|
| Claude Opus 5 + PoE | 79.3% | 24.9% | 16.8% |
| GPT-5.4 + PoE | 77.7% | 10.1% | 33.6% |
ช่องว่างระหว่างความสามารถในห้องทดลองกับความต้องการด้านความปลอดภัยจริง
เมื่อดูตัวเลขโดยรวม Claude Opus 5 ในโหมด PoE มีความแม่นยำสูงสุดที่ 79.3% ส่วน GPT-5.4 ในโหมดเดียวกันได้ 77.7% แต่ทั้งคู่ยังมีทั้ง false positive และ false negative ในระดับที่องค์กรจริงยอมรับได้ยากสำหรับงานประเมินช่องโหว่เชิงผลิต นั่นสะท้อนภาพชัดว่า AI security testing วันนี้ยังติดอยู่ในช่วงกึ่งทดลอง คือแสดงศักยภาพได้ดีในเชิงการค้นเบาะแสช่องโหว่ แต่ยังไม่พอสำหรับการตัดสินใจชี้ขาดว่าช่องโหว่ใดต้องแก้ และช่องโหว่ใดไม่มีผลในสภาพแวดล้อมจริง สิ่งที่เกณฑ์นี้ยังไม่ครอบคลุมคือระบบเฉพาะทางที่ใช้การยืนยันหลายขั้นตอนหรือผสานกับเครื่องมืออื่น ทำให้ตัวเลขอาจดีขึ้นในบางบริบท แต่สำหรับโมเดลอเนกประสงค์แบบโต้ตอบรอบเดียว ผลการทดสอบบอกเราตรงๆ ว่าการหวังให้ AI กลายเป็นเครื่องมือประเมินช่องโหว่แบบใช้งานจริงโดยลำพังยังเร็วเกินไป
มุมมองจากโลกการเขียนโค้ดด้วย AI: เมื่อช่องโหว่เกิดจากโค้ดที่เราไม่เข้าใจดีพอ
ข้อค้นพบเรื่องความแม่นยำของ AI vulnerability detection สอดคล้องกับประเด็นที่ผู้เชี่ยวชาญด้านสถาปัตยกรรมซอฟต์แวร์เตือนเกี่ยวกับการใช้ AI เขียนโค้ด เมื่อโค้ดจำนวนมากถูกสร้างโดยเครื่องมืออัตโนมัติ คนพัฒนากลับมีระยะห่างทางความคิดกับสิ่งที่ถูกสร้าง ทำให้การรีวิวและการทดสอบยากขึ้น โดยเฉพาะระบบที่ทดสอบได้ลำบากอย่างระบบกระจายหรือมีความไม่กำหนดแน่นอนสูง ซึ่งเปิดช่องให้บั๊กด้านดีไซน์และช่องโหว่เล็ดลอดเข้าไปโดยไม่มีใครทันสังเกต แนวคิดเรื่องการทดสอบอย่างจริงจัง การสร้างแบบจำลองอย่างเป็นทางการ และการใช้เทคนิคอย่าง mutation testing เพื่อวัดคุณภาพชุดทดสอบ จึงยิ่งสำคัญเมื่อโค้ดและผลสแกนมาจาก AI ทั้งสองฝั่ง การปล่อยให้โค้ดที่เราไม่ได้ออกแบบเองอย่างละเอียด เข้าสู่ระบบโดยไม่มีการตรวจสอบที่เข้มงวด เป็นการเพิ่มพื้นผิวโจมตีโดยไม่จำเป็น และขัดกับความจริงด้านความปลอดภัยที่ผู้ป้องกันต้องปิดทุกช่อง ในขณะที่ผู้โจมตีต้องการแบช่องเดียวเท่านั้น
ข้อคิดเชิงปฏิบัติ: ใช้ AI เป็นตัวช่วย ไม่ใช่ด่านสุดท้ายด้านความปลอดภัย
เมื่อดูทั้งผลการทดสอบและมุมมองจากคนทำระบบ สิ่งที่ชัดที่สุดคือองค์กรไม่ควรพึ่งพา AI vulnerability detection เป็นเครื่องมือชี้ขาดด้านความปลอดภัย แต่ควรมองว่าเป็นตัวช่วยเปิดประเด็นที่มนุษย์จะเข้าไปตรวจสอบต่อ แนวทางปฏิบัติที่เหมาะสมคือให้ AI ดึงโค้ดหรือส่วนระบบที่น่าสงสัยออกมา จากนั้นให้วิศวกรความปลอดภัยหรือสถาปนิกซอฟต์แวร์วิเคราะห์ด้วยชุดทดสอบและกระบวนการยืนยันที่เชื่อถือได้ การรับความจริงว่า AI security testing ยังมีขีดจำกัดคือก้าวแรกที่สำคัญ องค์กรควรลงทุนในการออกแบบดีตั้งแต่ต้น สร้างชุดทดสอบที่เน้นพฤติกรรมสำคัญ ใช้เครื่องมือวิเคราะห์เพิ่มเติม และสร้างวัฒนธรรมที่มองโค้ดที่มาจาก AI ด้วยสายตาวิพากษ์ การผสมผสานความเร็วจาก AI กับความละเอียดของมนุษย์ คือทางเดียวที่จะลดความเสี่ยงจากทั้ง false positive ที่ทำให้เสียเวลา และช่องโหว่จริงที่อาจหลุดรอดไปถึงระบบผลิต