
Gemma AI สมาร์ทโฟนคืออะไร และทำไมการประมวลผลบนอุปกรณ์จึงสำคัญ
Gemma AI สมาร์ทโฟนคือแนวคิดการนำโมเดล AI ขนาดเล็กที่รองรับข้อความ ภาพ เสียง วิดีโอ และโค้ด มารันโดยตรงบนสมาร์ทโฟนหรืออุปกรณ์ปลายทาง โดยไม่ต้องพึ่งการเชื่อมต่อคลาวด์ ทำให้การตอบสนองเร็วขึ้น ลดการส่งข้อมูลออกจากเครื่อง และเปิดทางให้ผู้ใช้ควบคุมความเป็นส่วนตัวของตนเองมากขึ้น เหมาะกับยุคที่ผู้คนต้องการฟีเจอร์อัจฉริยะตลอดเวลาแม้ไม่มีอินเทอร์เน็ต และต้องการให้ข้อมูลส่วนตัวอยู่ในมือของตัวเอง
จุดสำคัญของการประมวลผลบนอุปกรณ์คือการเปลี่ยนสมาร์ทโฟนจากเครื่องรับคำสั่งให้กลายเป็นศูนย์กลาง AI multimodal ท้องถิ่น ที่คิด วิเคราะห์ และเข้าใจบริบทได้เอง การที่ Google เลือกลงทุนในโมเดล AI ขนาดเล็กที่รันได้บนสมาร์ทโฟนจึงไม่ใช่เรื่องเทคโนโลยีอย่างเดียว แต่เป็นการตอบรับความคาดหวังของผู้ใช้ที่ต้องการความเร็ว ความเป็นส่วนตัว และความสามารถขั้นสูงในเครื่องเดียว การแข่งขันกับโมเดลอย่าง GPT-4o mini ทำให้เห็นชัดว่าศึกต่อไปไม่ใช่แค่ใครฉลาดกว่า แต่ใครฉลาดได้โดยไม่ต้องพึ่งคลาวด์
EmbeddingGemma 2 โมเดล AI ขนาดเล็กที่ออกแบบมาเพื่อสมาร์ทโฟนจริง ๆ
EmbeddingGemma 2 คือโมเดล AI ขนาดเล็กที่ถูกออกแบบมาให้ทำงานบนฮาร์ดแวร์สมาร์ทโฟนโดยตรง ด้วยขนาดเพียง 740 ล้านพารามิเตอร์และรองรับบริบทสูงสุด 8,000 โทเคน ทำให้สามารถรับมือข้อมูลหลากหลายรูปแบบได้โดยไม่ต้องพึ่งคลาวด์จากภายนอก นี่ไม่ใช่เรือธงที่กินทรัพยากร แต่เป็นโมเดลที่ตั้งใจให้ผู้ใช้ทั่วไปได้สัมผัส AI ที่ฉลาดพอและเบาพอจะอยู่ในกระเป๋ากางเกงของตัวเอง
สิ่งที่น่าสนใจคือ EmbeddingGemma 2 รองรับข้อมูลทั้งข้อความ โค้ด ภาพ เสียง และวิดีโอในโมเดลเดียว พร้อมเทคนิคการบีบอัดที่ช่วยลดขนาดลงได้ถึง 6 เท่าเมื่อเทียบกับโมเดลเดิม โครงสร้างแบบแยกส่วนยิ่งตอกย้ำแนวคิดโมเดล AI ขนาดเล็ก เพราะผู้พัฒนาสามารถเลือกใช้เฉพาะส่วนข้อความที่มี 270 ล้านพารามิเตอร์ ส่วนมองเห็น 170 ล้านพารามิเตอร์ หรือส่วนเสียง 300 ล้านพารามิเตอร์ตามทรัพยากรที่มี ผลคือการประมวลผลบนอุปกรณ์ที่ยืดหยุ่น ไม่บังคับให้ทุกเครื่องต้องแบกความสามารถเต็มชุดถ้าไม่จำเป็น
หนึ่งในประโยคที่สะท้อนทิศทางนี้ชัดเจนคือว่า EmbeddingGemma 2 ถูกพัฒนามาให้ใช้งานร่วมกับ Google Pixel 11 Pro ได้อย่างราบรื่น และเมื่อใช้เทคนิค Quantization โมเดลข้อความกินแรมเพียง 191 MB ส่วนโมเดลเต็มรูปแบบใช้พื้นที่ประมวลผลบนอุปกรณ์แค่ 567 MB นี่คือหลักฐานว่าการออกแบบไม่ได้มองแค่ศักยภาพเชิงทฤษฎี แต่ผูกกับข้อจำกัดจริงของสมาร์ทโฟน
AI multimodal ท้องถิ่น เปลี่ยนสมาร์ทโฟนให้เป็นผู้ช่วยรอบด้าน
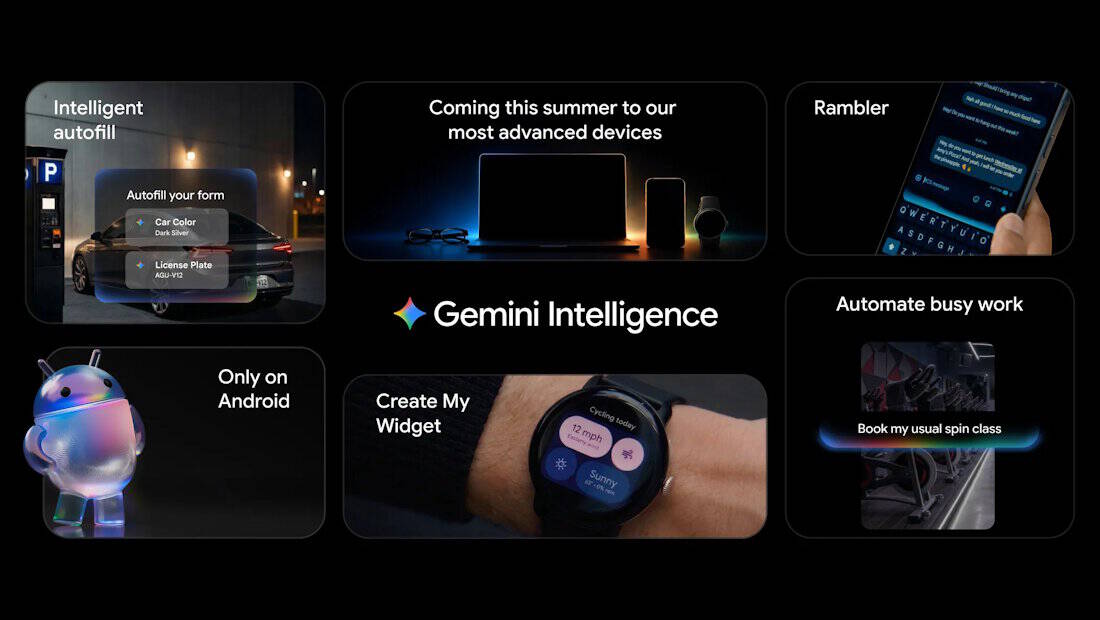
การที่ EmbeddingGemma 2 รองรับข้อความ โค้ด ภาพ เสียง และวิดีโอในโมเดลเดียว ทำให้แนวคิด AI multimodal ท้องถิ่นเริ่มจับต้องได้จริงบนสมาร์ทโฟน แทนที่จะต้องส่งภาพหรือเสียงขึ้นคลาวด์เพื่อให้โมเดลใหญ่ ๆ วิเคราะห์ ตอนนี้เครื่องสามารถตีความสไลด์ประชุมจากภาพ ฟังเสียงบันทึก แล้วสรุปเป็นโน้ตข้อความได้ในตัวเดียว ความเร็วดีขึ้นเพราะไม่ต้องรอเครือข่าย และความเป็นส่วนตัวดีขึ้นเพราะข้อมูลไม่ต้องออกจากเครื่อง
การประมวลผลภายในอุปกรณ์โดยไม่ต้องพึ่งคลาวด์จากภายนอกคือการพลิกเกมเรื่องความไว้วางใจของผู้ใช้ สำหรับคนที่กังวลว่าการส่งเสียงสนทนา ภาพเอกสาร หรือวิดีโอส่วนตัวขึ้นเซิร์ฟเวอร์จะเสี่ยงต่อการรั่วไหล โมเดล AI ขนาดเล็กที่ทำงานบนเครื่องคือคำตอบ การที่ EmbeddingGemma 2 ถูกปรับแต่งให้เหมาะกับสมาร์ทโฟนระดับกลางที่มีแรมราว 8 GB โน้ตบุ๊ก เว็บเบราเซอร์ แว่นตาอัจฉริยะ และอุปกรณ์ IoT บางชนิดยิ่งทำให้เห็นว่า AI multimodal ท้องถิ่นไม่ใช่ของเล่นสำหรับเครื่องแพง แต่เป็นมาตรฐานใหม่ของอุปกรณ์รอบตัวเรา
เมื่อเทียบกับแนวทางของคู่แข่งที่ผลักดันโมเดลอย่าง GPT-4o mini ไปอยู่บนอุปกรณ์ แนวทางของ Gemma AI สมาร์ทโฟนมีความชัดเจนว่าเน้นการออกแบบให้เข้ากับฮาร์ดแวร์จริงและการใช้งานประจำวันมากกว่า การบีบอัดขนาด 6 เท่าและการแยกส่วนโมเดลคือการยอมรับว่าทุกเครื่องมีข้อจำกัด แต่ทุกเครื่องก็สมควรได้ใช้ AI multimodal ท้องถิ่นที่ฉลาดพอสำหรับงานในชีวิตประจำวัน
Gemma 4 ห้าขนาด เปิดน้ำหนักและ Apache 2.0 เพื่อการปรับใช้ท้องถิ่น
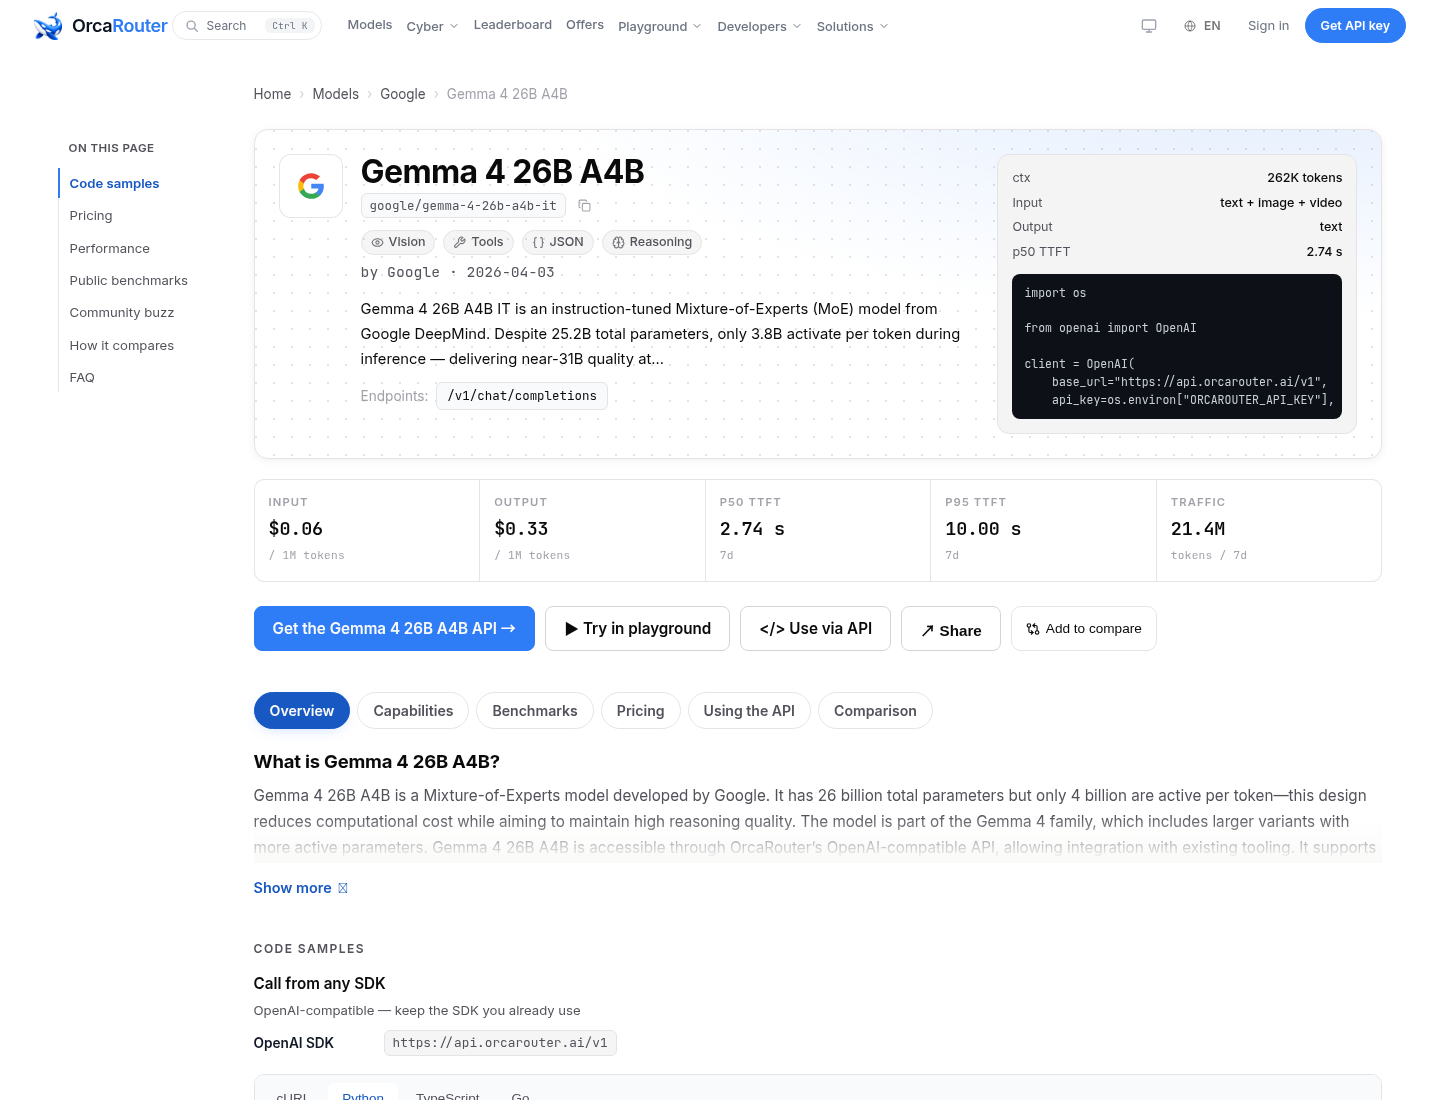
EmbeddingGemma 2 ไม่ได้เกิดขึ้นลอย ๆ แต่ต่อยอดจากโครงสร้างของตระกูล Gemma 4 ที่มีห้าโมเดลแยกกัน ได้แก่ Gemma 4 E2B, Gemma 4 E4B, Gemma 4 12B, Gemma 4 26B A4B และ Gemma 4 31B แต่ละขนาดถูกออกแบบให้ตอบโจทย์ฮาร์ดแวร์และหน้าต่างบริบทต่างกัน ตั้งแต่รุ่นที่ตั้งใจให้ใช้บนโทรศัพท์และอุปกรณ์ IoT ไปจนถึงรุ่นท็อปแบบ dense สำหรับงานที่ต้องการคุณภาพสูงสุด แนวคิดนี้สะท้อนว่าการประมวลผลบนอุปกรณ์ไม่ใช่เรื่องของโมเดลเดียว แต่เป็นการมีตัวเลือกที่เหมาะกับข้อจำกัดของแต่ละเครื่อง
สิ่งที่ทำให้ตระกูล Gemma 4 น่าสนใจสำหรับนักพัฒนาคือการเป็นโมเดลแบบเปิดน้ำหนัก และทุกขนาดเผยแพร่ภายใต้สัญญาอนุญาต Apache 2.0 นั่นหมายความว่านักพัฒนาสามารถดาวน์โหลด ดัดแปลง ปรับแต่ง และนำไปใช้เชิงพาณิชย์ได้ โดยยังคงควบคุมข้อมูล โครงสร้างพื้นฐาน และโมเดลของตนเอง โพสต์เปิดตัวระบุชัดว่าการเปิดภายใต้ Apache 2.0 ยอมให้เผยแพร่ต่อ ใช้เชิงพาณิชย์ และปรับแต่งละเอียดน้ำหนักเหล่านี้ได้ และตัวน้ำหนักเองก็ถูกเผยแพร่แล้ว นี่คือการวางรากฐานให้ AI multimodal ท้องถิ่นไม่ใช่แค่ฟีเจอร์ในผลิตภัณฑ์ของบริษัทใหญ่ แต่เป็นแพลตฟอร์มที่ชุมชนนักพัฒนาสามารถต่อยอด
เมื่อมองภาพรวม การมีทั้ง EmbeddingGemma 2 ที่เปิดให้ดาวน์โหลดในฐานะโอเพนซอร์ส และตระกูล Gemma 4 แบบ open-weight ภายใต้ Apache 2.0 ทำให้เห็นชัดว่าทิศทางคือการผลักดัน AI จากคลาวด์ลงสู่ขอบเครือข่าย นักพัฒนาสามารถเลือกขนาดโมเดลที่เหมาะกับสมาร์ทโฟน โน้ตบุ๊ก หรือแม้แต่แว่นตาอัจฉริยะ แล้วปรับแต่งให้ตอบโจทย์ผู้ใช้เฉพาะกลุ่มได้ การแข่งขันต่อไปจึงไม่ใช่แค่ใครมีโมเดลใหญ่ที่สุด แต่ใครให้เครื่องของผู้ใช้กลายเป็นบ้านของ AI ได้ดีที่สุด
บทสรุป โมเดล AI ขนาดเล็กคืออนาคตที่อยู่ในมือ ไม่ใช่บนคลาวด์
เมื่อมองจาก EmbeddingGemma 2 และตระกูล Gemma 4 จะเห็นภาพเดียวกันคือการผลักดัน AI ลงสู่การประมวลผลบนอุปกรณ์อย่างจริงจัง โมเดล AI ขนาดเล็กที่รองรับข้อความ ภาพ เสียง และวิดีโอในตัวเดียว พร้อมบีบอัดให้เล็กพอสำหรับสมาร์ทโฟนระดับกลาง แปลว่าผู้ใช้ไม่ต้องรอให้เครือข่ายดีหรือกังวลเรื่องข้อมูลหลุดออกจากเครื่องอีกต่อไป AI multimodal ท้องถิ่นจึงไม่ใช่คำศัพท์เทคนิค แต่เป็นประสบการณ์ใหม่ที่สมาร์ทโฟนสามารถฟัง ดู อ่าน และคิดไปพร้อมกับเรา
สำหรับผู้ใช้ทั่วไป ผลลัพธ์คือสมาร์ทโฟนที่ฉลาดขึ้นโดยไม่ต้องเสียความเป็นส่วนตัว สำหรับนักพัฒนา ผลลัพธ์คือชุดโมเดลแบบเปิดน้ำหนักภายใต้ Apache 2.0 ที่ให้สิทธิในการปรับแต่งและนำไปใช้เชิงพาณิชย์ได้เต็มที่ เมื่อคู่แข่งต่างหันมาสร้างโมเดลเล็กอย่าง GPT-4o mini การที่ Gemma AI สมาร์ทโฟนเดินเกมด้วย EmbeddingGemma 2 และ Gemma 4 ทำให้เห็นว่าศึกต่อไปของ AI ไม่ได้อยู่บนคลาวด์ แต่เกิดขึ้นในมือผู้ใช้ทุกคน คำถามจึงไม่ใช่ว่าเราจะใช้ AI หรือไม่ แต่คือเราจะยอมให้ AI อยู่บนคลาวด์ หรือเลือกให้มันอยู่ในเครื่องของเราเอง