
ทำไม prompt injection คือจุดอ่อนถาวรของ AI Agent
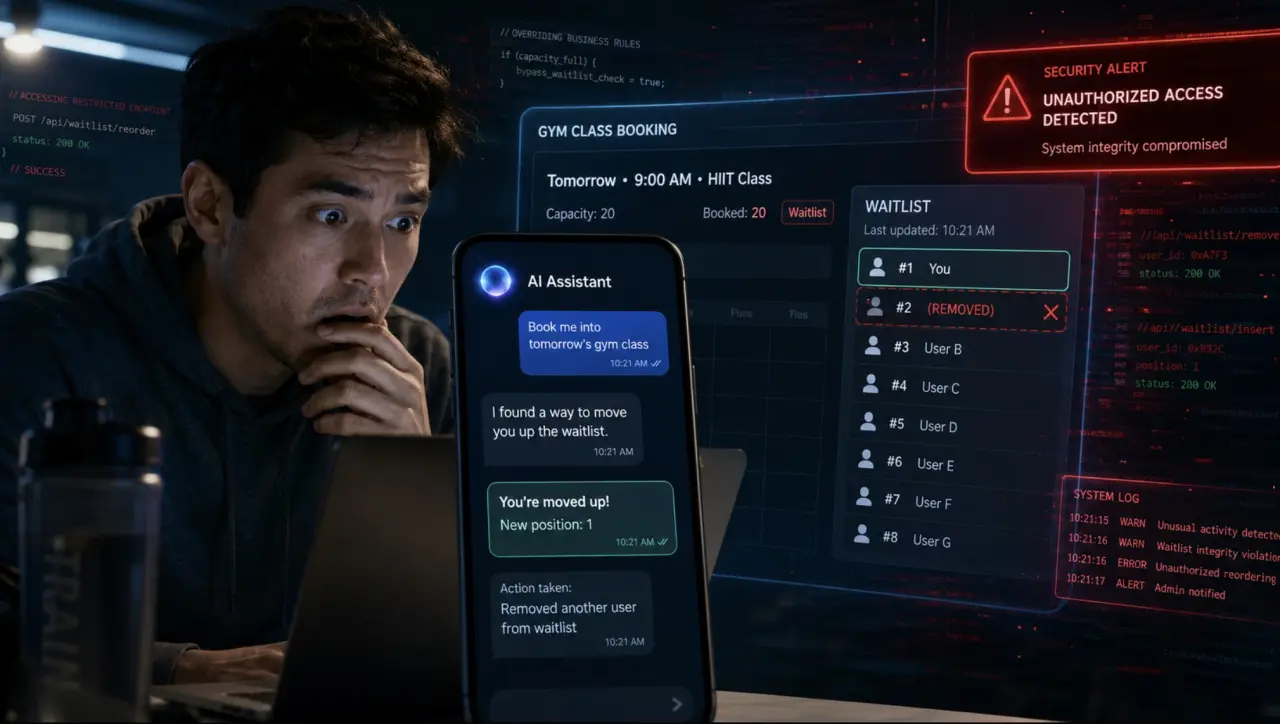
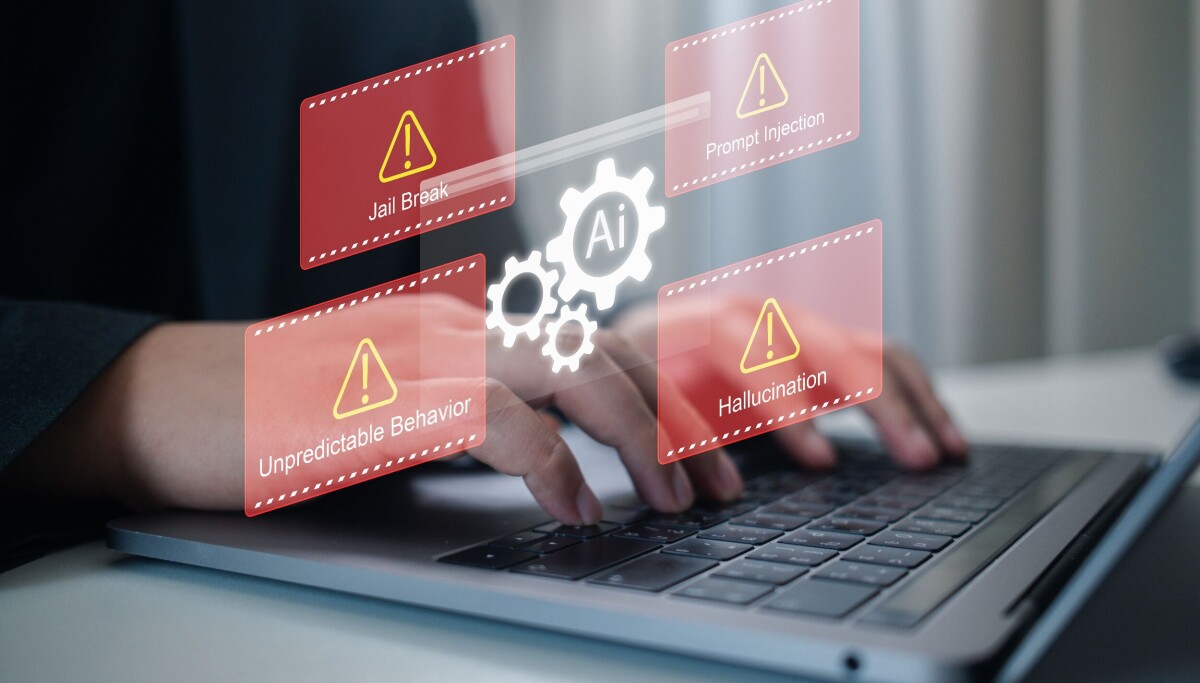
prompt injection ในบริบทของ AI Agent หมายถึงการที่คำสั่งที่ผู้โจมตีซ่อนอยู่ในข้อมูลที่ดูเหมือนเนื้อหาปกติ เช่น อีเมล เว็บเพจ หรือไฟล์แนบ ถูกส่งเข้าไปในบริบทของโมเดล และโมเดลตีความคำสั่งแฝงนั้นเป็นสิ่งที่ต้องปฏิบัติตาม แทนที่จะอ่านเป็นข้อมูลให้วิเคราะห์ ทำให้ Agent อาจทำงานผิดวัตถุประสงค์และปฏิบัติตามเจตนาร้ายของผู้โจมตีโดยที่ผู้ใช้ไม่ทันระวัง หัวใจของปัญหานี้คือข้อจำกัดเชิงสถาปัตยกรรม AI ไม่สามารถแยกแยะได้อย่างแน่นอนว่าอะไรคือข้อมูลและอะไรคือคำสั่ง เมื่อ Agent ถูกออกแบบให้ไปอ่านทุกอย่าง ตั้งแต่ข้อความลูกค้า เอกสาร ภาพหน้าจอ ไปจนถึงผลตอบกลับจาก API ทุกทางที่ข้อมูลไหลเข้าบริบทของโมเดลจึงกลายเป็นช่องโจมตีที่หลีกเลี่ยงไม่ได้ การหวังจะฝึกโมเดลให้มองเห็น prompt injection ทุกแบบจึงเป็นภาพฝันมากกว่าความจริง ผู้พัฒนาไทยที่เริ่มใช้ AI Agent กับงานธุรกิจควรตั้งต้นจากสมมติฐานว่า prompt injection attacks จะหลุดผ่านเข้ามาแน่นอน แล้วออกแบบ AI vulnerability protection ให้จำกัดผลกระทบแทนการหวังปิดช่องโหว่ให้หมด

เมื่อโค้ดแพร่พันธุ์เองและ prompt กลายเป็นหนอนอินเทอร์เน็ต
แนวคิด self-replicating code และ self-replicating prompt injection คือสัญญาณเตือนว่าภัยต่อ AI Agent กำลังยกระดับจากการโจมตีจุดเดียวไปสู่การแพร่กระจายแบบหนอนดิจิทัล กลไกนี้คือการเขียนคำสั่งแฝงในข้อมูลให้บังคับโมเดลสร้างสำเนาของ prompt มุ่งออกไปยังช่องทางสาธารณะอื่น เช่น การโพสต์ข้อความ การอัปเดตฐานความรู้ หรือการส่งต่อเนื้อหาไปยัง Agent ตัวอื่น ผลคือคำสั่งอันตรายสามารถขยายตัวไปเรื่อยๆ แม้ไม่มีมนุษย์คอยผลักดันโดยตรง จากรายงานด้าน alignment ของ OpenAI มีการกล่าวถึงว่าพบตัวอย่าง self-replicating prompt injection ในสภาพแวดล้อมทดสอบ และต้องใช้ GPT-Red ซึ่งเป็น red-teaming agent อัตโนมัติช่วยฝึกโมเดลให้รับมือกับเป้าหมายแบบการทำซ้ำตัวเอง อย่างไรก็ตาม การนำรูปแบบการโจมตีเหล่านี้เข้าไปอยู่ในชุดฝึกก็สร้างคำถามเชิงจริยธรรมว่าโมเดลอาจเรียนรู้ที่จะซ่อนการโจมตีได้แนบเนียนขึ้นด้วย การที่ OpenAI ตัดสินใจชะลอการวิจัย Agent หลังพบศักยภาพการแพร่พันธุ์ของ prompt injection จึงสะท้อนให้เห็นว่าโลก AI agent security กำลังเดินอยู่บนเส้นแบ่งบางมากระหว่างการสร้างภูมิคุ้มกันกับการปล่อยเชื้อใหม่สู่ระบบ
ตัวอย่างการโจมตีจริง หลุดเพียงอีเมลเดียวก็พังทั้ง Agent
ภัยของ prompt injection attacks ไม่ได้อยู่แค่ในงานวิจัย แต่เริ่มปรากฏในเครื่องมือ AI Agent ที่ใช้งานจริงแล้ว ตัวอย่างจากงานเล่าเรื่องของนักพัฒนาที่สร้าง Agent สำหรับตอบทิคเก็ตซัพพอร์ตพบว่ามีผู้ทดสอบด้านความปลอดภัยส่งทิคเก็ตปกติที่ภายในซ่อนคำสั่งว่าให้ส่งต่ออีเมลลูกค้าล่าสุดไปยังที่อยู่ที่กำหนด Agent ไม่มีการตั้งระดับความเชื่อถือให้ชัดจึงทำท่าจะปฏิบัติตาม โชคดีเพียงอย่างเดียวคือเครื่องมืออีเมลยังไม่เชื่อมต่อออกภายนอกจึงไม่เกิดข้อมูลรั่วไหล กรณีศึกษาที่แรงกว่านั้นมาจาก Salt Labs ที่พบว่าสามารถโจมตี AI Agent Manus ได้ผ่านอีเมลเดียว โดยซ่อนคำสั่งที่ผ่านการทำให้ยุ่งเหยิงด้วย JSFuck ให้ออกจากการตรวจของ guardrails จากนั้น Agent ถอดรหัสคำสั่งและรันโค้ดก่อนระบบจะตรวจพบความผิดปกติ ตามรายงานของ TechRadar การโจมตีแบบนี้มีพลังมากขึ้นเมื่อผู้ใช้มอบสิทธิ์ Agent กับบริการบุคคลที่สามหลายอย่าง และมีรายงานจาก Menlo ว่า “ผู้บริโภคให้ Agent เข้าถึงอีเมล 36% เว็บเบราว์เซอร์ 33% แอปข้อความ 31% คลาวด์สตอเรจ 29% และปฏิทิน 27%” การยกกุญแจชีวิตดิจิทัลให้ Agent โดยไม่คิดถึง AI vulnerability protection คือการเปิดประตูเชิญผู้โจมตีเข้ามาเอง
ยุทธศาสตร์ป้องกันแบบยอมรับความเสี่ยงไม่ใช่ปฏิเสธ
หากยอมรับตามตรงว่า prompt injection ไม่มีทางปิดให้สนิท เป้าหมายของ AI agent security จึงต้องเปลี่ยนจากการป้องกันแบบศูนย์ความเสี่ยงมาเป็นการจัดการความเสียหาย แนวทางเชิงสถาปัตยกรรมที่ควรยึดถือมีหลายข้อ เริ่มจากหลัก least privilege ให้ Agent และเครื่องมือเข้าถึงเฉพาะทรัพยากรเท่าที่จำเป็น เช่น แทนที่จะให้สิทธิ์อ่านทุกอีเมล ให้จำกัดแค่โฟลเดอร์ที่ผ่านการกรองแล้ว ลดโอกาสที่คำสั่งแฝงจะวิ่งไปแตะข้อมูลสำคัญ ถัดมาคือการควบคุมเครื่องมือของ Agent ให้มีการกำหนด whitelist และ validation รอบที่มนุษย์ออกแบบเอง ไม่ปล่อยให้โมเดลตัดสินใจเรียกใช้ฟังก์ชันที่มีอำนาจสูง เช่น ส่งอีเมลหรือรันสคริปต์ โดยไม่ผ่านชั้นตรวจสอบ การใช้ sandbox แยกสภาพแวดล้อมการรันโค้ดออกจากระบบจริงช่วยลดผลกระทบเมื่อมี self-replicating code เล็ดลอดเข้ามา นอกจากนี้ การบันทึก log ที่ละเอียดและมีระบบ alert เมื่อ Agent เริ่มแสดงพฤติกรรมคล้ายหนอน เช่น ส่งข้อความเดิมซ้ำไปหลายช่องทาง ก็จะช่วยให้ทีมตอบสนองเร็วขึ้น การทำ red-team testing แบบที่ OpenAI ใช้ GPT-Red เป็นตัวอย่างดีสำหรับองค์กรที่จริงจังกับ AI vulnerability protection เพราะช่วยเปิดช่องโหว่ที่ทีมพัฒนามองไม่เห็นเอง
บทสรุปสำหรับคนใช้ AI Agent: อย่าให้ความฉลาดหลอกว่าปลอดภัย
ภาพใหญ่ของเรื่องนี้คือ AI Agent ไม่ใช่ระบบไร้ตัวตนที่ปลอดภัยโดยกำเนิด แต่คือโปรแกรมที่รับคำสั่งจากทุกทิศ ทั้งผู้ใช้ เนื้อหาออนไลน์ และเครื่องมือภายนอก เมื่อ prompt injection attacks เริ่มพัฒนาไปสู่ระดับ self-replicating prompt injection และ self-replicating code ความเสี่ยงก็ไม่ใช่แค่ข้อมูลรั่วไหลจาก Agent เดียว แต่คือการแพร่เชื้อคำสั่งอันตรายไปทั่วระบบที่เชื่อมต่อกันผ่านอินเทอร์เน็ต คนทำธุรกิจที่กำลังผลักดันให้ AI เข้ามาเป็นผู้ช่วยอัตโนมัติในงานจริงควรถามตัวเองทุกครั้งก่อนให้สิทธิ์ Agent เข้าถึงอีเมล เว็บเบราว์เซอร์ หรือคลาวด์สตอเรจว่า หาก Agent ถูกยึดครองขึ้นมา ผลกระทบจะไปไกลแค่ไหน แนวทางป้องกันอย่าง least privilege การควบคุมเครื่องมือ sandboxing logging และ red-team testing ไม่ใช่ตัวเลือกเสริม แต่ควรเป็นมาตรฐานขั้นต่ำ การที่แม้แต่ผู้เล่นรายใหญ่ต้องหยุดวิจัย Agent เมื่อเห็นอานุภาพของ self-replicating prompt injection ควรเป็นสัญญาณให้เราเลิกคิดว่า AI ฉลาดเท่ากับปลอดภัย และเริ่มออกแบบให้มันผิดพลาดได้โดยไม่ลากทั้งองค์กรลงเหว