
AI coding agents คืออะไร และทำไมการปล่อยให้ทำงานเองหมดจึงเป็นกับดัก
AI coding agents คือเครื่องมืออัตโนมัติที่ช่วยนักพัฒนาเขียนโค้ด ทดสอบ และปรับปรุงซอฟต์แวร์โดยใช้โมเดลปัญญาประดิษฐ์ที่เข้าใจโครงสร้างโค้ดและบริบทของโปรเจกต์ เป้าหมายคือเร่งความเร็วการพัฒนา ลดงานซ้ำ และช่วยให้ทีมส่งมอบฟีเจอร์ได้ไวขึ้น แต่เมื่อใช้แบบปล่อยให้ทำงานเองทั้งหมดโดยไม่มีการกำกับจากมนุษย์ ความเข้าใจระบบจะลดลง ความเสี่ยงด้านคุณภาพและความซับซ้อนของโค้ดจะเพิ่มขึ้น และองค์กรอาจสูญเสียความสามารถในการดูแลโค้ดระยะยาว ประเด็นสำคัญของยุคนี้คือ AI coding agents ไม่ใช่เครื่องจักรที่ควรรับผิดชอบทุกบรรทัดของโค้ด แต่เป็นคู่หูที่ต้องมี AI agent oversight ชัดเจน นักพัฒนาคนหนึ่งเล่าว่าเริ่มต้นจากการให้เอเจนต์อย่าง Claude Code และ Codex เขียนและทดสอบทุกอย่างให้จากคำอธิบายสั้นๆของเขา ผลคือเขาสามารถอธิบายได้แค่ว่าแอปทำอะไร แต่ไม่เข้าใจเลยว่าฟีเจอร์ทำงานอย่างไรเบื้องหลัง เมื่อระบบพัง เขาและเอเจนต์ต่างก็วนอยู่กับการเดาเพราะไม่มีใครเข้าใจโค้ดจริงๆ การเปลี่ยนมุมมองจาก “ให้ AI ทำแทนทั้งหมด” เป็น “ให้ AI อธิบายและช่วยทีละส่วน” จึงเป็นจุดหักเห เขาเริ่มขอให้เอเจนต์อธิบายว่าต้องแก้ไฟล์ไหน คอมโพเนนต์ใดเชื่อมกันอย่างไร แล้วลงมือเขียนบางส่วนเอง เมื่อเจอทางตันค่อยถามต่อ ผลคือเข้าใจโค้ดมากขึ้นและแก้ปัญหาได้เองเมื่อระบบล้มเหลว ในโลกที่การเขียนโปรแกรมเปลี่ยนไปอย่างหนักในปี 2026 และ AI กลายเป็นส่วนหนึ่งของงานพัฒนาอย่างหลีกเลี่ยงไม่ได้ การปฏิเสธการเรียนรู้โค้ดด้วยตัวเองจึงไม่ใช่ทางเลือกอีกต่อไป
ความเร็วที่แลกด้วยความซับซ้อน: ทำไมทีมต้องมีมาตรฐานตรวจสอบโค้ดใหม่
เมื่อ AI coding agents ถูกใช้เพื่อ developer workflow automation อย่างแพร่หลาย ผลกระทบด้านคุณภาพโค้ดเริ่มชัดขึ้น งานวิจัยหนึ่งที่วิเคราะห์การเปลี่ยนแปลงโค้ดกว่า 623 ล้านครั้งพบว่าการซ้ำบล็อกโค้ดเพิ่มขึ้นถึง 81 เปอร์เซ็นต์เมื่อเทียบกับปี 2023 ขณะเดียวกัน นักวิจัยจากมหาวิทยาลัย Carnegie Mellon วัดพบว่าโปรเจกต์ที่รับ AI agent เข้ามาใช้งานมีจำนวนคำเตือนจาก static analysis เพิ่มขึ้น 30 เปอร์เซ็นต์ และความซับซ้อนของโค้ดเพิ่มขึ้น 41 เปอร์เซ็นต์ โดยผลกระทบด้านคุณภาพนี้ยังอยู่ต่อเนื่องแม้หลังจากช่วงที่ความเร็วเพิ่มขึ้นในตอนแรก ตัวเลขเหล่านี้บอกตรงๆว่า การเร่งความเร็วด้วย AI โดยไม่มีระบบ code quality verification ที่ดีคือการกู้เวลาในวันนี้ด้วยดอกเบี้ยทางเทคนิคในวันหน้า องค์กรจำนวนมากจึงเริ่มออกแบบมาตรฐานตรวจสอบใหม่ที่ไม่ผูกกับเอเจนต์ตัวใดตัวหนึ่ง เพราะทีมพัฒนาส่วนใหญ่ใช้เครื่องมือ AI เฉลี่ยถึงสี่ตัวและสลับไปมาทุกไม่กี่เดือน ถ้าปล่อยให้แต่ละเครื่องมือเป็นผู้ตัดสินคุณภาพของโค้ดตัวเอง มาตรฐานจะกลายเป็นผลพลอยได้จากการเลือก vendor แทนที่จะเป็นหลักวิศวกรรมที่ทีมตกลงร่วมกัน แนวคิดที่กำลังเกิดขึ้นคือการสร้างชั้นตรวจสอบอิสระที่แยกจากเครื่องมือที่สร้างโค้ดโดยสิ้นเชิง การวิเคราะห์เชิงกำหนดแบบ deterministic และคุณภาพเกตใน CI/CD ถูกใช้เป็นโครงหลักของกรอบ zero trust ที่ไม่เชื่อโค้ดจากเอเจนต์ใดโดยอัตโนมัติ แนวทางนี้ไม่ได้ปฏิเสธ AI แต่ยืนยันว่าการตรวจสอบต้องอยู่คนละฝั่งกับการสร้างโค้ดเสมอ

ตัวอย่างจากสนามจริง: ให้เอเจนต์ช่วยทดสอบ แต่ให้คนถือสิทธิ์ merge
คำถามคือจะใช้ AI coding agents ในงาน test automation และ pull request review อย่างไรโดยไม่ลดบทบาทนักพัฒนา หนึ่งในตัวอย่างที่น่าสนใจคือทีมวิศวกรรมด้าน commerce ทีมหนึ่งที่ตั้งเอเจนต์แบบกำหนดเวลาให้ค้นหาไฟล์ที่มี test coverage บาง เขียนเทสต์ที่ขาด และเปิด pull request ให้รีวิว ก่อนหน้านั้นทีมมีคำสั่งหนึ่งคลิกให้เอเจนต์เขียนเทสต์จากไฟล์ที่เปิดอยู่ใน editor แต่ยังต้องพึ่งคนสังเกตช่องว่างและกดรันเอง เมื่อเปลี่ยนเป็น pipeline อัตโนมัติ ช่องว่างนี้ถูกส่งต่อให้เอเจนต์ดูแล ที่สำคัญคือทีมไม่ได้ให้เอเจนต์ยึดงานทดสอบไปทั้งหมด เอเจนต์แค่ทำงานตั้งต้น เช่นหาไฟล์ที่ coverage ต่ำ เขียนไฟล์เทสต์แรก และจัดชุดการเปลี่ยนแปลงที่คนรีวิวได้สะดวก แต่ละรันเปิด PR สูงสุดหนึ่งรายการและจำกัดที่ไฟล์เดียว ทำให้รีวิวได้ในครั้งเดียวโดยไม่ต้องไล่ดู diff ยาวๆ ในช่วงประมาณสี่สัปดาห์ ทีมรีวิวและ merge PR ที่เอเจนต์เปิดราว 34 รายการ ส่งผลให้ coverage ของทั้ง repository จากประมาณ 70 เปอร์เซ็นต์เพิ่มขึ้นเป็นราว 82 เปอร์เซ็นต์ แม้จะมีการตรวจสอบอัตโนมัติผ่าน CI แต่ทีมยังย้ำว่าการผ่านเช็คไม่ใช่การแทนที่รีวิวของมนุษย์ เทสต์ที่เพิ่ม coverage ได้อาจไม่ตรวจพฤติกรรมที่ผู้ใช้พึ่งพาจริงๆ ดังนั้นพวกเขาจึง “keep people on the merge and on the prompt” วิศวกรเป็นคนตัดสินว่าเทสต์ไหนควรเก็บ ปรับ prompt อย่างไร และสุดท้ายใครจะเป็นคนกด merge แนวทางนี้แสดงให้เห็นว่าการใช้ AI agent oversight อย่างตั้งใจสามารถเพิ่ม productivity โดยไม่ลดการมีส่วนร่วมของนักพัฒนา
มาตรฐานตรวจสอบโค้ดแบบ zero trust: แยกชั้นสร้างและชั้นตรวจให้ชัด
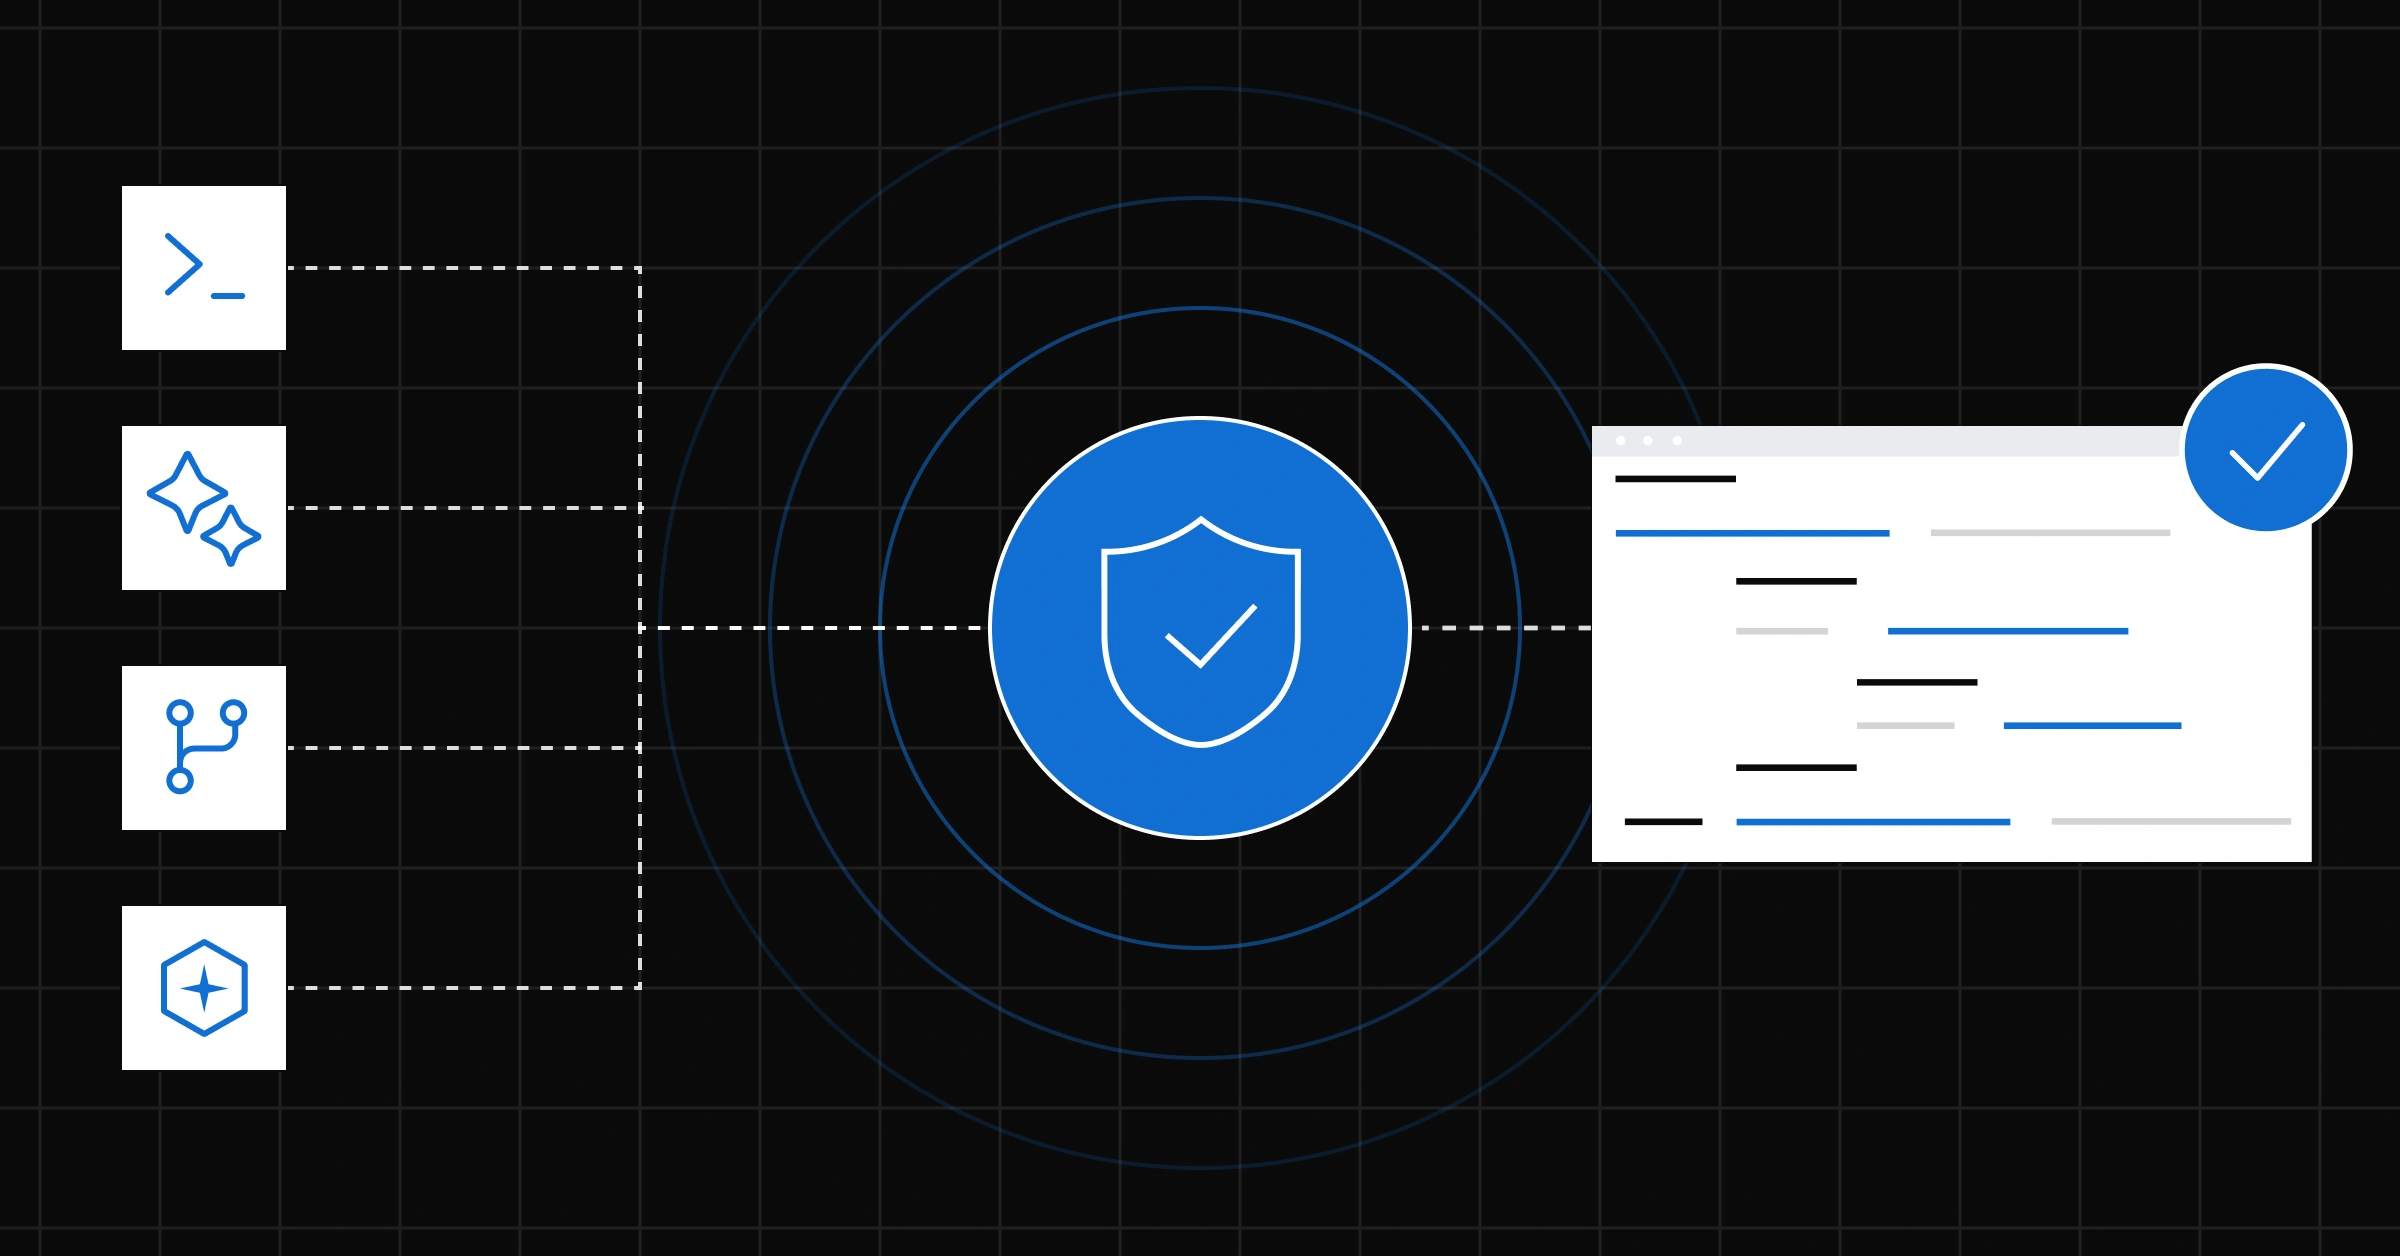
เมื่อทีมใช้ AI coding agents หลายตัวในเวลาเดียวกัน การมีมาตรฐาน code quality verification เดียวที่ใช้กับทุกเอเจนต์จึงสำคัญมาก การสำรวจหนึ่งพบว่าทีมพัฒนาส่วนใหญ่ใช้เครื่องมือ AI เฉลี่ยสี่ตัวและสลับไปตามโมเดลใหม่ที่ออกทุกไม่กี่เดือน ถ้าปล่อยให้แต่ละเอเจนต์ตรวจงานตัวเองด้วยวิธีต่างกัน คุณภาพโค้ดจะขึ้นกับเครื่องมือที่เลือกใช้มากกว่าหลักการของทีมเอง แนวทางที่กำลังถูกเสนอคือ “verification has to run separately from whatever generated the code” การตรวจสอบต้องอยู่คนละชั้นกับการสร้างโค้ดและมีสี่องค์ประกอบหลัก ได้แก่ การวิเคราะห์แบบ deterministic ที่ใช้กฎและอัลกอริทึมคงที่ การตรวจ reasoning ของเอเจนต์เพื่อดูเจตนาและตรรกะ การตั้ง quality gate ใน CI/CD เพื่อบังคับการตัดสินใจ และการบันทึกผลแบบตรวจสอบย้อนหลังได้ ในกรอบนี้ โค้ดสามารถถูกสร้างด้วยเอเจนต์ใดก็ได้ แต่ต้องผ่านมาตรฐานเดียวกันผ่านเครื่องมือวิเคราะห์อิสระ เช่น SonarQube ที่ทำหน้าที่เป็นชั้นตรวจสอบและส่งสัญญาณคุณภาพกลับไปยังเอเจนต์ในระหว่างที่มันทำงาน ก่อนถึงเวลาส่ง PR หลายชั่วโมง อย่างไรก็ตาม การมี human review เพียงอย่างเดียวไม่เพียงพอ งานวิจัยจากสถาบันหนึ่งอธิบายปรากฏการณ์ “cognitive surrender” เมื่อผู้เข้าร่วมเชื่อคำแนะนำของ AI ถึง 92.7 เปอร์เซ็นต์เมื่อมันถูก และยังเชื่อถึง 79.8 เปอร์เซ็นต์แม้เมื่อมันผิดอย่างมั่นใจ นั่นหมายความว่าการรีวิวโดยคนที่ไม่มีชั้นตรวจสอบเชิงกำหนดรองรับอาจกลายเป็นการยืนยันความผิดพลาดของ AI มากกว่าการจับข้อผิดพลาด การสร้างกรอบ zero trust แบบหลายชั้นที่ผสมการวิเคราะห์เชิงโครงสร้างกับการตีความบริบทจึงเป็นคำตอบที่สมเหตุผลกว่าการหวังพึ่งสายตาคนอย่างเดียว
บทบาทนักพัฒนายุคใหม่: เลือกใช้เอเจนต์ให้เหมาะกับงานและไม่ยอมแพ้ทางความคิด
คำถามสุดท้ายคือในโลกที่ AI coding agents กลายเป็นส่วนหนึ่งของ developer workflow automation แล้ว นักพัฒนาควรปรับบทบาทอย่างไร สิ่งที่เห็นชัดคือ best practices ยังอยู่ระหว่างการพัฒนาและแตกต่างตามบทบาทในทีม เช่น คนเขียนฟีเจอร์หลัก คนดูแลสถาปัตยกรรม หรือคนดูแลคุณภาพโค้ดต่างต้องการกลยุทธ์การใช้เครื่องมือ AI ไม่เหมือนกัน บางคนใช้เอเจนต์เพื่อเขียน boilerplate และงานซ้ำ บางคนใช้เพื่ออธิบายโค้ดที่ซับซ้อน หรือช่วยออกแบบเทสต์โดยยังลงมือเขียนเองส่วนสำคัญ ในระดับองค์กร การออกแบบวงจรการทำงานที่รวม AI agent oversight ตั้งแต่ช่วงเขียนโค้ด ช่วงตรวจใน CI ไปจนถึงช่วงบำรุงรักษาโค้ดระยะยาวจึงเป็นเรื่องจำเป็น การตรวจสอบต้องฝังอยู่ในลูปที่นักพัฒนาใช้อยู่แล้ว ไม่ใช่เพิ่มขั้นตอนที่ไม่มีใครอยากแตะ ในทางปฏิบัติ แนวทางที่ได้ผลมักเริ่มจากงานเล็กๆที่มีเส้นชัยชัดเจน เช่นให้เอเจนต์ดูแลไฟล์เทสต์ทีละไฟล์แทนที่จะสั่ง “เพิ่ม coverage ทั้งระบบ” แล้วค่อยปรับเป้าหมายให้สูงขึ้นเมื่อ workflow พิสูจน์ตัวเอง สิ่งที่น่ากังวลที่สุดไม่ใช่การที่ AI เขียนโค้ดแทนเรา แต่คือการที่ทีมยอมแพ้ทางความคิดและปล่อยให้มันตัดสินใจแทนทั้งหมด ปรากฏการณ์ cognitive surrender แสดงให้เห็นว่ามนุษย์มีแนวโน้มเชื่อคำแนะนำของ AI แม้เมื่อมันผิด ทางออกคือการยืนยันบทบาทของนักพัฒนาในฐานะผู้ตั้งคำถาม ผู้กำหนดมาตรฐาน และผู้รับผิดชอบสุดท้ายต่อการ merge ทุกครั้ง AI coding agents จะยังคงเปลี่ยนแปลงงานพัฒนาไปอีกนาน แต่ถ้าเราวางกรอบ oversight ที่ดีและไม่ทิ้งการเรียนรู้โค้ดด้วยตัวเอง เราสามารถใช้ความเร็วของมันโดยไม่แลกด้วยคุณภาพและวิจารณญาณของมนุษย์