
AI Agent สถานะ คืออะไร และทำไมการจำมากขึ้นไม่ช่วยให้ฉลาดขึ้น
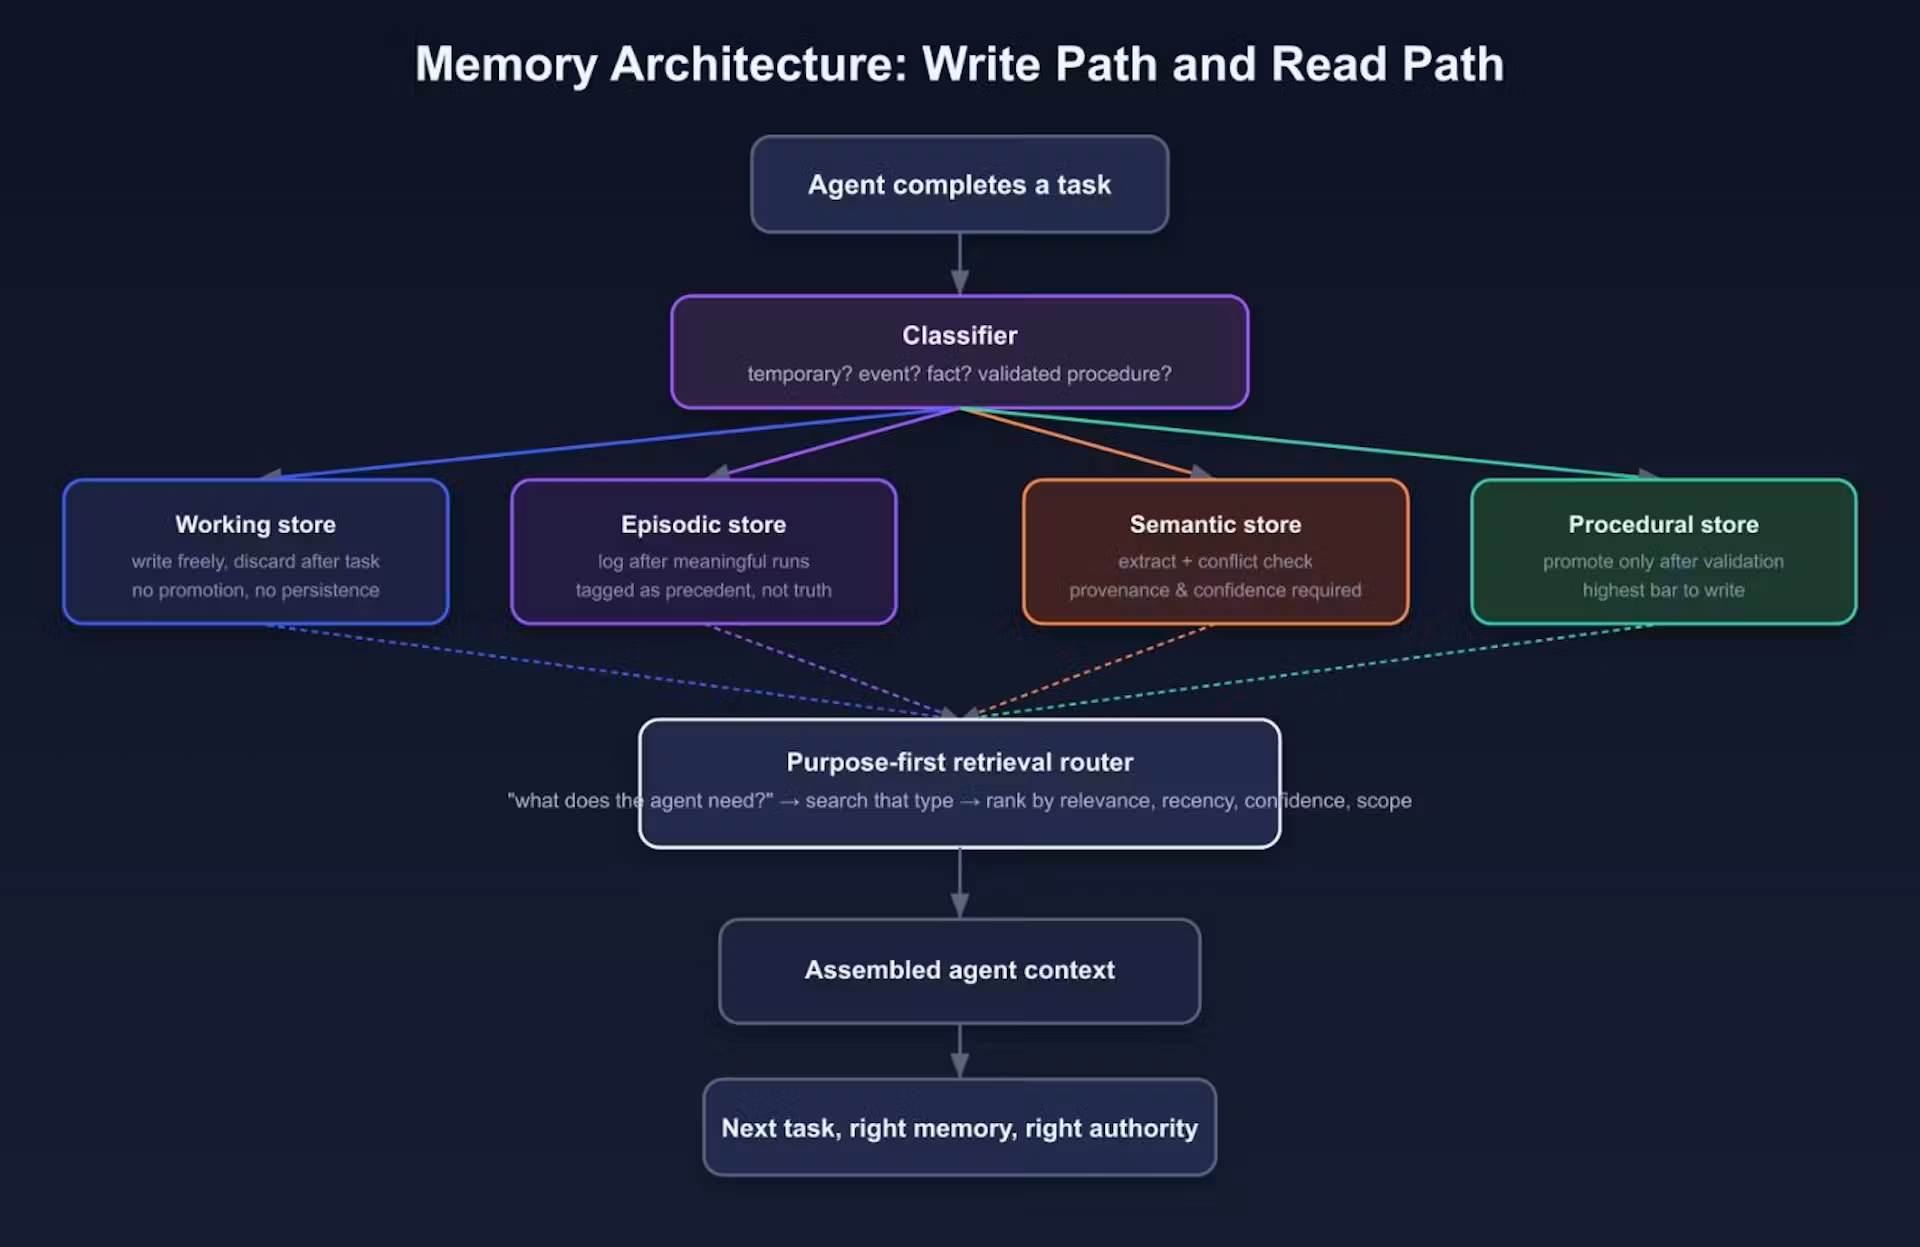
AI Agent สถานะหมายถึงภาพรวมข้อมูลที่บอกว่าอะไรเป็นความจริงในตอนนี้ กระบวนการอยู่ขั้นไหน เครื่องมือใดตอบกลับแล้ว และระบบภายนอกถือว่าเหตุการณ์ใดเสร็จสมบูรณ์ สถานะจึงไม่ใช่แค่ประวัติการสนทนา แต่คือชุดข้อมูลที่บอกให้เอเจนต์ตัดสินใจได้ตรงกับโลกจริงในช่วงเวลาปัจจุบัน การออกแบบสถานะที่ดีต้องคิดเรื่องความต่อเนื่อง การทำงานพร้อมกัน การฟื้นตัวหลังล้มเหลว และขอบเขตความเชื่อถือได้ของระบบด้วย ไม่ใช่เพิ่มความจำอย่างเดียว แนวทางพื้นฐานที่โลกโปรดักชันใช้ คือทำให้โมเดลภาษาทำงานแบบ stateless แต่ล้อมรอบด้วย runtime ที่มีสถานะชัดเจนเพื่อจัดการเซสชัน สถานะการรัน การเก็บข้อมูล การเรียกเครื่องมือ และการกู้คืน เมื่อหยุดเรียกทุกอย่างว่าหน่วยความจำ คำถามสำคัญจะโผล่ขึ้นทันทีว่า ใครกันแน่คือเจ้าของสถานะ และสถานะนั้นชี้ไปที่ความจริงชุดไหนในระบบธุรกิจ

เมื่อการจัดการข้อมูล AI เท่ากับเรียกทุกอย่างว่าความจำ ผลคือเอเจนต์หลงทาง
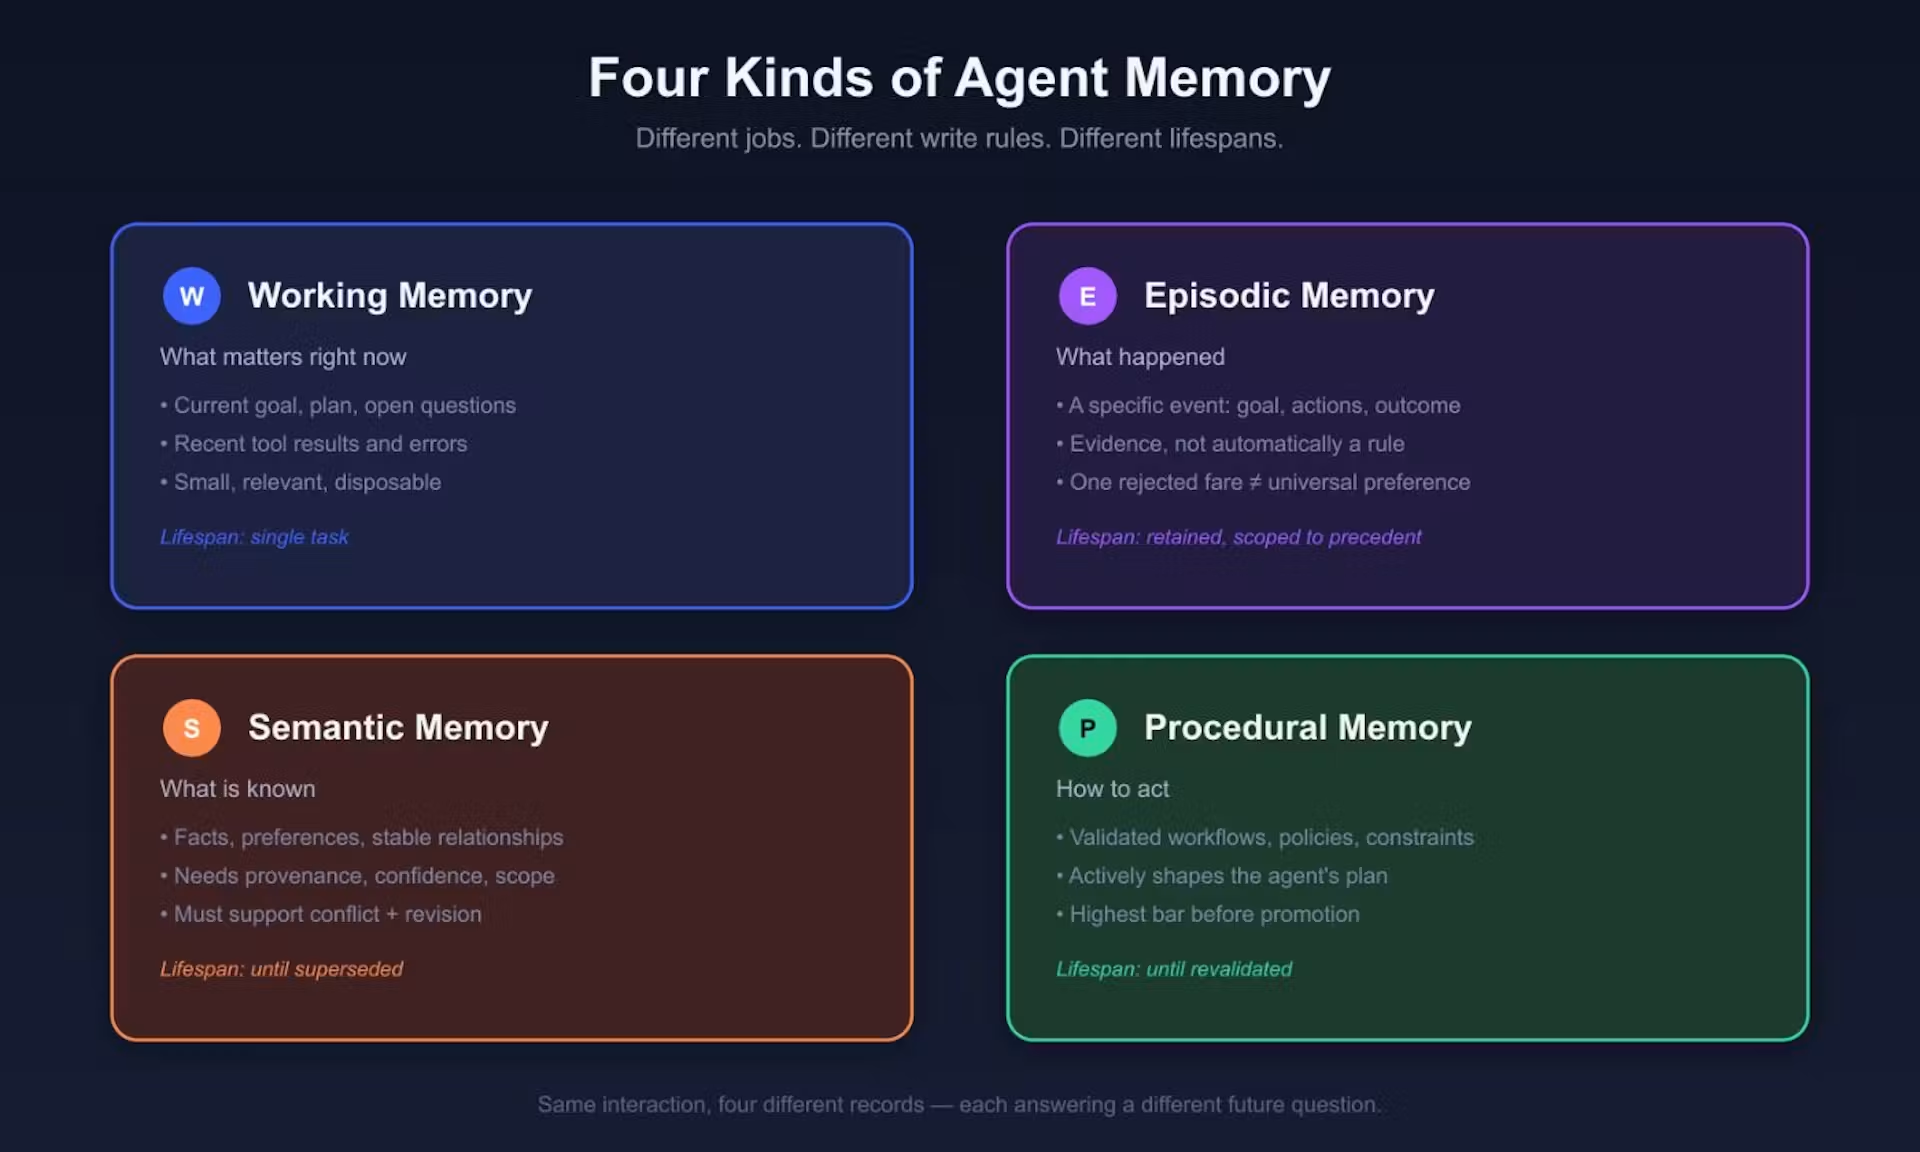
คำว่าความจำในระบบ AI ถูกใช้จนเละ ตั้งแต่ประวัติสนทนา การใช้งานก่อนหน้า การตั้งค่าผู้ใช้ เอกสารที่ค้นมา ผลตอบกลับจากเครื่องมือ เช็กพอยต์เวิร์กโฟลว์ ผลลัพธ์กลางๆ สรุปย่อ และการตัดสินใจครั้งก่อน ทุกอย่างถูกโยนลงถังเดียวกันว่าเป็นหน่วยความจำ เมื่อทำแบบนี้ เราหลบเลี่ยงคำถามที่สำคัญที่สุดว่า ข้อมูลชิ้นนี้หมายถึงอะไร และจริงกับโลกภายนอกนานแค่ไหน ปัญหา AI Agent สถานะจึงไม่ใช่การจำไม่พอ แต่คือการไม่รู้ว่าข้อมูลไหนคือความจริงล่าสุดของระบบธุรกิจ การให้โมเดลเห็นข้อมูลสนทนาที่เกี่ยวข้องไม่ได้แปลว่ามันรู้สถานะการคืนเงินในระบบชำระเงิน เพราะเจ้าของความจริงคือระบบการจ่ายเงิน ไม่ใช่ข้อความในบริบท การจัดการข้อมูล AI ที่ดีต้องยอมรับว่า ข้อมูลแต่ละชนิดมีอายุการใช้งานและความเป็นเจ้าของต่างกัน และต้องออกแบบให้สถานะที่ใช้ตัดสินใจตรงกับระบบอำนาจตัดสินใจจริง
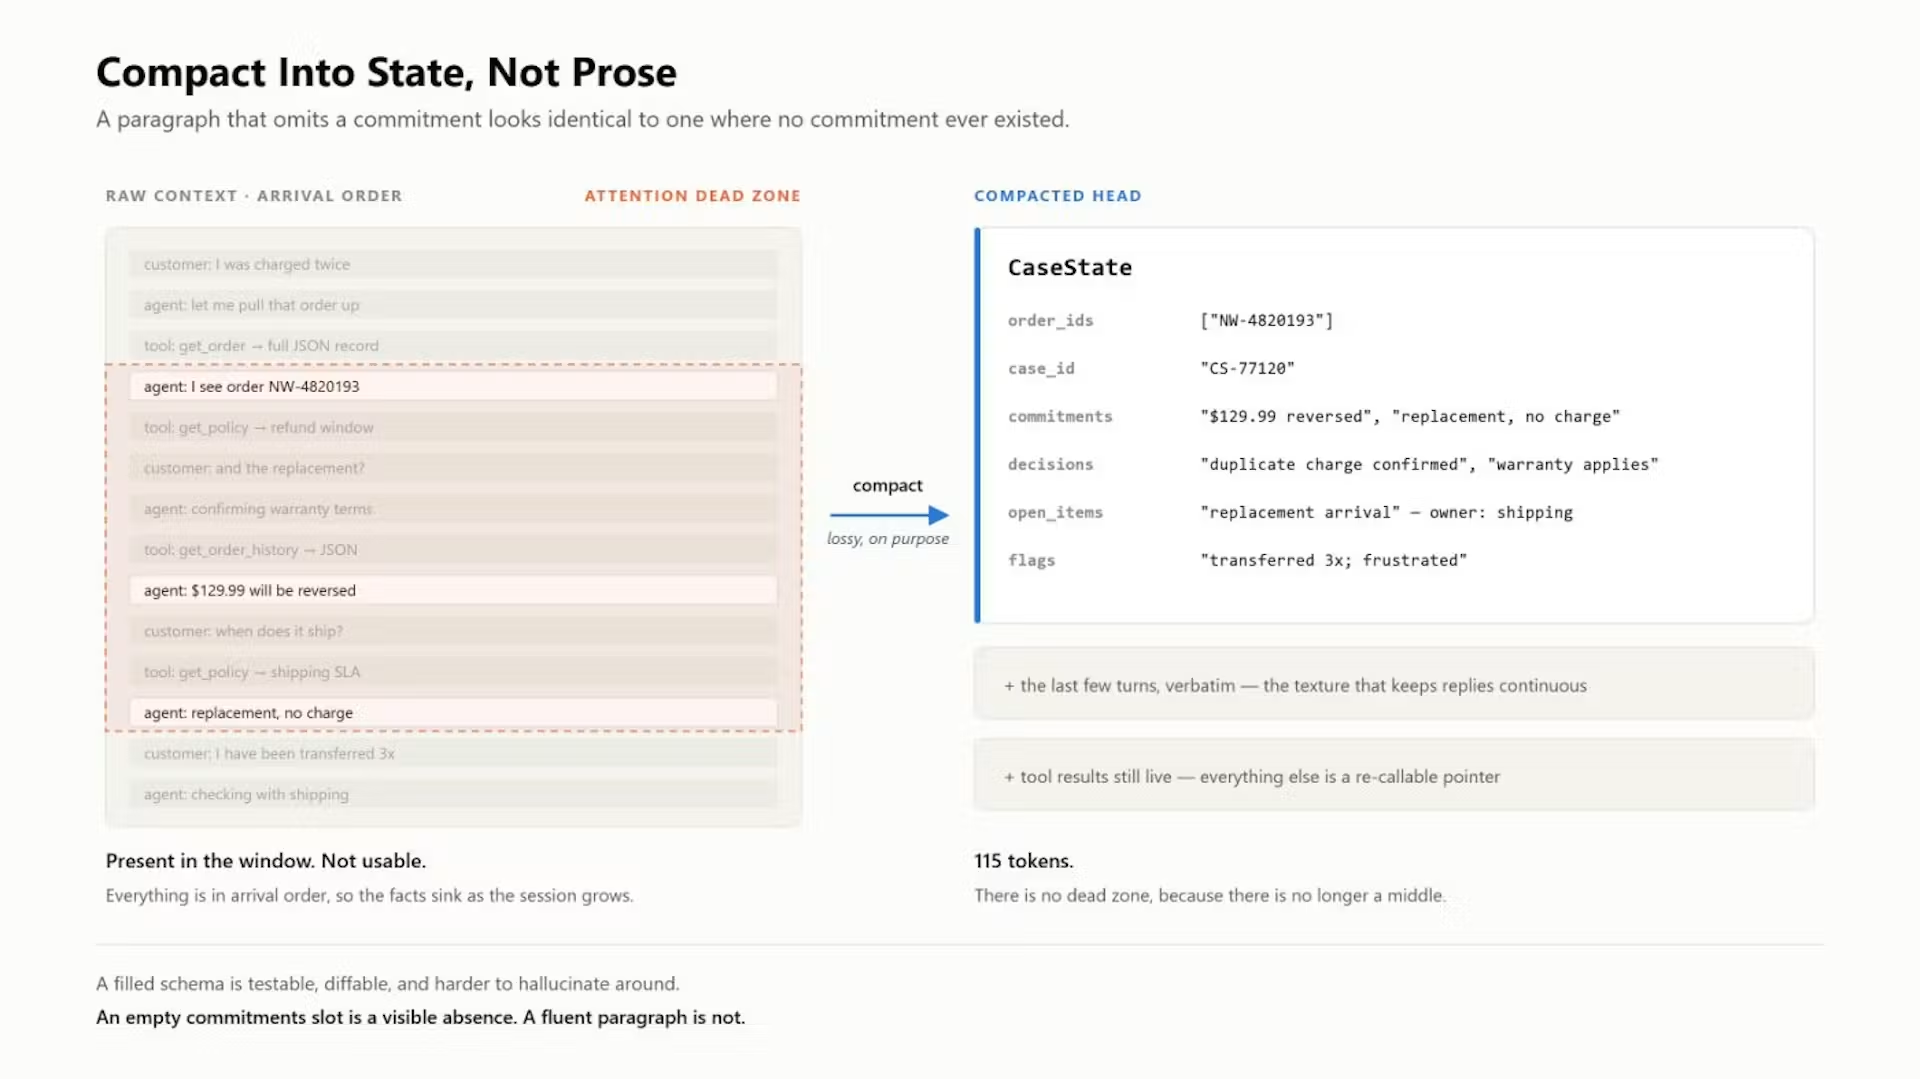
สรุปบริบทให้สั้นแต่ทำสถานะหล่น ทำไมเอเจนต์ถึงดูเหมือนลืมทั้งที่ไม่ได้ลืม
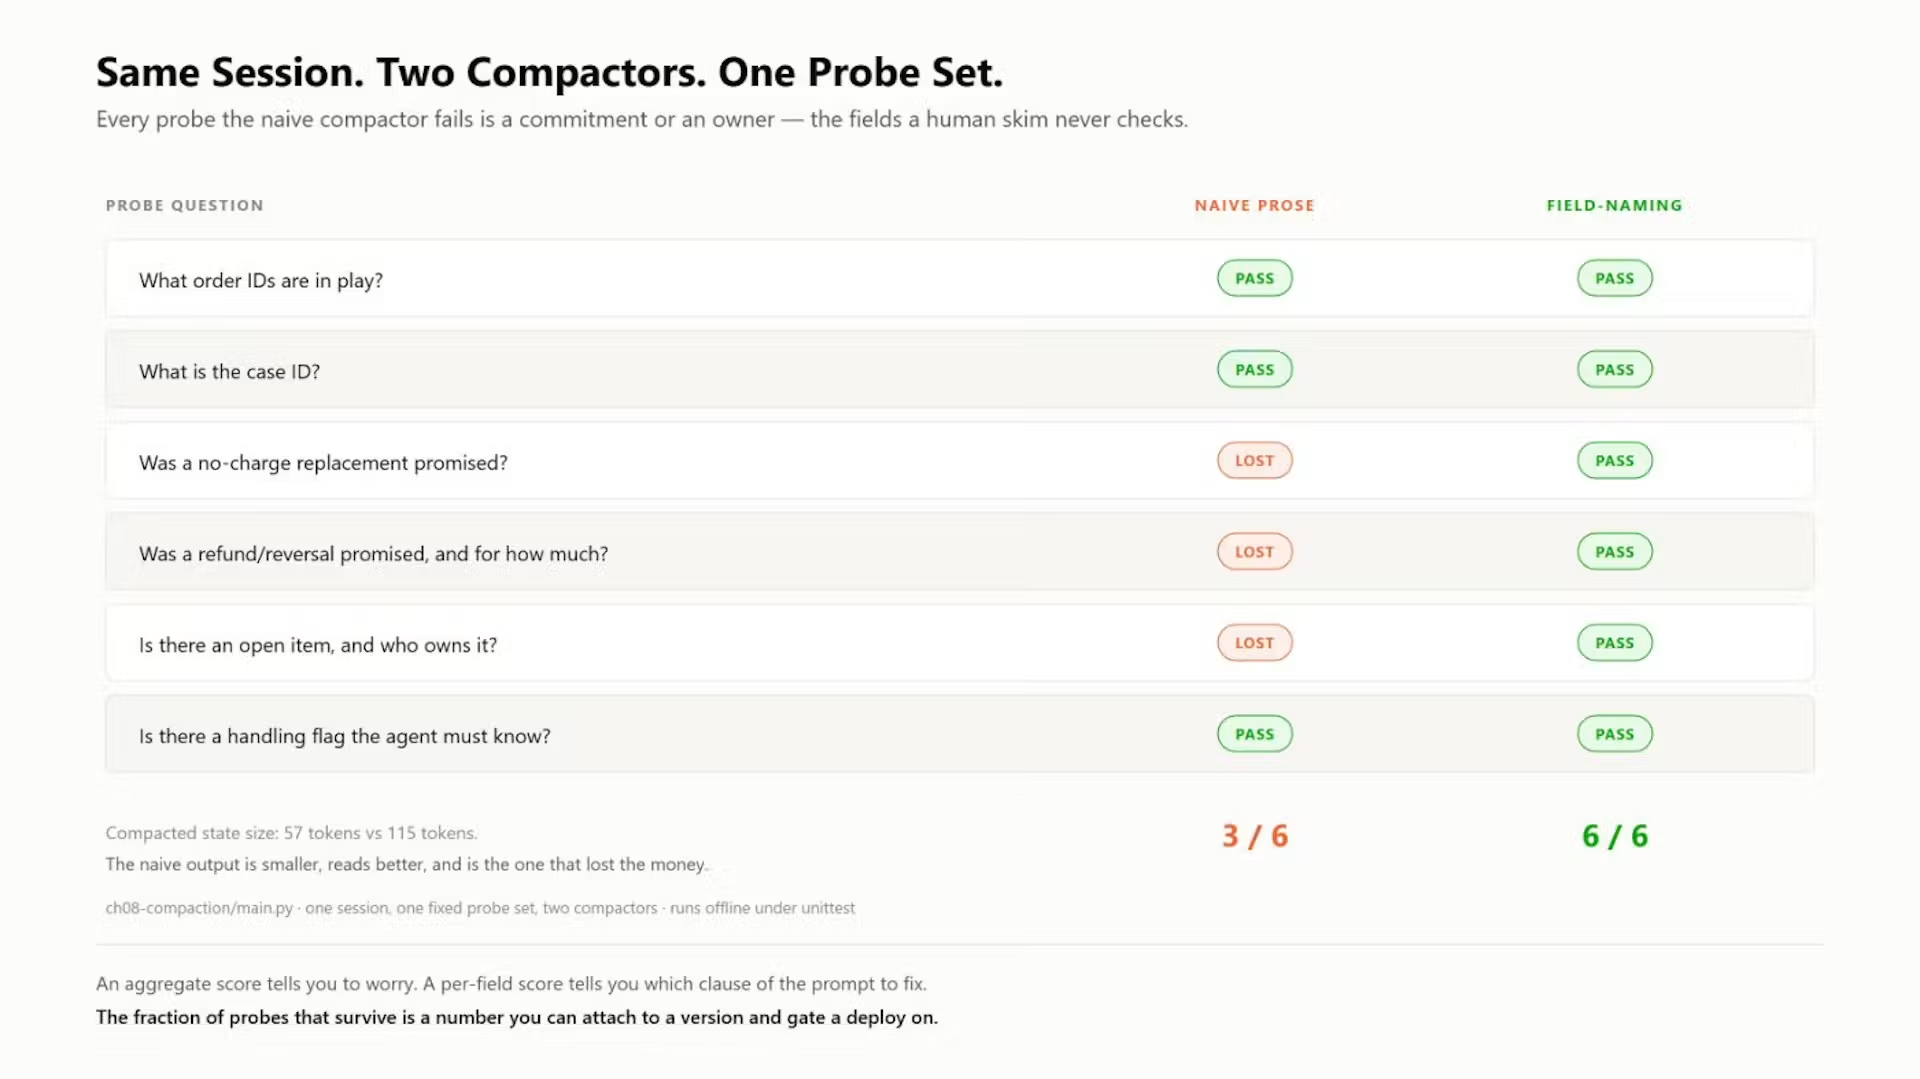
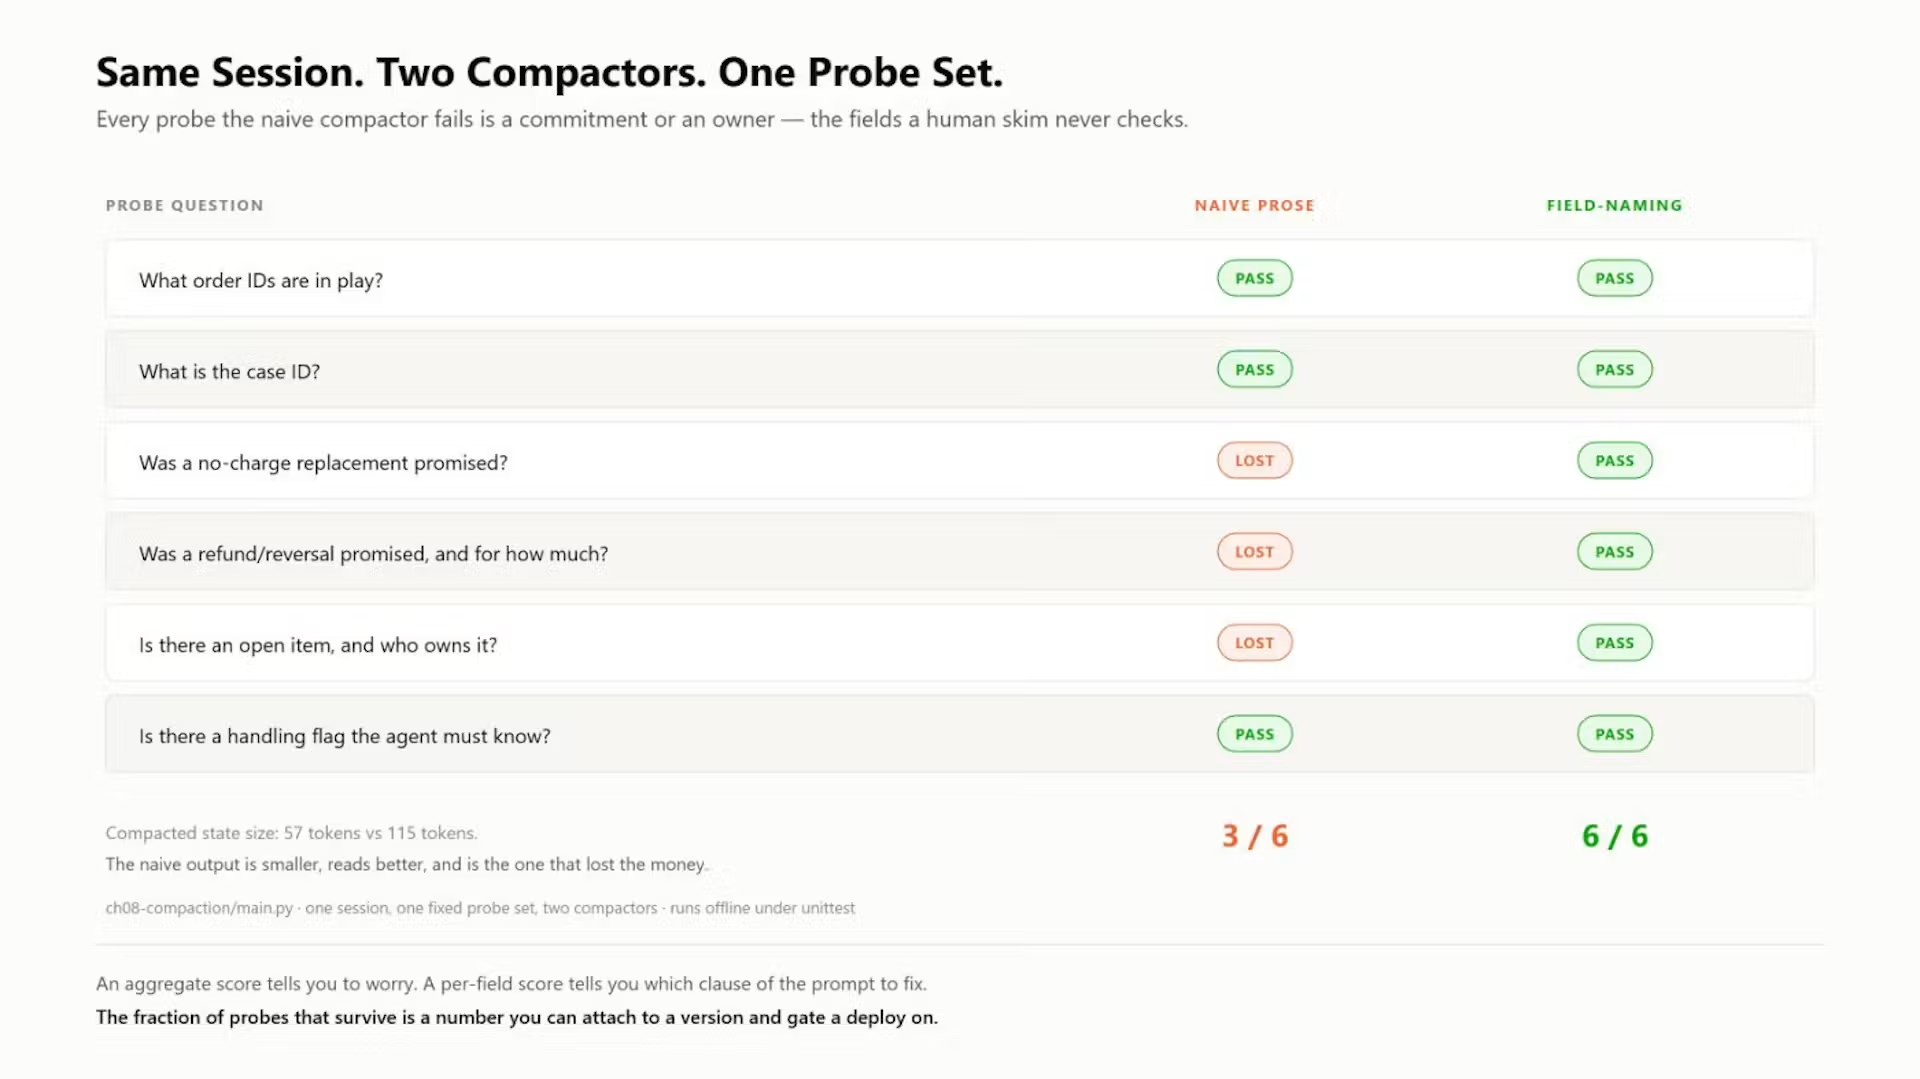
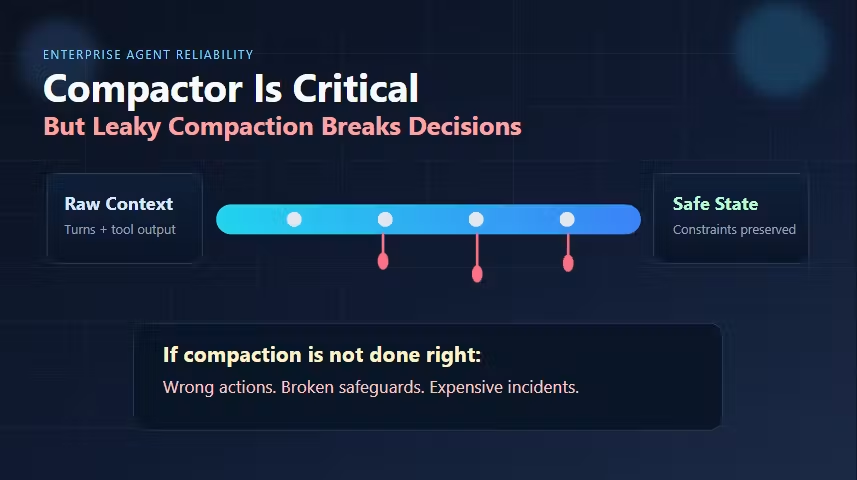
หลายเหตุการณ์ในโปรดักชันที่ดูเหมือนความฉลาดล้มเหลว จริงๆ แล้วคือการจัดบริบทพัง ผู้ช่วยถามข้อมูลที่ผู้ใช้ให้ไปแล้ว ทำผิดเงื่อนไขที่ระบุชัด หรือเสนอทางเลือกที่ขัดกับข้อตกลงก่อนหน้า ทีมมักโทษว่าโมเดลเพ้อ แต่บ่อยครั้งโมเดลกำลังทำตามบริบทที่ได้รับอย่างตรงไปตรงมา และบั๊กจริงๆ คือเครื่องมือ compaction ลบสถานะสำคัญออกไปก่อนจะเรียกโมเดล แนวคิดสำคัญคือ สรุปที่อ่านลื่นและดูครบอาจผิดเชิงการทำงานได้ เมื่อการสรุปบริบททำข้อมูลสถานะตก หลักฐานเกี่ยวกับข้อจำกัด การเจ้าของงาน หรือคำสัญญาในอดีตหายไป พฤติกรรม downstream จึงดูไร้เหตุผล ทั้งที่โมเดลตอบสอดคล้องกับบริบทที่มันเห็น ดังนั้นการจัดการข้อมูล AI ระยะยาวต้องมองการบีบอัดบริบทเป็นพื้นผิวด้านความเชื่อถือได้ ไม่ใช่แค่เรื่องใช้โทเคนให้คุ้ม และต้องย้ายจากสรุปแบบเล่าเรื่องไปสู่การสรุปเป็นสถานะชนิดมีโครงสร้างแทน
จากคำตอบสุ่มของโมเดลสู่ระบบที่เชื่อถือได้ ผ่านสัญญาเอาต์พุตและเลเยอร์การติดตามข้อมูล
อินเทอร์เฟซที่ต้องทำงานแบบกำหนดได้ เช่นหน้าจอบนมือถือ ต้องการข้อมูลที่มีรูปร่างถูกต้องเสมอ ในขณะที่โมเดลให้ข้อความที่มีรูปร่างถูกต้องส่วนใหญ่เท่านั้น ช่องว่างนี้คือจุดที่ฟีเจอร์ AI แตกเงียบในโปรดักชัน การแก้ไม่ใช่เขียนพรอมป์ใหม่ แต่คือปฏิบัติต่อเอาต์พุตของโมเดลเป็นสัญญา ที่มีสคีมา การตรวจสอบ เวอร์ชัน และกลไก fallback ชัดเจน กฎสำคัญที่สุดคือถือผลตอบโมเดลเป็นอินพุตที่ไม่ไว้ใจจนกว่าจะตรวจสอบผ่านสคีมาที่ขอบเขตเซิร์ฟเวอร์หรือเลเยอร์ที่ควบคุมได้ คำตอบ AI ที่อันตรายที่สุดคือคำตอบที่ดูดี มั่นใจ คัดลอกเข้าโค้ดหรือรายงานได้เนียน แต่ไม่ทำอะไร ไม่มี error ไม่มีคำเตือน เหล่านี้คือ failure แบบเงียบ ที่ทำให้ทีมมองหาสาเหตุผิดที่ การติดตามข้อมูลและการสังเกตการทำงานต้องพิสูจน์ว่าการเปลี่ยนแปลงเกิดจริง เช่น diff เอาต์พุต นับจำนวนแถว หรือเปิดไฟล์ที่ผลิตขึ้นแล้วหาดีเทลที่ควรเพิ่มเข้าไป ฟีเจอร์ที่แสดงข้อความควบคุมเช่น บอกให้ลองใหม่เมื่อสร้างไม่ได้จึงยังถือว่าเชื่อถือได้มากกว่าฟีเจอร์ที่แสดง JSON พาร์สครึ่งเดียว
ทำให้บั๊กสถานะมองเห็นได้ด้วย typed summaries และ regression probes
ถ้าสถานะคือหัวใจของ AI Agent สถานะ การตรวจจับบั๊กสถานะก็ต้องทำได้มากกว่าการอ่านสรุปแล้วบอกว่าดูโอเค ทีมจำนวนมากตรวจงาน compaction แบบบรรณาธิการ ถามว่าข้อความอ่านลื่นไหม ดูครบไหม แต่ระบบโปรดักชันต้องถามว่า สถานะที่จำเป็นต่อการตัดสินใจครั้งหน้ารอดมาครบหรือเปล่า แนวทางที่ดีกว่าคือย่อบริบทลงสู่สถานะที่มีชนิดชัดเจน ไม่ใช่เล่าเรื่องแบบอิสระ เพราะสรุปเชิงเล่าเรื่องดีต่อการอ่านแต่แย่ต่อการตรวจถอยหลังความผิดพลาด เครื่องมืออย่าง regression probe ช่วยให้ปัญหาสถานะวัดได้และดีบั๊กได้ พูดสั้นๆ probe คือคำถามที่รันได้บนสถานะที่ถูกบีบอัด เช่น ตรวจว่าธงข้อจำกัดยังอยู่หรือไม่ หรือเจ้าของคำสัญญายังคงถูกเก็บหรือเปล่า คะแนนจาก probe เปลี่ยนความรู้สึกว่าคุณภาพแย่หรือดีให้กลายเป็น regression ที่ชี้ได้ชัดว่าบั๊กเริ่มตรงไหน เมื่อผสานกับการจัดการข้อมูล AI ที่แยกเจ้าของสถานะ และการติดตามข้อมูลปลายทาง เราจึงสร้างระบบที่ไม่พังแบบเงียบ และมีความเชื่อถือได้ของระบบสูงขึ้นอย่างเห็นภาพ