
AI agent memory คืออะไร และทำไมการลืมจึงเป็นข้อผิดพลาดด้านสถาปัตยกรรมมากกว่าด้านโมเดล
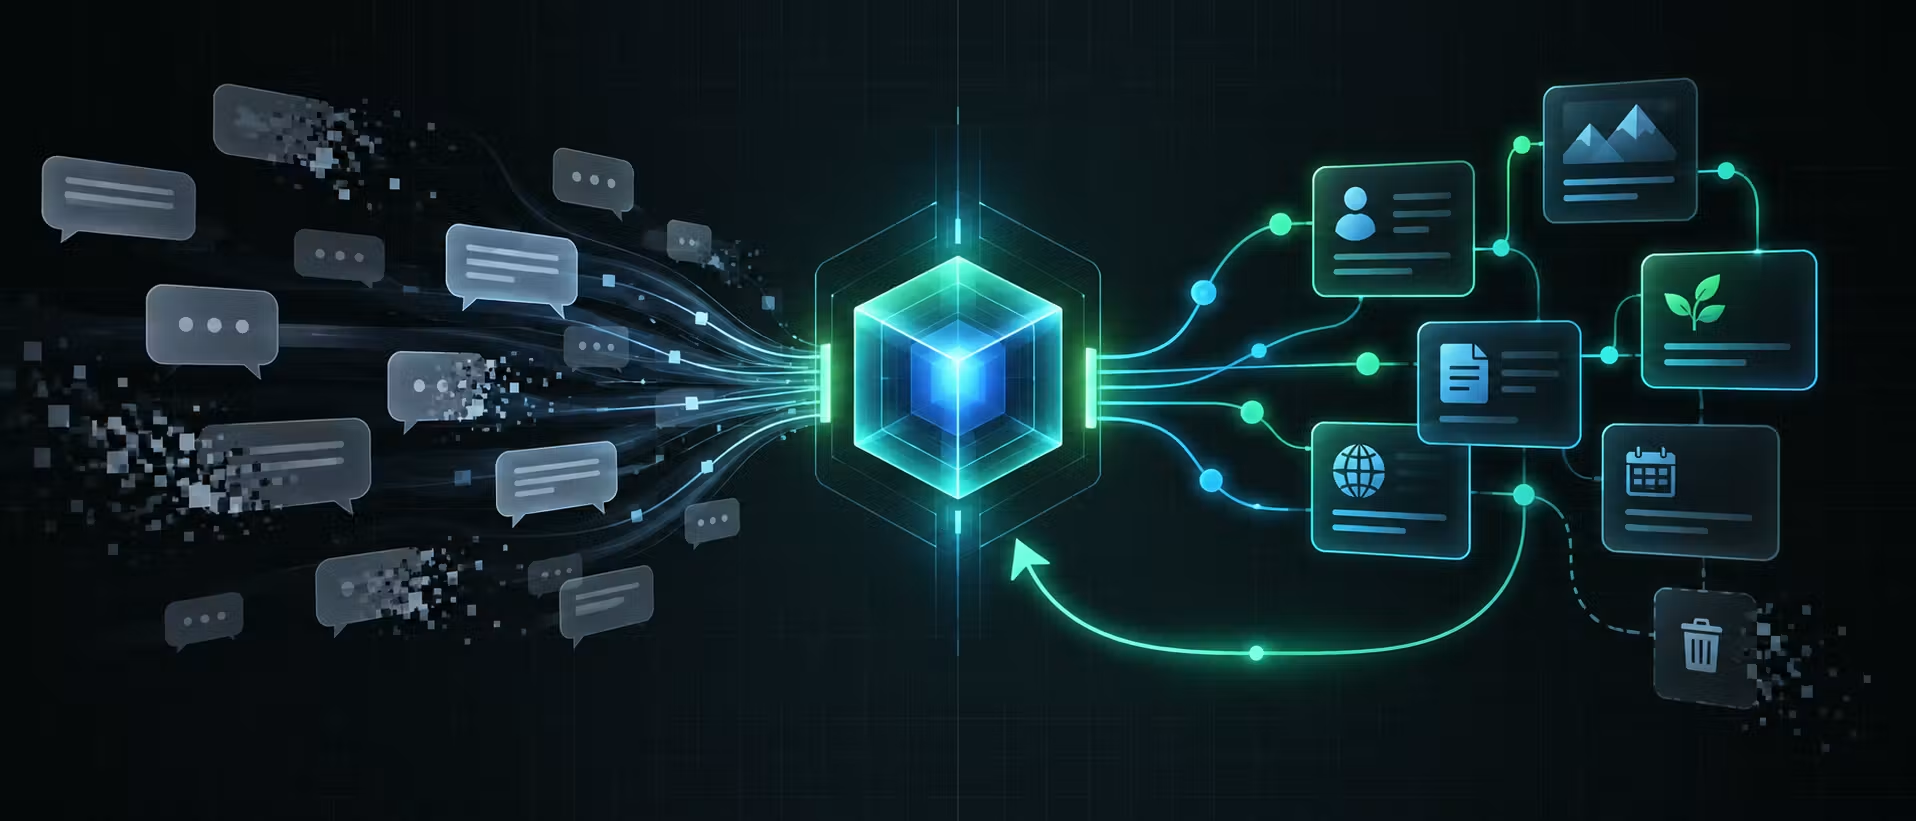
AI agent memory คือชั้นความจำของเอเยนต์ที่ใช้เก็บ ดึง และใช้บริบทจากการโต้ตอบหลายครั้งเพื่อไม่ให้ทุกเซสชันเริ่มใหม่จากศูนย์ ความจำที่ดีต้องแยกสั้นยาวออกจากกัน เรียนรู้ความชอบของผู้ใช้ ปรับตามเป้าหมายที่เปลี่ยนไป และรู้ว่าข้อมูลใดควรเก็บต่อ ข้อมูลใดควรถูกลืม เพื่อให้เอเยนต์ไม่เพียงเก่งตอนตอบครั้งเดียว แต่กลายเป็นคู่ร่วมงานที่มีความต่อเนื่อง
ปัญหาใหญ่ของ AI agent memory ในวันนี้คือเอเยนต์ส่วนมากยังทำงานแบบไร้สถานะ ทั้งที่ดูเหมือนสนทนาเก่ง ผู้ใช้เล่าพื้นหลัง อธิบายเป้าหมาย และแก้ไขเอเยนต์หลายรอบ แต่พอเซสชันจบ บริบททั้งหมดก็หายไป เซสชันถัดไปเริ่มใหม่เหมือนไม่เคยรู้จักกันเลย นี่ทำให้เอเยนต์ดูเหมือนเครื่องมือใช้แล้วทิ้งมากกว่าพันธมิตรที่เข้าใจเราในระยะยาว
ในเชิงสถาปัตยกรรม ปัญหานี้ไม่ใช่เรื่องโมเดลอย่างเดียว แต่คือการออกแบบ state management AI ที่อ่อนแอ การจัดการสถานะไม่ดีทำให้ระบบไม่รู้ว่าอะไรคือข้อกำหนดเดิม อะไรคือการตัดสินใจก่อนหน้า และอะไรคือเป้าหมายระยะยาวที่ต้องถูกพกไปในทุกก้าวของเวิร์กโฟลว์ เมื่อสถานะเหล่านี้หายไป พฤติกรรมที่ตามมาจะดูเหมือนโมเดลเหตุผลพลาด ทั้งที่จุดรั่วแท้จริงอยู่ที่ระบบความจำและสถานะของเอเยนต์
กับดัก context compaction failures: เมื่อการย่อบริบททำให้เอเยนต์โง่ลง
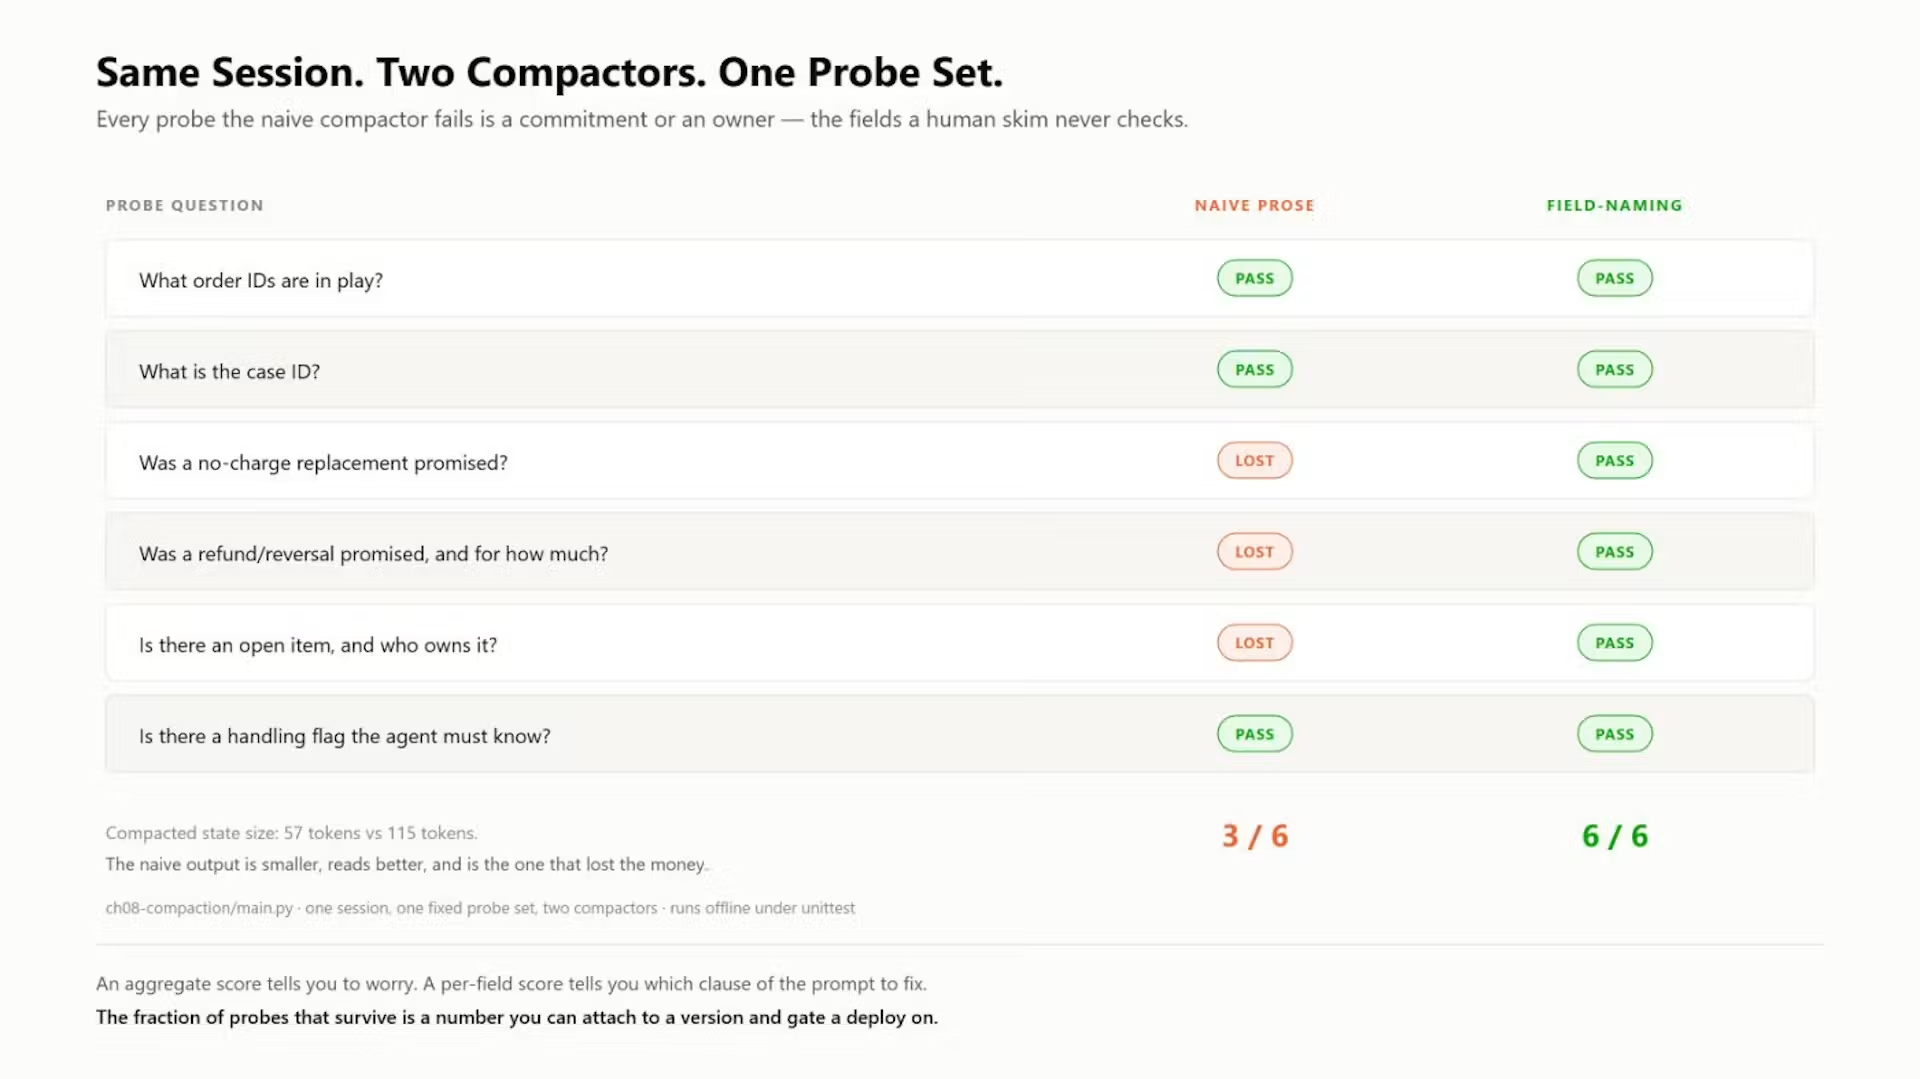
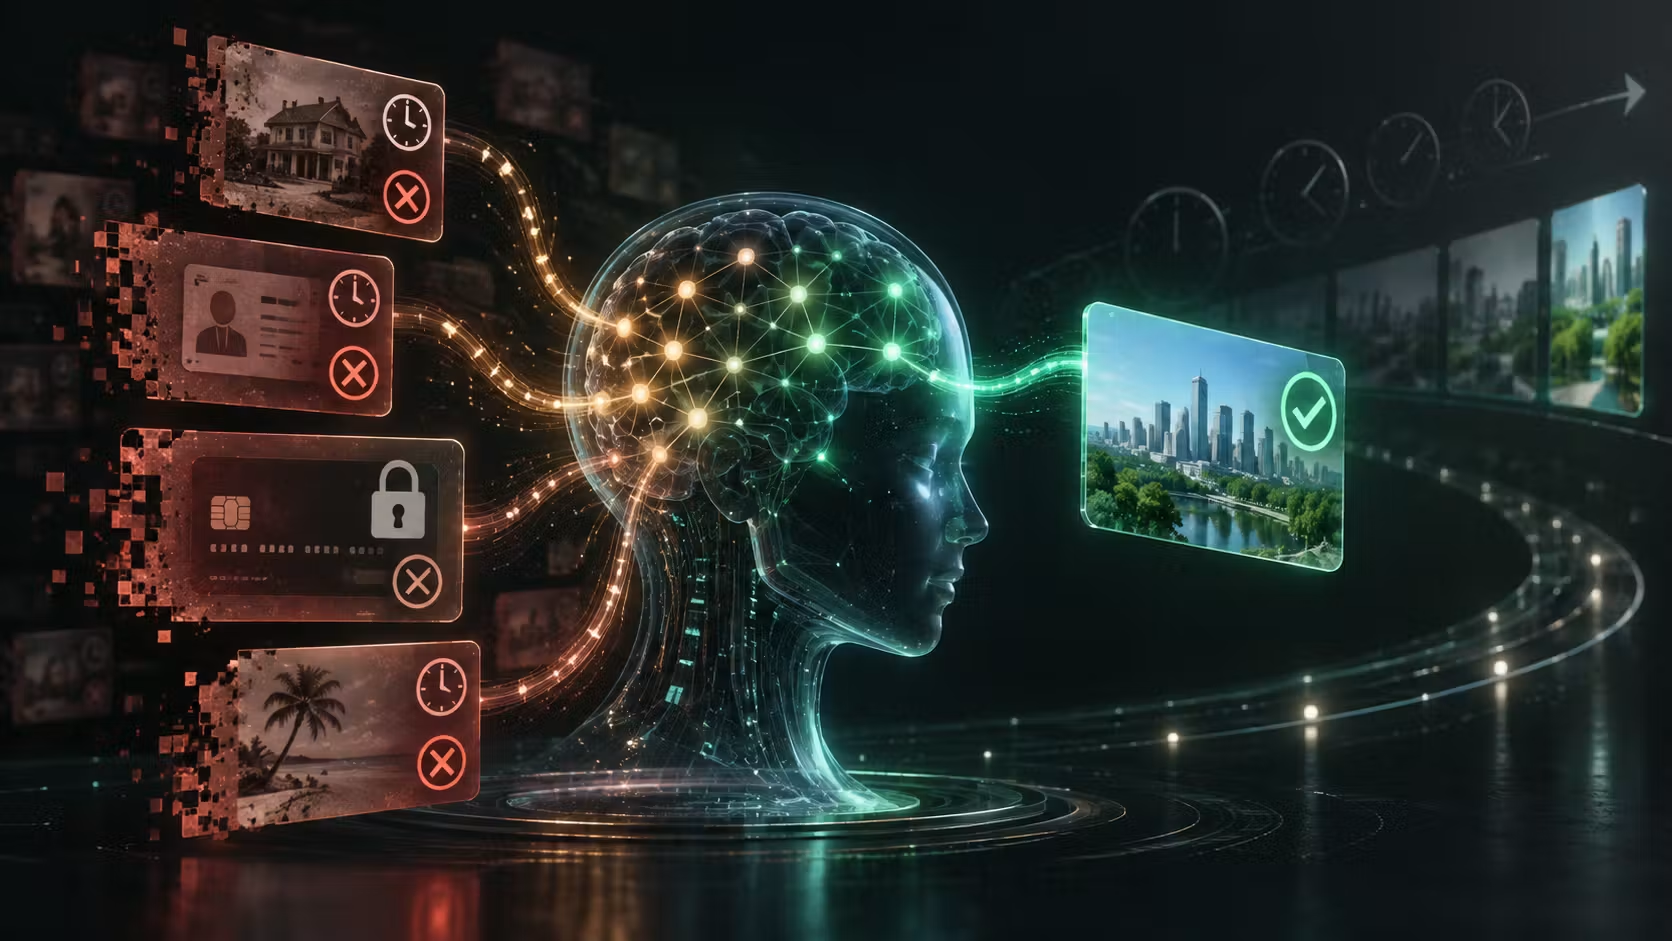
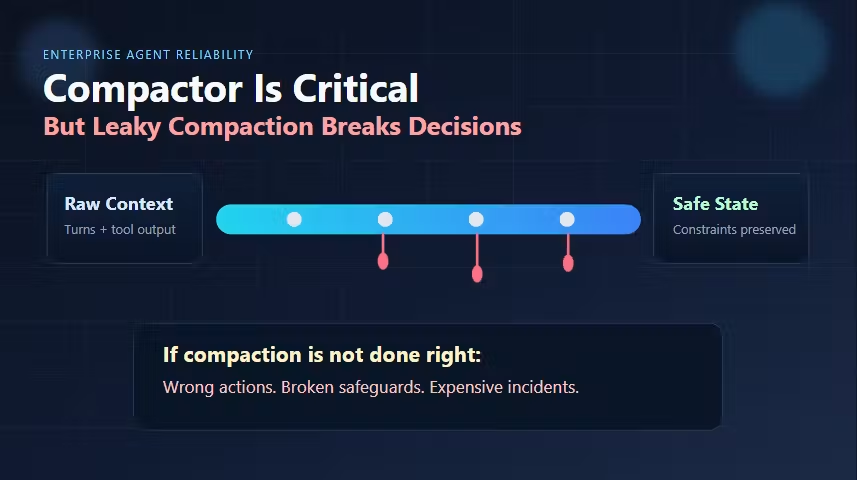
หลายทีมคิดว่าปัญหามาจาก “โมเดลหลอน” ทั้งที่ความจริงคือโมเดลตอบตามบริบทที่มันเห็น แต่บริบทนั้นถูก compact ผิดก่อนแล้ว จุดสำคัญคือ context compaction ไม่ใช่แค่ขั้นตอนลดโทเคนเพื่อประหยัดค่าเรียกโมเดล แต่เป็นพื้นผิวด้าน AI agent reliability ทั้งระบบ เพราะถ้าเราย่อผิดเราก็ตัดสินใจผิดตามไปด้วย
คำอธิบายที่อ่านลื่น ไม่ได้แปลว่าถูกในเชิงปฏิบัติการ readable summaries สามารถผิดในเชิงสถานะได้ง่าย โดยเฉพาะฟิลด์ที่ไม่ค่อยถูกพูดถึงในข้อความแต่สำคัญต่อการลงมือ เช่น เงื่อนไขการอนุมัติ ขีดจำกัด rollback เจ้าของการ escalation หรือข้อจำกัดด้าน compliance ฟิลด์แบบนี้มักเป็นสิ่งแรกที่หายไปตอนย่อเป็นคำบรรยาย พอสถานะเหล่านี้หลุด downstream behavior ก็จะดูไร้เหตุผล ทั้งที่โมเดลทำตามอินพุตที่ได้รับอย่างซื่อสัตย์
สิ่งที่ทำให้เรื่องเลวร้ายขึ้นคือ tool payload มักกินพื้นที่บริบทมากกว่าประวัติสนทนา ทำให้ระบบพยายามบีบสิ่งที่สำคัญที่สุดออกไปก่อนเพื่อหลีกทางให้ข้อมูลเครื่องมือ ผลลัพธ์คือเอเยนต์ลืมเงื่อนไขสำคัญ ลืมข้อตกลงเก่า และตัดสินใจแบบแปลกตาแม้เวิร์กโฟลว์จะดูสมบูรณ์บนกระดาษ
state management AI ที่ดีต้องวัดได้: FRESH Memory Model และ typed summaries
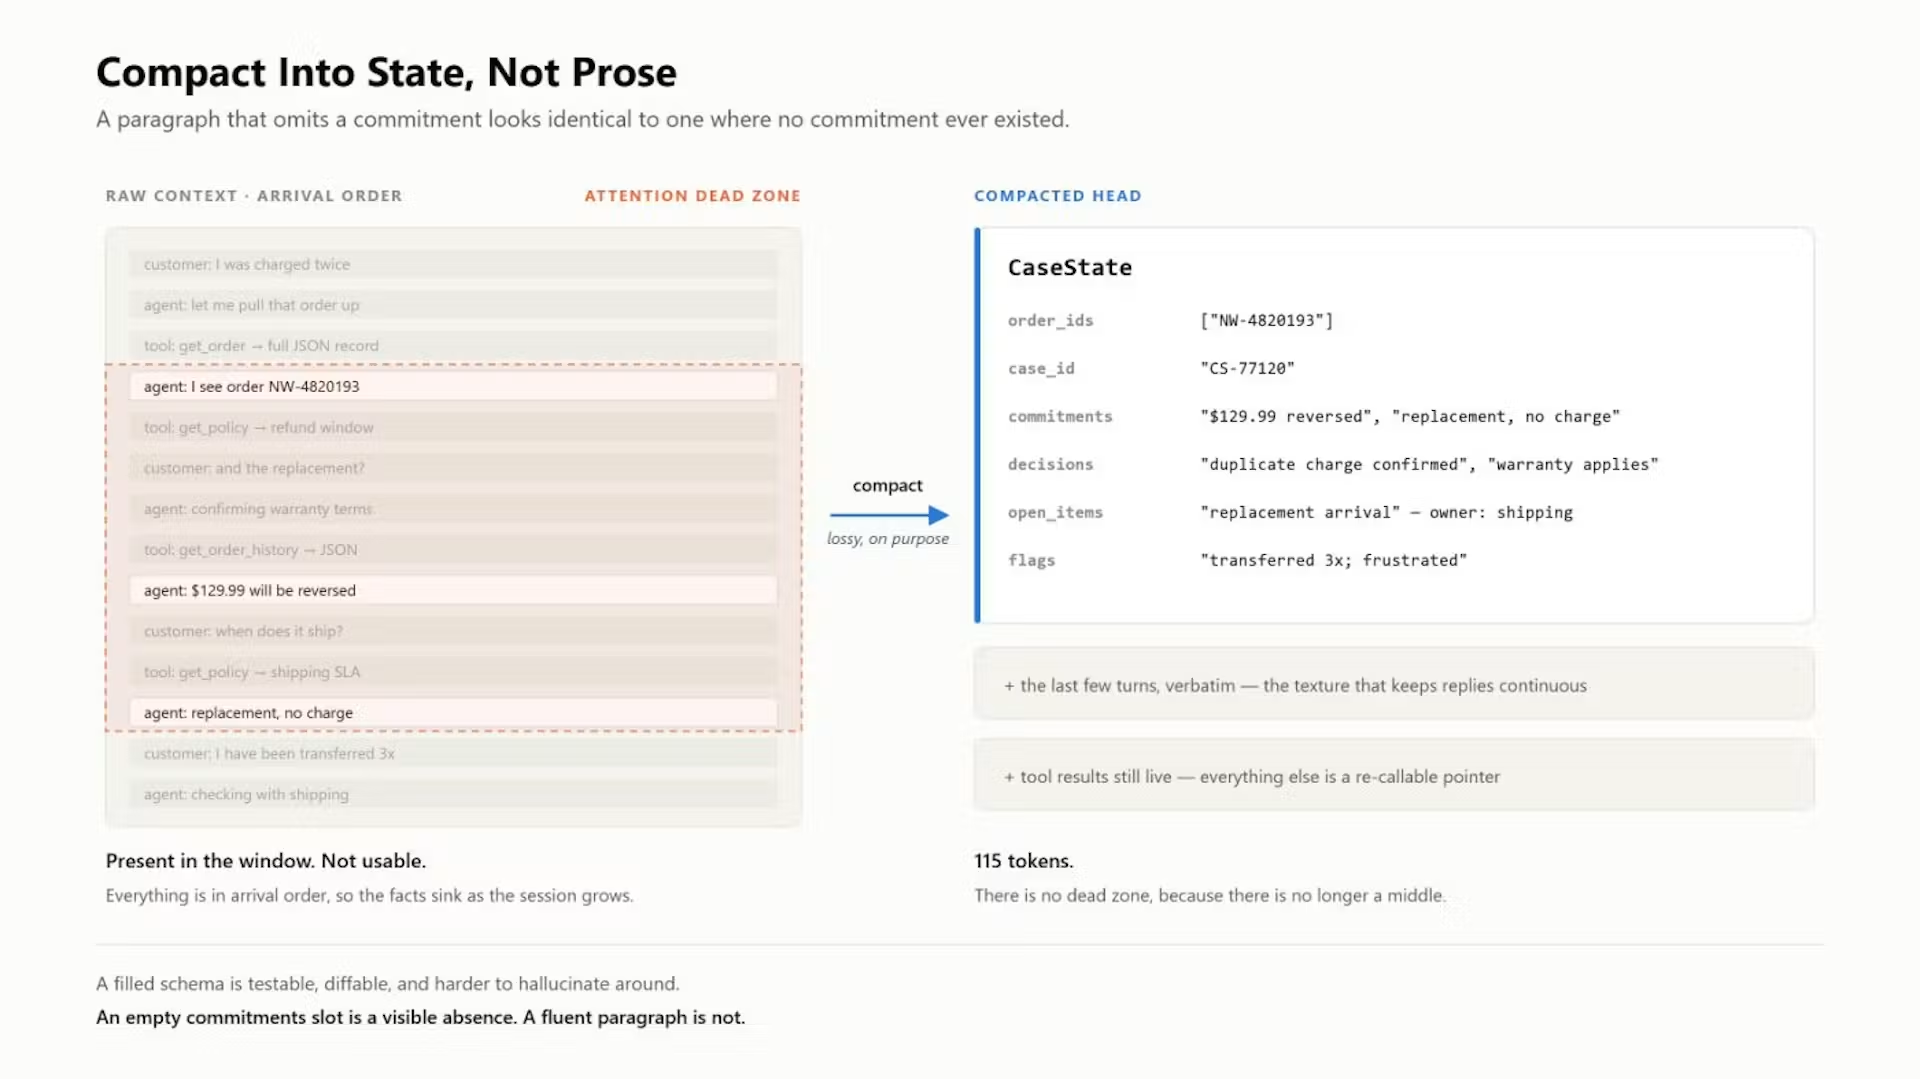
หากอยากหยุดโทษโมเดลและเริ่มแก้ที่ระบบ เราต้องทำให้ความล้มเหลวของความจำวัดและทดสอบได้ แนวทางหนึ่งคือเปลี่ยนจาก narrative summary แบบเล่าเรื่อง ไปสู่ typed state ที่กำหนดสคีมาไว้ชัดเจนว่าเอเยนต์ต้องจำอะไรบ้างในแต่ละเวิร์กโฟลว์ เมื่อบังคับให้ compactor เติมฟิลด์ตามสคีมา เราจะเห็นช่องว่างว่าฟิลด์ไหนหาย บันทึกอะไรไม่ครบ และค่าไหนผิดประเภท
การ compact เข้าสู่ typed state ทำให้ผลลัพธ์ตรวจด้วยเครื่องได้ทันที ความถูกต้องกลายเป็นสิ่งที่เขียนเทสต์ได้ ไม่ใช่การอ่านคร่าวๆ แล้วบอกว่า “ดูโอเค” การใช้ regression probes ช่วยให้เราวัดได้ว่ารุ่น compactor ใหม่ทำให้ฟิลด์สำคัญหายหรือบิดเบี้ยวหรือไม่ ทำให้การเปลี่ยนเวอร์ชันไม่ใช่การเสี่ยงดวงในโปรดักชัน แต่เป็นการอัปเดตที่มีสัญญาณชัด
ในระดับแนวคิด FRESH Memory Model มองว่าปัญหาไม่ใช่การทำให้เอเยนต์จำทุกอย่าง แต่คือการตัดสินใจว่าควรเก็บอะไร ปล่อยอะไร และอะไรถูกแทนที่ไปแล้ว อุตสาหกรรมใช้คำว่า “memory” เป็นเส้นชัยมาหลายปี ทั้งที่เป้าหมายที่ยากกว่าคือ “จะเก็บอะไรและปล่อยอะไร” ซึ่งนี่ต่างหากที่จะทำให้ระบบเหล่านี้น่าเชื่อถือหรือไม่
จากโมเดลสู่ระบบ: ทำไม enterprise AI systems ต้องเริ่มจาก observability และการจัดการอินเตอร์เฟซ
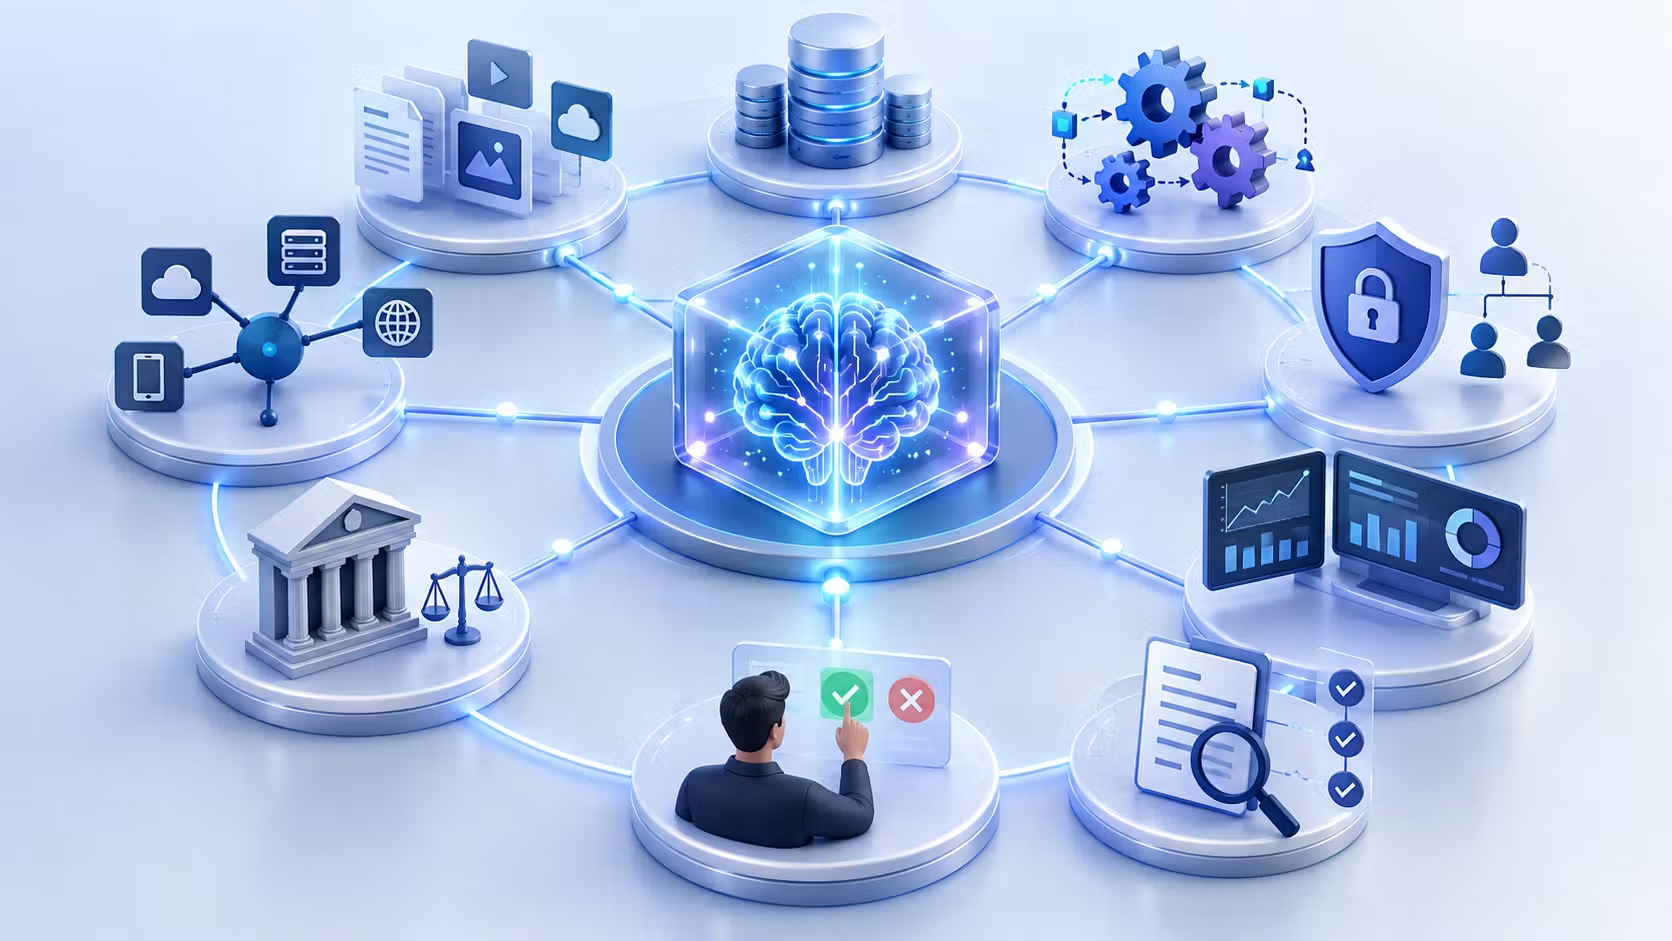
ในองค์กร สนทนาเรื่อง AI มักวนอยู่ที่การเลือกโมเดล เปรียบเทียบขนาด context window หรือถกเรื่อง open source เทียบกับ closed source แต่ประสบการณ์จากระบบจริงชี้ว่าคำถามแรกควรเป็น “เอเยนต์เห็นข้อมูลที่ต้องใช้ตัดสินใจครบไหม” ข้อมูลใน enterprise AI systems ไม่ได้อยู่ที่เดียว มันกระจายตาม API internal services ไฟล์คอนฟิก runbook เอกสารผลิตภัณฑ์ ทิคเก็ต และความรู้ในหัววิศวกรบางคน
แหล่งข้อมูลเหล่านี้ยังเปลี่ยนด้วยความเร็วไม่เท่ากัน ทำให้เอกสารสองชุดที่ดูเป็นทางการอาจขัดแย้งกันได้ โมเดลภาษาไม่ได้แก้ปัญหานี้ มันแค่ให้เหตุผลบนข้อมูลที่ได้รับ ถ้าข้อมูลเก่า ซ้ำ หรือขัดกัน เอเยนต์ก็จะตอบผิดอย่างมั่นใจได้ง่าย สิ่งสำคัญจึงไม่ใช่ความฉลาดของโมเดลอย่างเดียว แต่คือ engineering layer รอบโมเดลที่รับผิดชอบ context security orchestration governance integration monitoring และ reliability
ในคำพูดหนึ่งที่ควรจดจำ “ความสำเร็จระยะยาวของ enterprise AI อาจขึ้นกับวินัยเชิงปฏิบัติการมากกว่าความซับซ้อนของโมเดล” ระบบที่เชื่อถือได้ต้องมี observability เต็มรูปแบบ เห็นได้ว่าเอเยนต์ไปเอาคำตอบจากไหน แหล่งนั้นใครดูแล เปลี่ยนบ่อยแค่ไหน และเกิดอะไรขึ้นเมื่อแหล่งข้อมูลขัดแย้งกัน ต้องมีบันทึกชัดว่าระบบทำอะไร ทำไม และใครอนุมัติ โดยเฉพาะเมื่อมีการเรียกใช้เครื่องมือหรือบริการอื่นผิดพลาด
ออกแบบเอเยนต์ให้ไม่พังอินเตอร์เฟซธุรกิจ: schema ที่เข้ม เทสต์ที่ดี และทางหนีทีไล่ที่ปลอดภัย
AI agent reliability ไม่ได้จบที่ความจำหรือบริบท แต่ไปจบที่ว่าผลลัพธ์แบบ probabilistic ของโมเดลไปชนกับอินเตอร์เฟซธุรกิจแบบ deterministic อย่างไร หากเราปล่อยให้เอเยนต์ยิง payload แบบสุ่มโครงสร้างเข้าสู่ API ภายใน ความเสียหายที่เกิดขึ้นอาจไม่ใช่แค่คำตอบผิด แต่คือเวิร์กโฟลว์เชิงธุรกิจที่พังทั้งเส้น
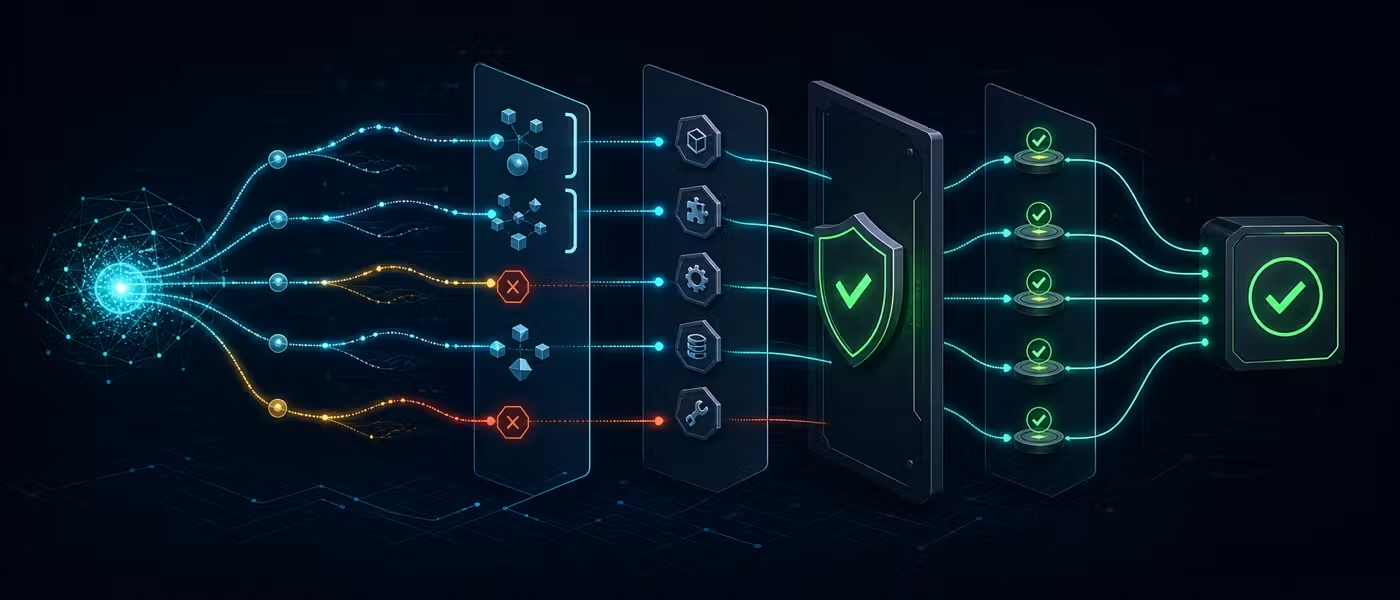
ทางออกคือออกแบบ schema ชัดเจนแล้วบังคับโมเดลเข้ารูป จากนั้นใช้ validation เพื่อเช็กว่า typed state หรือ payload ที่โมเดลสร้างนั้นถูกต้องและครบถ้วนหรือไม่ เมื่อทุกอย่างอยู่ในรูปแบบที่เครื่องตรวจสอบได้ ความถูกต้องจึงไม่ใช่เรื่องความรู้สึก แต่กลายเป็นสิ่งที่เทสต์อัตโนมัติและ static checks ตรวจได้ การมี fallback ที่ปลอดภัย เช่น ปฏิเสธคำสั่งเมื่อ validation ไม่ผ่าน หรือให้มนุษย์ตรวจ ก่อนเรียกใช้เครื่องมือสำคัญ ช่วยกันไม่ให้เอาต์พุตของโมเดลไปหักอินเตอร์เฟซทางธุรกิจโดยไม่ตั้งใจ
โมเดลที่ดีกว่ามีประโยชน์ แต่การเปลี่ยนโมเดลไม่เคยแก้บริบทที่พัง เอกสารที่ล้าสมัย retrieval ที่อ่อน สิทธิ์เข้าถึงที่ผิด หรือการขาด observability หาก enterprise AI systems อยากเปลี่ยนจาก prototype ไป production สิ่งที่ควรลงทุนคือระบบรอบโมเดล ตั้งแต่ state management AI การย่อบริบทแบบมีสคีมา ไปจนถึงสายการตรวจสอบที่ทำให้ทุกความผิดพลาดวัดและเรียนรู้ได้ เมื่อถึงจุดนั้น AI agents จะเลิกเป็นผู้ช่วยขี้ลืม และกลายเป็นระบบที่องค์กรไว้ใจได้ในระยะยาว