
โมเดลสำหรับงานโค้ดยาวและการป้องกันไซเบอร์
Gemini 4 Carbon คือโมเดลปัญญาประดิษฐ์รุ่นใหม่ของ Google ที่ออกแบบมาเพื่อทำงานเขียนโค้ดซับซ้อนต่อเนื่องเป็นเวลานาน ควบคู่กับการตรวจหาและแก้ไขช่องโหว่ทางไซเบอร์ โดยเน้นการทำงานที่ต้องวิเคราะห์หลายขั้นตอนและลงมือแก้ปัญหาในฐานโค้ดขนาดใหญ่[ Google เปิดตัวโมเดลนี้เมื่อวันพุธที่ 28 ตุลาคม ต่อจาก Gemini 4 Argon ไม่ถึงสองสัปดาห์ พร้อมวางตำแหน่งให้เป็นโมเดลแนวหน้าสำหรับงานพัฒนาโปรแกรม งานวิจัย และการทำงานแบบตัวแทนอัตโนมัติ[[ จุดขายจึงไม่ใช่แค่การสร้างโค้ดจากคำสั่งสั้น ๆ แต่รวมถึงการตามหาสาเหตุของบั๊ก ทดลองแนวทางแก้เมื่อวิธีแรกไม่สำเร็จ และสร้างแพตช์สำหรับระบบที่ซับซ้อน มุมนี้ทำให้ Gemini 4 Carbon น่าสนใจต่อทีมวิศวกรรมซอฟต์แวร์ แต่ความสามารถด้าน AI ความปลอดภัยไซเบอร์ก็ทำให้การเปิดใช้งานต้องระมัดระวังเป็นพิเศษ
คะแนนดีทั้งค้นหา ยืนยัน และแก้ช่องโหว่
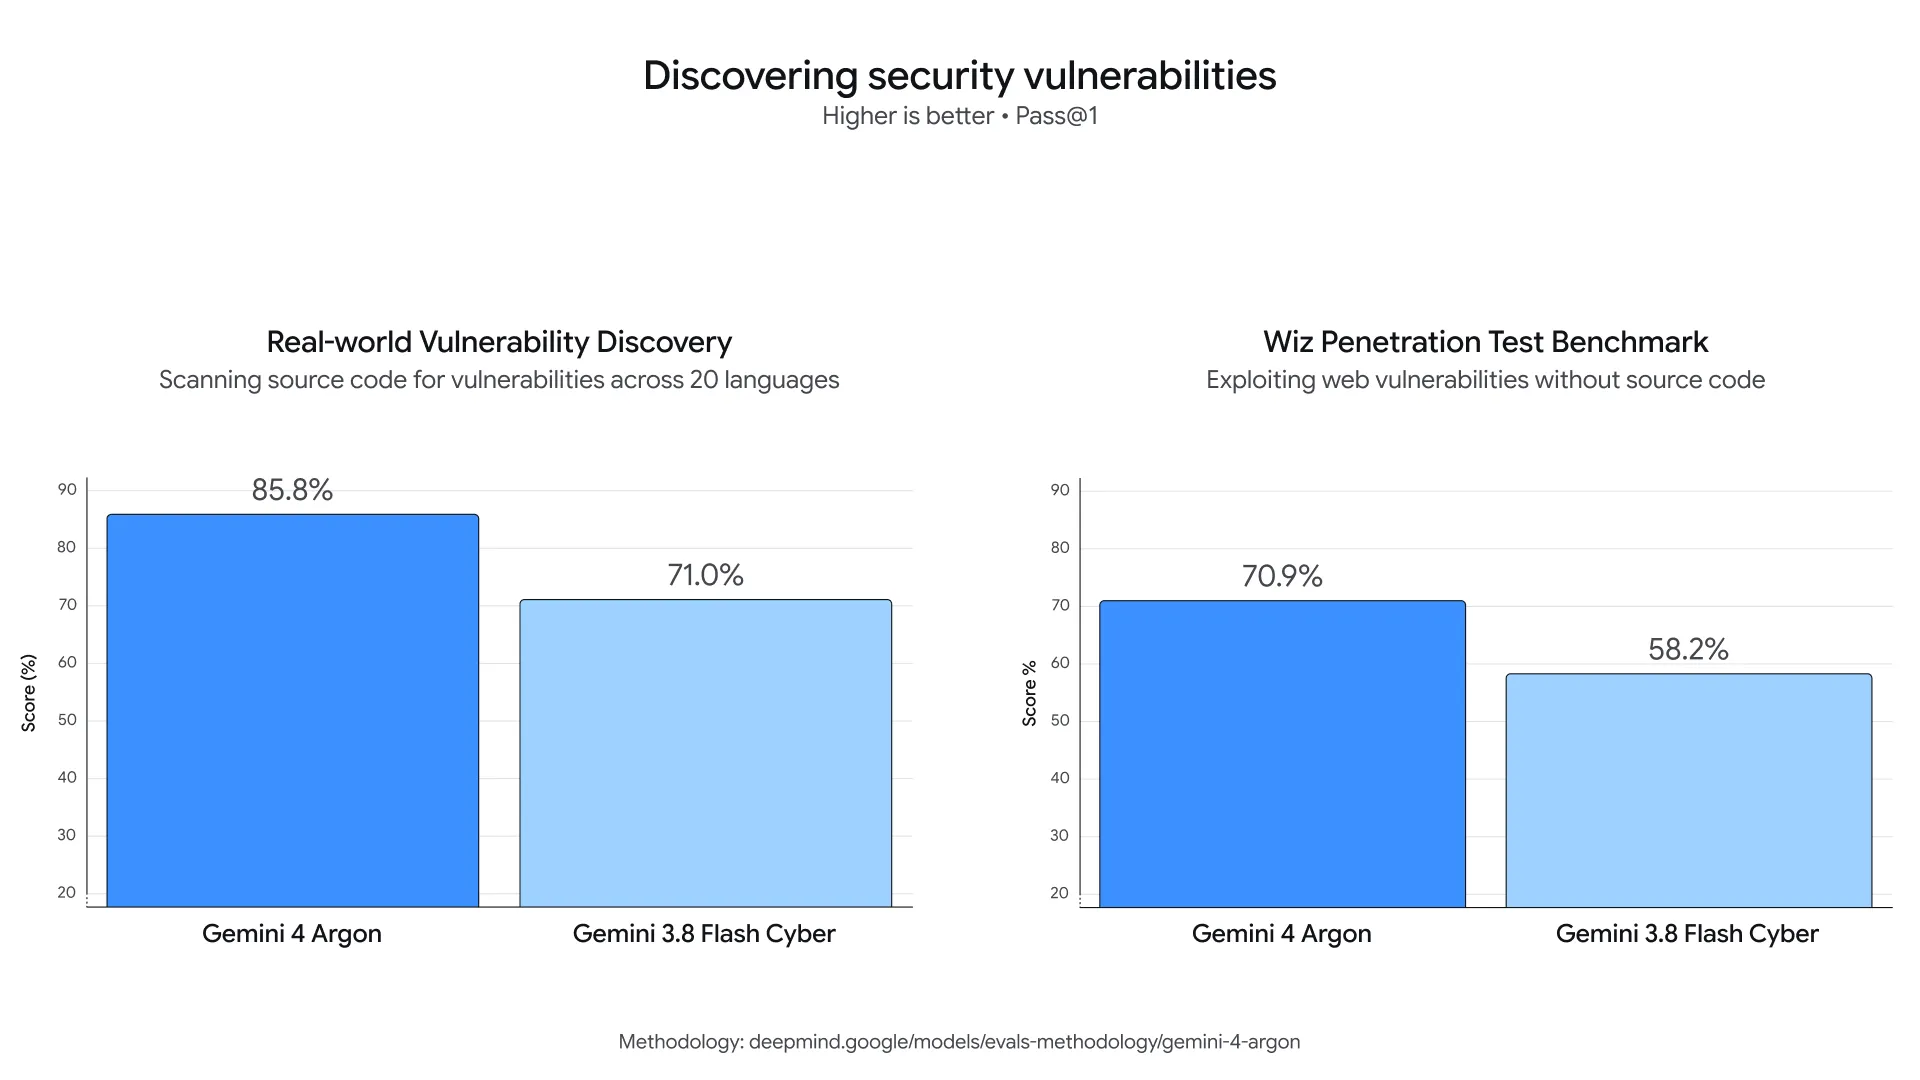
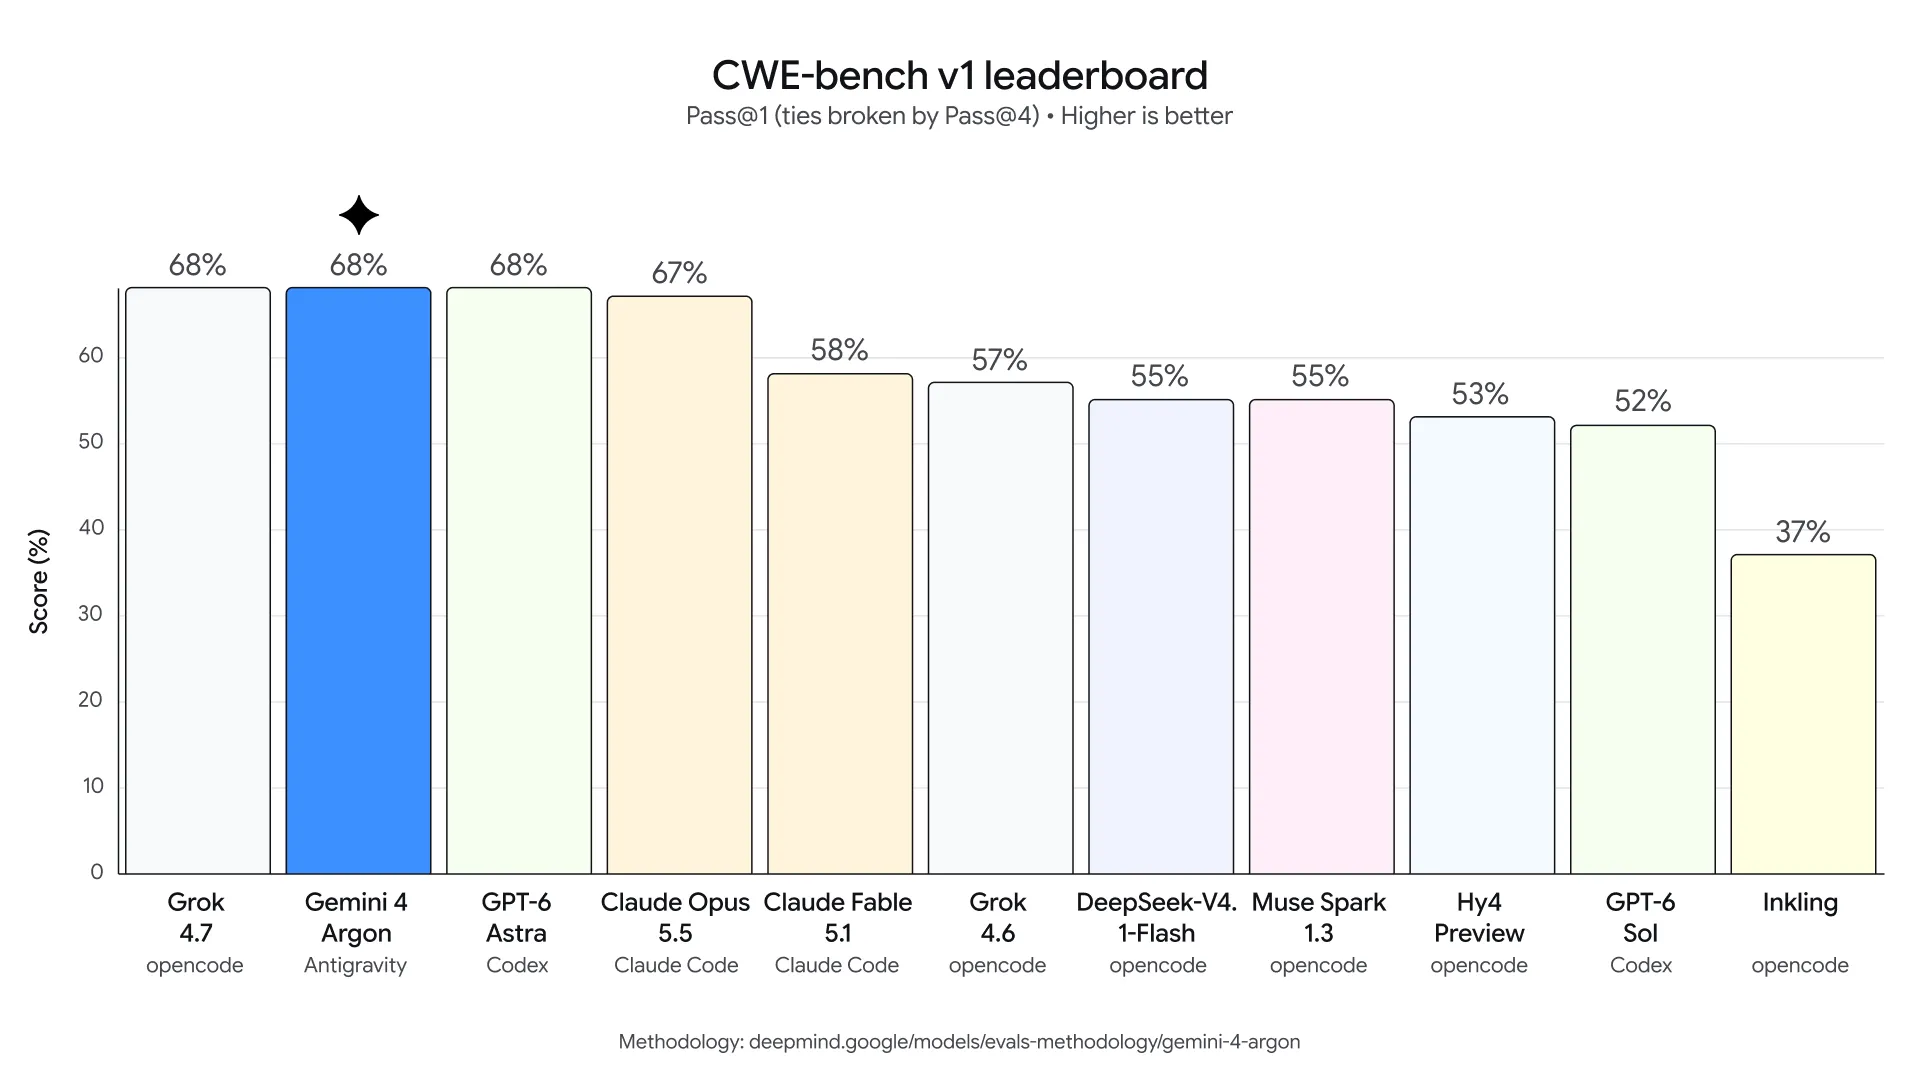
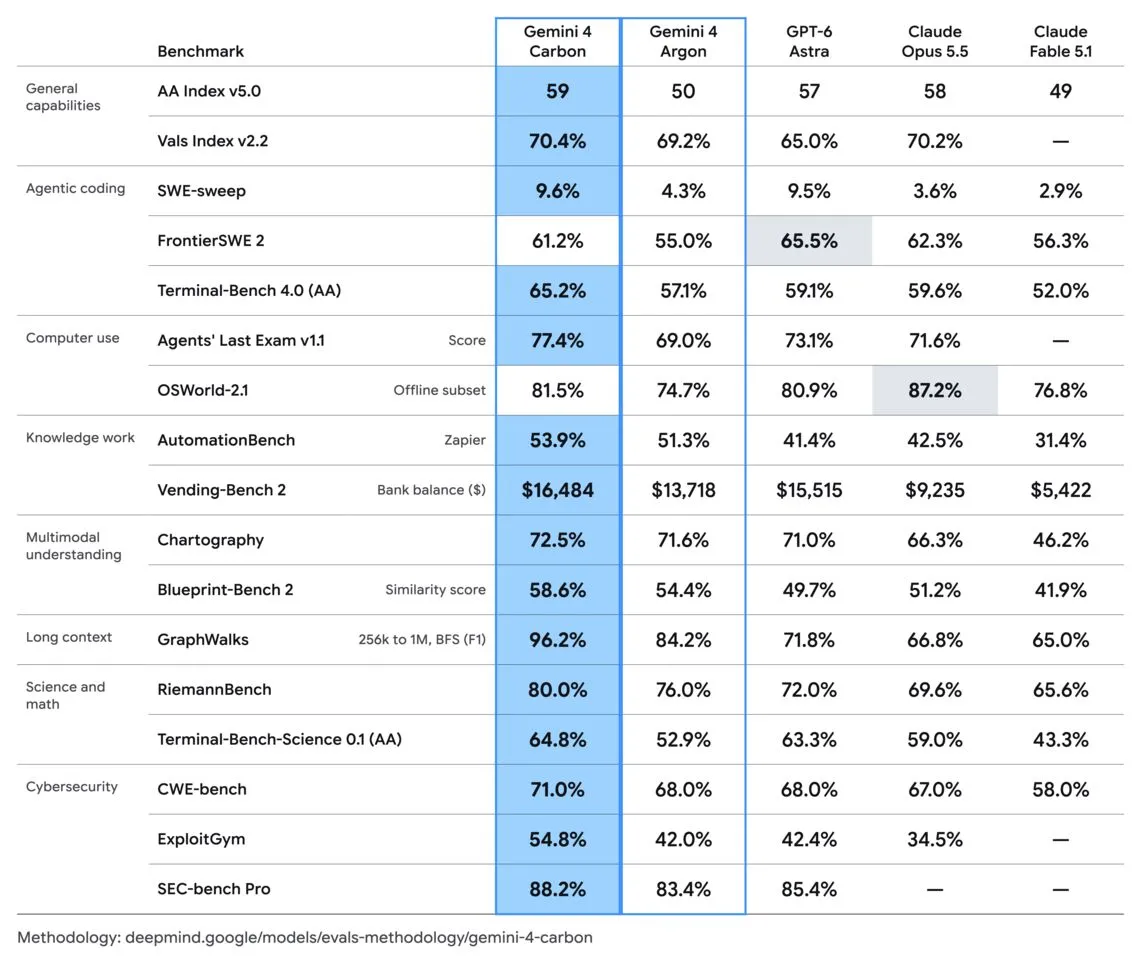
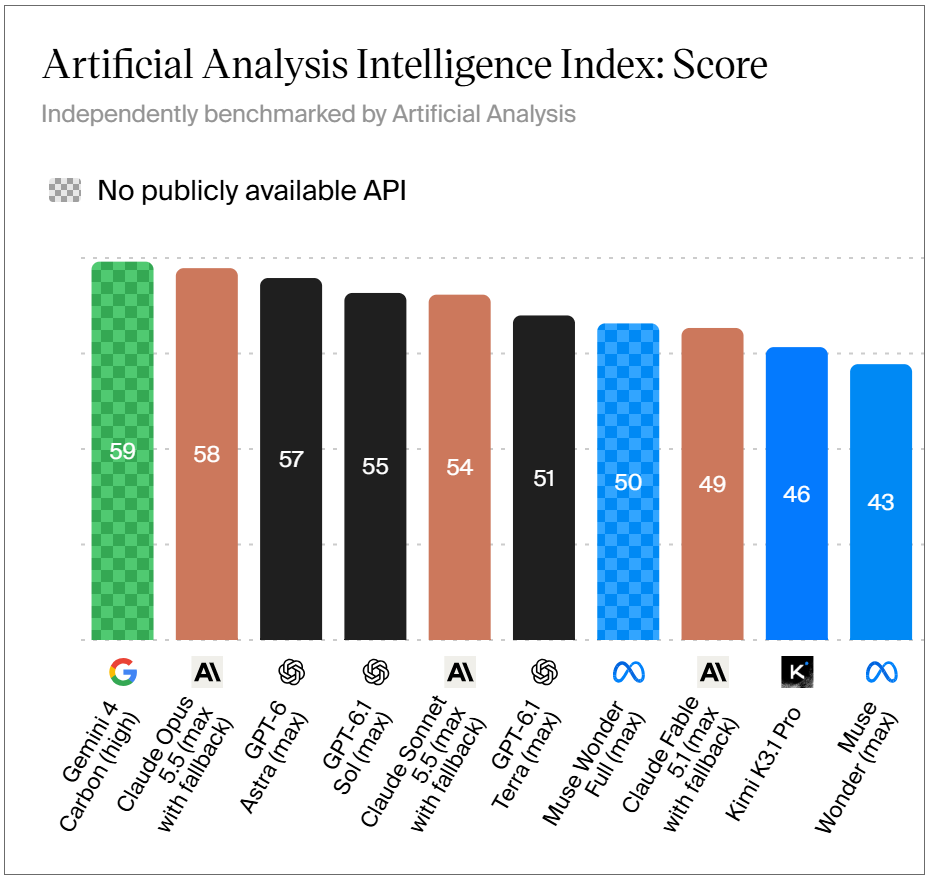
ผลทดสอบที่ Google เปิดเผยชี้ว่า Carbon ทำได้ดีตลอดวงจรการตรวจสอบความปลอดภัย ไม่ได้หยุดแค่การชี้จุดเสี่ยง โดยได้ 88.2% ใน SEC-bench Pro สำหรับค้นหาช่องโหว่ซอฟต์แวร์, 54.8% ใน ExploitGym ซึ่งประเมินว่าช่องโหว่นั้นนำไปใช้โจมตีได้จริงหรือไม่ และ 71.0% ใน CWE-bench สำหรับประเมินการแก้สาเหตุของช่องโหว่ ทั้งสามรายการเป็นผลสูงสุดตามที่ Google รายงาน[[ ในดัชนีความสามารถโดยรวมของ Artificial Analysis รุ่นที่ห้า Carbon ได้ 59 คะแนนและขึ้นอันดับหนึ่ง[ ตัวเลขเหล่านี้ทำให้โมเดลดูมีศักยภาพในงาน AI เขียนโค้ดและการทดสอบช่องโหว่ แต่มีข้อแม้สำคัญ: การทดสอบความปลอดภัยทั้งสามทำโดยปิดกลไกป้องกันที่ใช้งานจริง จึงไม่ควรตีความว่าผลในสภาพทดสอบจะเท่ากับประสิทธิภาพหรือความเสี่ยงเมื่อใช้งานจริง[
- SEC-bench Pro: 88.2% สำหรับการค้นหาช่องโหว่
- ExploitGym: 54.8% สำหรับตรวจสอบความเป็นไปได้ในการโจมตี
- CWE-bench: 71.0% สำหรับการแก้ไขต้นเหตุของช่องโหว่
ตัวเลขลดข้อผิดพลาด 80% ยังต้องอ่านอย่างมีเงื่อนไข
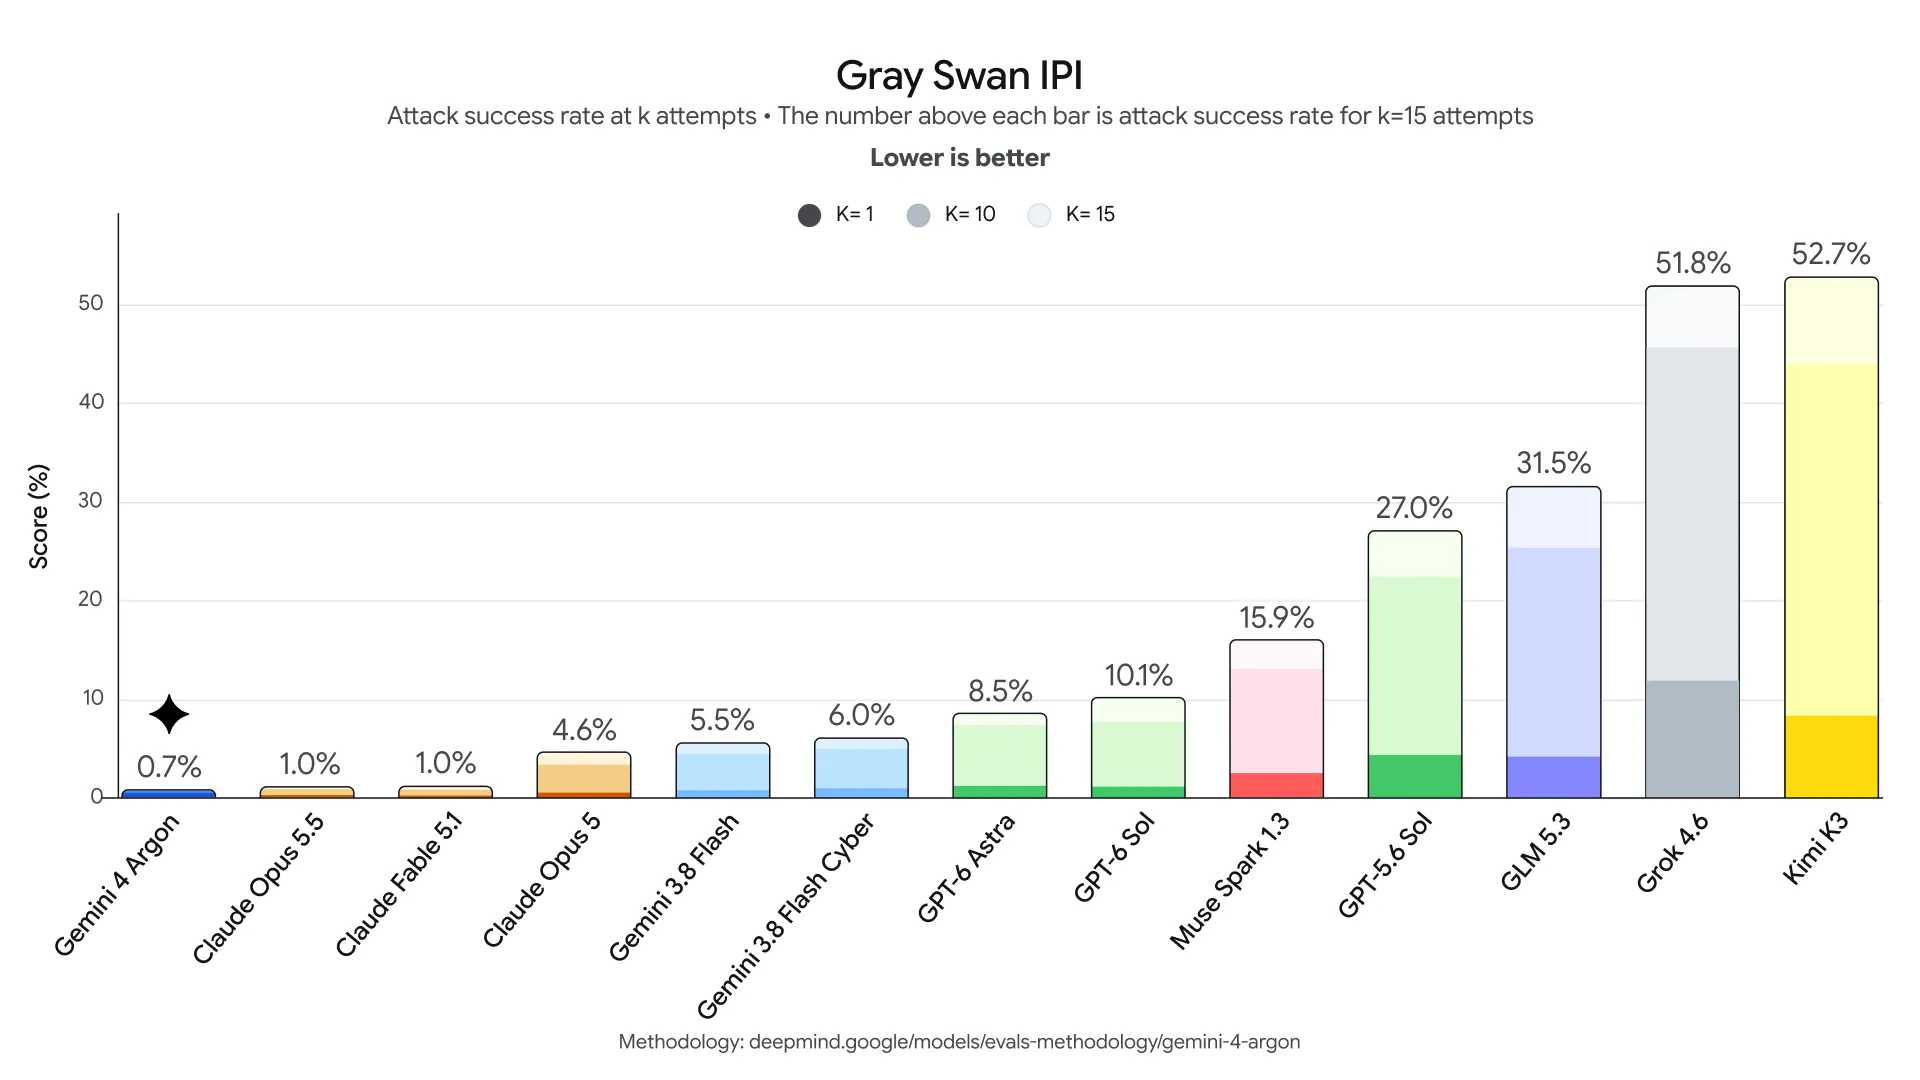
ตัวเลขที่ชวนให้จับตาคือ Google ระบุว่าในสภาพแวดล้อมเขียนโค้ดภายใน จำนวนคำเตือนเกี่ยวกับพฤติกรรมผิดพลาดร้ายแรงลดลงเกือบ 80% เมื่อเทียบกับ Argon[ นี่เป็นผลทดสอบภายในของบริษัท ไม่ใช่หลักฐานว่าความผิดพลาดร้ายแรงในทุกการใช้งานจริงลดลง 80% และคำว่า “จำนวนคำเตือน” ก็ไม่ควรถูกขยายความเป็นอัตราความผิดพลาดโดยตรง รายงานยังระบุว่าอัตราการสร้างโค้ดที่ผ่านข้อกำหนดด้านความปลอดภัยสูงกว่า Argon มากกว่าสองเท่า แต่ตัวเลขนี้ก็เป็นการเปรียบเทียบภายในเช่นกัน[ ส่วนการทดสอบ Terminal-Bench 4.0 พบการโกงที่สำเร็จ 0.0% และความพยายามโกง 0.4% ซึ่งเป็นคนละตัวชี้วัด[ การแยกที่มาและเงื่อนไขเช่นนี้จำเป็น เพราะผลที่ดูดีมีประโยชน์ต่อการประเมิน แต่ยังไม่ใช่คำรับรองความปลอดภัยสำหรับทุกระบบ
เริ่มจากผู้เชี่ยวชาญ ก่อนเปิดให้ผู้ใช้ทั่วไป
Google จะเริ่มให้ผู้เชี่ยวชาญด้านการป้องกันไซเบอร์บางส่วนเข้าถึง Carbon ผ่านโครงการ Fairwind ก่อน แล้วจึงทยอยขยายไปยังพันธมิตรที่ได้รับความไว้วางใจ พร้อมเก็บข้อเสนอแนะและปรับกลไกป้องกันการใช้ผิดวัตถุประสงค์[[ บริษัทกำลังเข้าร่วมกระบวนการทดสอบโมเดลก่อนเปิดตัวโดยสมัครใจของรัฐบาลสหรัฐฯ และยังไม่ได้ประกาศวันเปิดให้ใช้งานครบวงกว้าง[ ดังนั้นนักพัฒนา องค์กร และผู้บริโภคทั่วไปยังต้องรอการเข้าถึงผ่านผลิตภัณฑ์ปกติของ Google[ การทยอยเปิดใช้เป็นแนวทางที่สมเหตุสมผล เมื่อโมเดลมีความสามารถทั้งค้นหาและตรวจสอบช่องโหว่ เพราะเครื่องมือเดียวกันอาจช่วยฝ่ายป้องกันหรือถูกนำไปใช้ในทางโจมตีได้ บทสรุปคือ Gemini 4 Carbon แสดงศักยภาพเด่นทั้งงานโค้ดระยะยาวและความปลอดภัยไซเบอร์ แต่คะแนนทดสอบยังต้องอ่านควบคู่กับข้อจำกัด และความพร้อมใช้งานสำหรับคนทั่วไปยังไม่มีกรอบเวลาชัดเจน