
จากสร้างโทเคนสู่ลงมือทำ CPU จึงสำคัญกว่าเดิม
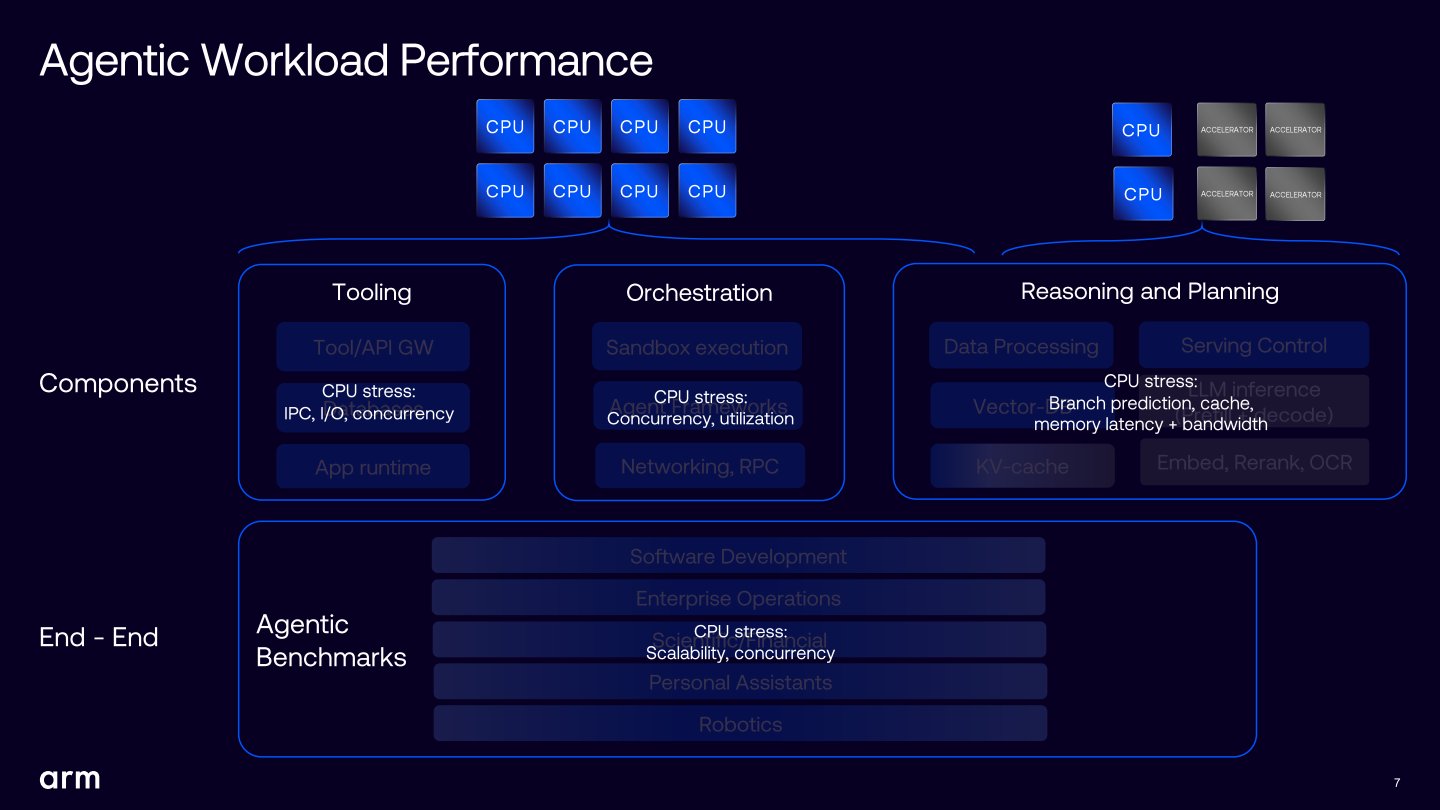
AI Agent คือระบบที่ใช้โมเดลภาษาขนาดใหญ่ทำความเข้าใจงาน วางแผน และเรียกใช้เครื่องมือซ้ำเป็นลำดับ เพื่อทำภารกิจให้เสร็จ แทนการสร้างคำตอบเพียงครั้งเดียว ความเปลี่ยนแปลงนี้ทำให้การทดสอบประสิทธิภาพ CPU แบบเดิมตอบโจทย์ไม่ครบอีกต่อไป เวิร์กโหลด AI มีทั้งช่วงสร้างโทเคนและวางแผน ซึ่งพึ่งพา GPU หรือเครื่องเร่งการคำนวณ กับช่วงนำผลไปปฏิบัติ เช่น เรียกซอฟต์แวร์ อ่านไฟล์ หรือจัดลำดับเครื่องมือ ซึ่งทำงานบนเซิร์ฟเวอร์ CPU ได้ การประเมินที่มองเฉพาะความเร็วอนุมานจึงเสี่ยงละเลยส่วนที่ทำให้ Agent เดินหน้าต่อได้ ในการประชุม OCP Global Summit 2026 ราวี มัลโฮตรา ผู้อำนวยการฝ่ายสถาปัตยกรรมโซลูชัน AI บนคลาวด์ของ Arm เสนอให้พิจารณาความต้องการของ AI Agent หลายรูปแบบ ตั้งแต่งานเขียนโปรแกรมและระบบอัตโนมัติองค์กร ไปจนถึงผู้ช่วยส่วนตัว งานวิจัย และหุ่นยนต์ ประเด็นสำคัญไม่ใช่ CPU แทน GPU แต่คือ CPU ต้องถูกวัดในบทบาทใหม่

วัดวงจรการทำงาน ไม่ใช่คะแนนชิ้นส่วนอย่างเดียว
วงจรของ Agent เริ่มจากรับคำสั่ง เรียกเครื่องมือ รับผลกลับมาประเมิน แล้วอาจเรียกเครื่องมือเดิมหรือเครื่องมืออื่นซ้ำ สำหรับงานพัฒนาโปรแกรม วงจรนี้อาจเกี่ยวข้องกับการอ่านและแก้ไฟล์ ค้นหาโค้ด และรันทดสอบ จุดที่ใช้ CPU จึงไม่ได้มีรูปแบบเดียวกันทุกงาน การทดสอบระดับชิ้นส่วนยังมีประโยชน์ เช่น วัดเว็บเซิร์ฟเวอร์ ฐานข้อมูล การเรียกเครื่องมือ การรับส่งข้อมูลเข้าออก และการทำงานขนาน แต่ผลเหล่านี้บอกได้เพียงสมรรถนะขององค์ประกอบ ไม่ได้แสดงว่าระบบทั้งหมดทำงานร่วมกันได้ดีเพียงใด งานจัดการและประสานหลาย Agent ให้ความสำคัญกับการใช้ CPU และการทำงานขนาน ขณะที่ CPU ซึ่งช่วยงานอนุมานอาจขึ้นกับประสิทธิภาพต่อเธรด แคช การคาดการณ์สาขา และความหน่วงหน่วยความจำ ดังนั้น Benchmark AI ที่มีความหมายควรมีการทดสอบตั้งแต่ต้นจนจบ และดูความสามารถในการรองรับหลายเซสชันโดยยังตอบสนองได้ ไม่ใช่เลือกคะแนนที่โดดเด่นจากส่วนใดส่วนหนึ่งเป็นตัวแทนทั้งหมด
เริ่มทดสอบอย่างไรให้ทำซ้ำและเปรียบเทียบได้
แนวทางตั้งต้นคือกำหนดงาน Agent ที่ทำซ้ำได้ แล้วแยกผลของ CPU และหน่วยความจำออกจากเครื่องเร่งการคำนวณ ทีมทดสอบภายในของผู้จัดทำบทความด้านฮาร์ดแวร์รายหนึ่งสร้าง Agent ด้วย LangGraph ให้ทำงาน 30 ขั้นตามลำดับกับเซิร์ฟเวอร์ llama.cpp ที่รันโมเดล gemma4-26b-a4b วิธีนี้ช่วยตรวจวงจรการเรียกเครื่องมือโดยไม่ปะปนกับการทดสอบ AI ในเครื่องรูปแบบอื่น การทดสอบเริ่มจากโปรเซสทำงานหนึ่งชุด แล้วเพิ่มระดับไปจนถึงจำนวนเธรดสูงสุดของ CPU โดยทำซ้ำสามรอบในแต่ละระดับ ตัวชี้วัดคือจำนวนเซสชันต่อวินาที แนวทางเช่นนี้ช่วยให้เห็นว่าประสิทธิภาพเพิ่มตามจำนวนงานพร้อมกันหรือเริ่มติดขัดตรงไหน เพื่อป้องกันผลคลาดเคลื่อนจากการตอบกลับของเครื่องมือที่เปลี่ยนไป การทดสอบเปรียบเทียบคำเรียกเครื่องมือจริงกับผลที่บันทึกไว้ แต่ส่งผลบันทึกกลับเข้าไปในวงจรเสมอ วิธีดังกล่าวเพิ่มความสม่ำเสมอ แต่ก็หมายความว่าผลทดสอบยังไม่ใช่ภาพแทนทุกสถานการณ์จริง จึงควรอ่านควบคู่กับรายละเอียดวิธีทดสอบ
อย่าหลงคะแนนสูงสุด หากระบบรักษาคุณภาพไม่ได้
เมื่อเปรียบเทียบ CPU ควรมองมากกว่าจำนวนเซสชันต่อวินาที ต้องพิจารณาความหน่วงและข้อตกลงระดับการให้บริการ หรือ SLA ควบคู่กันด้วย เป้าหมายที่เหมาะสมคือรองรับงานได้มากโดยยังโต้ตอบได้ต่อเนื่อง ไม่ใช่เร่งปริมาณงานจนคุณภาพการตอบสนองตก จำนวน Agent ที่เพิ่มขึ้นยังทำให้เกิดการแข่งขันแย่งทรัพยากร โดยเฉพาะเมื่อระบบสร้าง Agent ย่อยหรือเปิดหลายเซสชันในสภาพแวดล้อมแยกกัน ผลทดสอบจึงควรเปิดเผยรูปแบบงาน จำนวนผู้ทำงานพร้อมกัน การตั้งค่าหน่วยความจำ และส่วนของระบบที่รวมอยู่ในการวัด เพื่อให้การเปรียบเทียบเป็นธรรม แนวทางทดสอบวงจร Agent ที่แยก CPU และหน่วยความจำจากตัวเร่งการคำนวณยังอยู่ระหว่างพัฒนา และผู้จัดทำระบุว่าตั้งใจให้เป็นส่วนเสริม ไม่ใช่สิ่งทดแทนการทดสอบ AI ในเครื่องแบบเดิม เมื่อรูปแบบงานและคุณสมบัติฮาร์ดแวร์ชัดขึ้น เกณฑ์จึงค่อยปรับตาม ข้อสรุปคือการทดสอบประสิทธิภาพ CPU ยุค Agent ต้องวัดทั้งส่วนประกอบและระบบตั้งแต่ต้นจนจบ พร้อมระบุข้อจำกัดอย่างตรงไปตรงมา