
โมเดล AI ท้องถิ่นคืออะไร และทำไมอุปกรณ์เก่าถึงยังมีค่า
โมเดล AI ท้องถิ่นคือการติดตั้งและรันโมเดลปัญญาประดิษฐ์บนอุปกรณ์ของเราเอง เช่น คอมพิวเตอร์เก่า Raspberry Pi หรือเครื่องเกม โดยไม่ต้องส่งข้อมูลขึ้นคลาวด์ ทำให้ควบคุมความเป็นส่วนตัวได้ดีขึ้น ลดความหน่วงจากอินเทอร์เน็ต และไม่ต้องจ่ายค่าสมัครรายเดือนให้บริการออนไลน์ เหมาะกับคนที่มีอุปกรณ์ว่างอยู่ที่บ้านและอยากเปลี่ยนให้กลายเป็นเซิร์ฟเวอร์ AI ขนาดเล็กสำหรับงานประจำวัน ตั้งแต่วิเคราะห์ข้อความ จัดการรูปภาพ ไปจนถึงสั่งงานอุปกรณ์ระยะไกล ถ้าคุณมีคอมพิวเตอร์เก่าที่มี RAM อย่างน้อย 8GB หรือโน้ตบุ๊กที่ไม่ได้ใช้แล้ว คุณมีพื้นฐานที่ดีสำหรับการรัน AI บนคอมพิวเตอร์เก่าอยู่แล้ว จุดสำคัญคือเลือกงานให้เหมาะกับทรัพยากร ไม่พยายามรันโมเดลขนาดใหญ่เกินไป เพราะแม้เครื่องเก่าจะทำงานได้ แต่ต้องรู้ขีดจำกัดเพื่อไม่ให้เครื่องค้างหรือร้อนเกินไป การใช้โมเดล AI ท้องถิ่นยังช่วยให้เราควบคุมว่าข้อมูลอะไรถูกส่งออกไปบ้าง การเลือกใช้ AI แบบโลคัลทำให้สามารถออกแบบระบบให้ตรงกับงานของตัวเอง และหลีกเลี่ยงการใช้โควต้ารายสัปดาห์ของบริการออนไลน์ที่มีข้อจำกัดด้านปริมาณการใช้งาน
เตรียม Raspberry Pi 5 ให้พร้อมสำหรับ Raspberry Pi AI ขนาด 29MB
Raspberry Pi 5 เป็นบอร์ดเล็กที่เหมาะมากสำหรับการทดลอง Raspberry Pi AI โดยเฉพาะเมื่อมี RAM 8GB และใช้ระบบปฏิบัติการที่เบาอย่าง DietPi ซึ่งช่วยลดการใช้ทรัพยากรของระบบลง โมเดลอย่าง Cactus Compute Needle 3 ถูกออกแบบมาให้ใช้หน่วยความจำสูงสุดประมาณ 29MB เท่านั้น แต่ยังทำงานด้านการแปลงข้อมูลเป็น JSON สร้างเวกเตอร์จากข้อความ และเรียกใช้เครื่องมืออัตโนมัติได้ ทำให้บอร์ดเล็กกลายเป็นตัวช่วยงานอัตโนมัติในบ้านได้ดี ข้อดีคือไม่ต้องมีฮาร์ดแวร์เร่ง AI เพิ่มเติม แต่ข้อควรระวังคือสถาปัตยกรรมซีพียูของบอร์ด ต้องใช้รุ่นที่รองรับ ARMv8 ขึ้นไป เพราะการพยายามรันบนบอร์ดรุ่นเก่าที่ใช้ ARMv6 อย่าง Raspberry Pi Zero รุ่นแรกจะเกิดข้อผิดพลาดระหว่างการคอมไพล์อยู่เรื่อยๆ ถ้ามี Pi 5 อยู่แล้วถือว่าพร้อมมาก และยังสามารถเลือกจำนวนเลเยอร์ของโมเดลได้ตั้งแต่ 2 ถึง 20 ชั้นให้เหมาะกับกำลังเครื่อง คำพูดหนึ่งที่น่าสนใจคือ “โมเดล Needle 3 ใช้หน่วยความจำสูงสุดเพียงประมาณ 29MB แต่ทำงาน edge AI ได้ที่อัตรา decode 280.2 tokens ต่อวินาทีและ prefill 996.4 tokens ต่อวินาที” ซึ่งแสดงให้เห็นว่าบอร์ดเล็กก็ทำงาน AI ได้ลื่นมาก
- อัปเดตระบบบน Raspberry Pi 5 และติดตั้งแพ็กเกจพื้นฐานด้วยคำสั่ง sudo apt install -y python3-venv python3-pip git เพื่อเตรียมสภาพแวดล้อม Python และเครื่องมือจัดการโค้ด
- สร้าง virtual environment สำหรับโมเดลด้วยคำสั่ง python3 -m venv ~/needle-env แล้วสลับเข้าไปใช้ด้วย source ~/needle-env/bin/activate เพื่อแยกไลบรารีของโมเดลออกจากระบบหลัก
- ติดตั้ง runtime ของโมเดลด้วย pip install cactus-needle จากนั้นตามด้วย pip install numpy sentencepiece jax flax cactus-needle requests python-dotenv เพื่อให้ทุกไลบรารีที่โมเดลต้องใช้พร้อมทำงาน
- คอมไพล์โมเดลสำหรับแพลตฟอร์ม linux-arm64 ด้วยคำสั่ง needle build --platform linux-arm64 --layers 20 --out ./pi โดยสามารถปรับค่า --layers ให้เหมาะกับกำลังเครื่อง ถ้า RAM น้อยลงอาจลดจำนวนเลเยอร์ลงได้
- สร้างไฟล์ .needle-ha.env เพื่อเชื่อมต่อกับ Home Assistant ด้วยคำสั่ง sudo tee /root/.needle-ha.env >/dev/null <<'EOF' แล้วใส่ค่า HA_URL HA_TOKEN และ NEEDLE_TELEMETRY ตามระบบของคุณ จากนั้นบันทึกไฟล์เพื่อให้โมเดลเข้าถึงอุปกรณ์ในบ้านอัตโนมัติ
หลังทำตามขั้นตอนครบ คุณสามารถเขียนสคริปต์ Python สั้นๆ เพื่อให้โมเดลถามคำสั่งและสั่งงานอุปกรณ์ เช่น สั่งเปิดปลั๊กไฟอัจฉริยะผ่าน entity smart_plug ได้ทันที เมื่อรันสคริปต์ โมเดลจะรับพรอมต์และประมวลผลคำสั่ง จากตัวอย่างการใช้งาน Needle 3 สามารถเข้าใจคำสั่งและทำให้อุปกรณ์กลับมาออนไลน์ได้ทันทีโดยไม่สะดุด ผลลัพธ์คือ Raspberry Pi 5 กลายเป็นศูนย์กลางอัตโนมัติที่ใช้โมเดล AI ท้องถิ่นช่วยจัดการงานในบ้าน โดยไม่ต้องพึ่งคลาวด์หรือบริการภายนอก
รัน LLM ขนาดเล็กบนคอมพิวเตอร์เก่าและโน้ตบุ๊ก
ถ้าคุณมีคอมพิวเตอร์ตั้งโต๊ะหรือโน้ตบุ๊กเก่าที่วางทิ้งไว้ การนำมารันโมเดล AI ท้องถิ่นเป็นวิธีใช้ทรัพยากรให้คุ้มมาก คอมพิวเตอร์ที่มี RAM ตั้งแต่ 8GB ขึ้นไปสามารถรัน LLM ขนาดเล็กระดับ 3–5 พันล้านพารามิเตอร์ได้ในระดับที่ใช้งานจริงได้ โดยเฉพาะถ้าโมเดลถูกปรับแต่งให้ทำงานบนซีพียูโดยตรง ถ้ามีการ์ดจอแยกในเครื่องเดสก์ท็อปเก่า คุณจะมีตัวเลือกมากขึ้น สามารถรันหลายโมเดลเล็กพร้อมกันเร็วกว่าความเร็วพูดจริง หรือรันโมเดลขนาดกลางแบบเรียลไทม์ได้ หัวใจของการตั้งค่าหลายคนคือโปรแกรมอย่าง Ollama ที่ช่วยให้โมเดล AI ทั้งหมดถูกเข้าถึงผ่านเครือข่ายภายในบ้าน ทำให้เครื่องเก่ากลายเป็นเซิร์ฟเวอร์ AI ขนาดเล็กที่อุปกรณ์อื่นในบ้านเรียกใช้งานได้ แนวคิดคือไม่พยายามให้เครื่องเก่าทำทุกอย่าง แต่เลือกงานเฉพาะ เช่น วิเคราะห์ข้อความ สร้างบอทแชตง่ายๆ หรือช่วยจัดการเอกสาร แล้วปล่อยให้รันต่อเนื่องได้โดยไม่หนักเกินไป เมื่อใช้โมเดล AI ท้องถิ่นบนเครื่องเก่า ข้อดีสำคัญคือเราควบคุมข้อมูลได้เอง ไม่ต้องกังวลว่าเอกสารสำคัญ เช่น เอกสารภาษีหรือใบสมัครงานจะถูกส่งออกไปบนอินเทอร์เน็ต เพราะทุกอย่างถูกเก็บและประมวลผลบนเซิร์ฟเวอร์ส่วนตัวในบ้านเท่านั้น
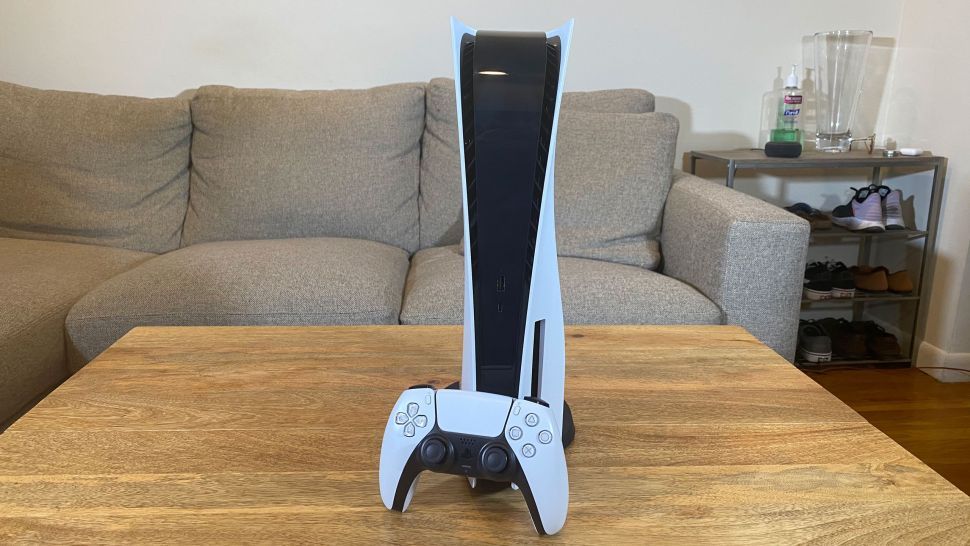
เปลี่ยน PlayStation 5 ให้เป็นเครื่องรัน LLM ขนาดเล็กความเร็วสูง
สำหรับคนที่มี PlayStation 5 และสนใจด้านโมเดล AI ท้องถิ่น เครื่องเกมนี้มีศักยภาพซ่อนอยู่มาก เมื่อมีการพอร์ตเครื่องมืออย่าง llama.cpp ให้รันแบบ native บน PS5 และเข้าถึงจีพียูผ่านไดรเวอร์อย่าง PS5_Vulkan ทำให้สามารถใช้หน่วยความจำและพลังจีพียูได้เต็มที่ในการรัน LLM ขนาดเล็กและขนาดกลาง จากการทดสอบ มีการรันโมเดลขนาด 27 พันล้านพารามิเตอร์ได้ที่ประมาณ 20 tokens ต่อวินาที และโมเดลเล็กอย่าง Gemma 4 E4B และ Llama 3.2 3B ได้ที่ประมาณ 61 และ 124 tokens ต่อวินาทีตามลำดับ ความเร็วระดับนี้ทำให้ PS5 สามารถตอบแชตหรือประมวลผลข้อความแบบใกล้เรียลไทม์ เหมาะกับการใช้เป็นเซิร์ฟเวอร์ LLM ขนาดเล็กในบ้าน เช่น บอทตอบคำถาม หรือผู้ช่วยเขียนข้อความโดยไม่ต้องต่ออินเทอร์เน็ต จุดที่ต้องระวังคือการรันโมเดลใหญ่เกินไปบนซีพียูอย่างเดียวเคยทำให้ระบบค้างและแครช เพราะติดคอขวดที่ซีพียูและจำกัด RAM การย้ายงานไปจีพียูจึงสำคัญมากสำหรับ PS5 ภาพรวมคือ ถ้าเครื่อง PS5 สามารถเข้าถึงจีพียูและ RAM ได้มากขึ้น การรัน LLM ขนาดเล็กก็จะลื่นและเร็วพอสำหรับการใช้งานประจำวัน แต่การดัดแปลงระบบเช่นการเจลเบรกมีความเสี่ยงต่อการรับประกันและความปลอดภัย คุณจึงควรศึกษาข้อมูลให้ละเอียดก่อนตัดสินใจ
ตัวอย่างการใช้งานจริงและข้อควรระวังเมื่อใช้โมเดล AI ท้องถิ่น
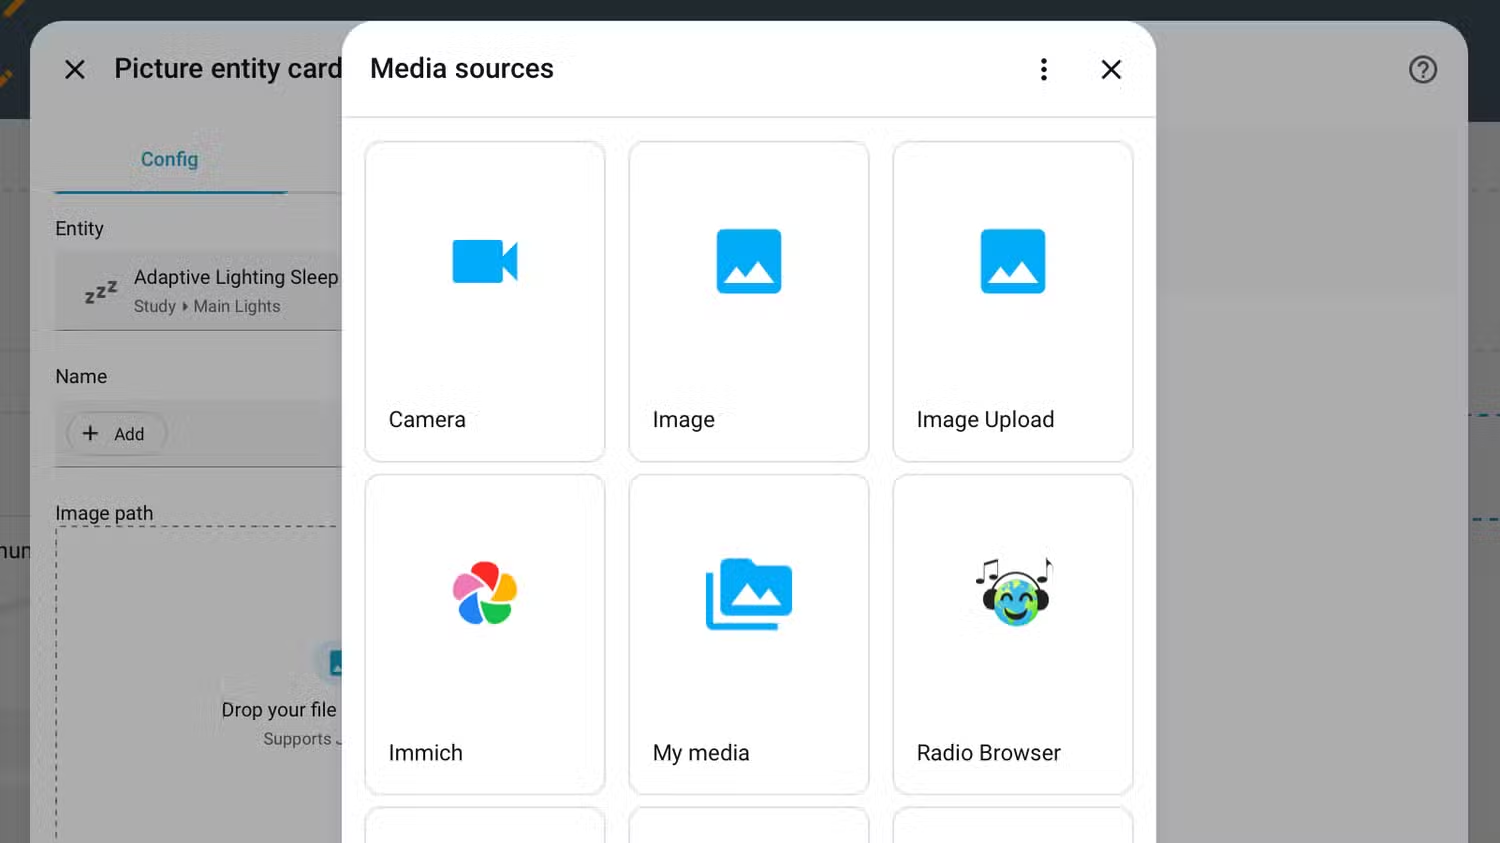
เมื่ออุปกรณ์เก่ากลายเป็นเซิร์ฟเวอร์โมเดล AI ท้องถิ่นแล้ว คุณสามารถต่อยอดไปสู่การใช้งานจริงได้หลายแบบ เช่น การวิเคราะห์ข้อความและเอกสารด้วยระบบจัดการเอกสารที่มีฟีเจอร์ AI ช่วยตั้งชื่อ แท็ก และใส่วันที่ให้เอกสารอัตโนมัติ ทำให้การจัดเก็บเอกสารจำนวนมากเป็นระเบียบขึ้นโดยไม่ต้องพึ่งคลาวด์ ด้านรูปภาพก็มีโครงการอย่าง Immich ที่ใช้ AI ช่วยแท็กใบหน้าและค้นหารูปตามคนหรือสถานที่ได้ ทำให้เครื่องเก่ากลายเป็นคลังรูปส่วนตัวที่ค้นหาได้สะดวก อีกด้านหนึ่งคือการสั่งงานอุปกรณ์ระยะไกล เช่น การเชื่อม Needle 3 เข้ากับ Home Assistant แล้วให้โมเดลรับคำสั่งเป็นข้อความและสั่งเปิดปิดปลั๊กไฟหรืออุปกรณ์อื่นในบ้านได้ทันที เมื่อสคริปต์ถูกเรียกใช้ โมเดลสามารถเข้าใจคำสั่งและทำให้อุปกรณ์กลับมาออนไลน์ได้โดยไม่มีปัญหา หรือจะใช้ Docker เปิดให้โมเดลเข้าถึงส่วนต่างๆ ของเวิร์กสเตชันที่โฮสต์เองเพื่อทำงานอัตโนมัติหลากหลายรูปแบบ ข้อควรระวังคือการเลือกโมเดลให้เหมาะกับฮาร์ดแวร์ ถ้าพยายามรันโมเดลใหญ่เกินไปบนบอร์ดหรือเครื่องที่สถาปัตยกรรมไม่รองรับ เช่น ARMv6 จะเกิดข้อผิดพลาดระหว่างการสร้างโมเดล และบนเครื่องอย่าง PS5 การรันโมเดลใหญ่บนซีพียูโดยไม่ใช้จีพียูเคยทำให้ระบบค้างและแครชเพราะคอขวดด้านซีพียู ดังนั้นการเริ่มจาก LLM ขนาดเล็กและค่อยๆ ขยายจึงปลอดภัยกว่า เมื่อมองภาพรวม การใช้โมเดล AI ท้องถิ่นช่วยลดการพึ่งพาคลาวด์ ลดความหน่วงจากเครือข่าย และตัดค่าใช้จ่ายแบบสมัครรายเดือนออกไป ขณะเดียวกันก็เพิ่มความมั่นใจเรื่องความเป็นส่วนตัว เพราะข้อมูลสำคัญถูกประมวลผลและเก็บไว้บนเซิร์ฟเวอร์ของเราเองเท่านั้น ถ้าคุณยอมลงทุนเวลาเรียนรู้การตั้งค่าเล็กน้อย อุปกรณ์เก่าที่เคยวางทิ้งไว้จะกลายเป็นเครื่องมือ AI ที่มีประโยชน์ในชีวิตประจำวันอย่างคุ้มค่า