
นิยามปัญหา: AI ตัดสินใจเองโดยไร้ human oversight
AI reliability และการประเมิน คือการใช้แบบทดสอบ เครื่องมือ และตัวชี้วัดเพื่อวัดความสามารถของระบบ AI ในการตัดสินใจอย่างถูกต้องสอดคล้องกับผลลัพธ์จริง และเมื่อองค์กรใช้ผลการประเมินเหล่านี้แทนการตรวจสอบของมนุษย์จนกลายเป็นการปล่อยให้ AI ตัดสินใจในงานที่มีความเสี่ยงสูงเองทั้งหมด เราจึงต้องถามตรง ๆ ว่าองค์กรกำลังเชื่อคะแนนสอบมากกว่าชีวิตของลูกค้าหรือไม่ เพราะการลด human oversight ในระบบ AI ไม่ใช่แค่ทางลัดด้านต้นทุน แต่เป็นทางลัดที่อาจพาองค์กรเดินเข้าหา agentic AI failures ที่สร้างผลกระทบทั้งเชิงชื่อเสียงและความน่าเชื่อถือแบบถอนตัวยากมากกว่าจะเป็นความสำเร็จด้านนวัตกรรม
ข้อมูล VentureBeat Pulse: ความมั่นใจพุ่ง แต่ความถูกต้องไม่ขยับ
ภาพรวมจาก VentureBeat Pulse ทำให้คำว่าความไว้วางใจต่อระบบประเมินอัตโนมัติฟังดูน่ากังวลมากกว่าจะน่าดีใจ เพราะในกลุ่มองค์กร 108 แห่ง ความเชื่อมั่นในเครื่องมือประเมินอัตโนมัติพุ่งขึ้นอย่างเห็นได้ชัด ขณะที่อัตรา agentic AI failures ที่เครื่องมือเหล่านี้ควรช่วยป้องกันกลับนิ่งสนิท ไม่ได้ดีขึ้นเลย สิ่งที่น่าจับตาคือ ความมั่นใจที่สูงขึ้นไม่ใช่มาจากการประเมินที่แม่นขึ้น แต่เกิดจากองค์กรที่ยังไม่เคยถูกเผาด้วยผลประเมินผิด ๆ ทำให้เกิดความรู้สึกว่าระบบน่าเชื่อถือ ทั้งที่ครึ่งหนึ่งของภาพรวมยังมีเคสที่ "agent ผ่านการประเมินแต่ไปล้มเหลวกับลูกค้าจริง" นี่คือการเติบโตของความมั่นใจโดยไม่มีหลักฐานรองรับ และมันคือเชื้อไฟให้การตัดมนุษย์ออกจากวงจรเร็วเกินไป
| Spec | A | B |
|---|---|---|
| ระดับความเชื่อมั่นในประเมินอัตโนมัติ | สูงในองค์กรที่ไม่เคยล้มเหลว | ต่ำในองค์กรที่เคยถูกเผา |
| อัตรา agentic AI failures หลังผ่านการประเมิน | ยังคงเกิดเกือบครึ่งหนึ่งขององค์กร | ไม่ได้ลดลงจากช่วงก่อนหน้า |
องค์กรที่ถูก AI ทำเจ็บ ทำไมยิ่งเร่งตัดคนออกจากระบบ
สิ่งย้อนแย้งที่สุดในข้อมูลคือองค์กรที่เคยประสบ agentic AI failures กลับเร่งเดินหน้าสู่ความเป็นอัตโนมัติเต็มรูปแบบมากกว่าองค์กรที่ยังไม่เคยพลาด เมื่อระบบประเมินทำให้ผู้บริหารเกิด false confidence ว่า AI ผ่านด่านแล้ว "ปลอดภัย" ความเจ็บจากเหตุการณ์ก่อนหน้ามักถูกตีความว่าเป็นอุบัติเหตุที่ต้องแก้ด้วยการลงเงินและเทคโนโลยีเพิ่ม ไม่ใช่ด้วยการเสริม human oversight ในระบบ AI ผลลัพธ์คือการเร่งให้ agent ตัดสินใจแบบ zero-human deployment ทั้งที่องค์กรกลุ่มนี้มีหลักฐานตรงหน้าว่าการประเมินไม่สามารถจับความเสี่ยงทั้งหมดได้ การตัดมนุษย์ออกจึงไม่ใช่การกำจัดข้อผิดพลาด แต่คือการปิดเซ็นเซอร์ตัวสุดท้ายที่ยังเตือนให้ชะลอความเสียหายก่อนถึงลูกค้าจริง
บทเรียนจาก A/B test: LLM แทนมนุษย์ได้ แต่ต้องมีรั้วและการปรับเทียบ
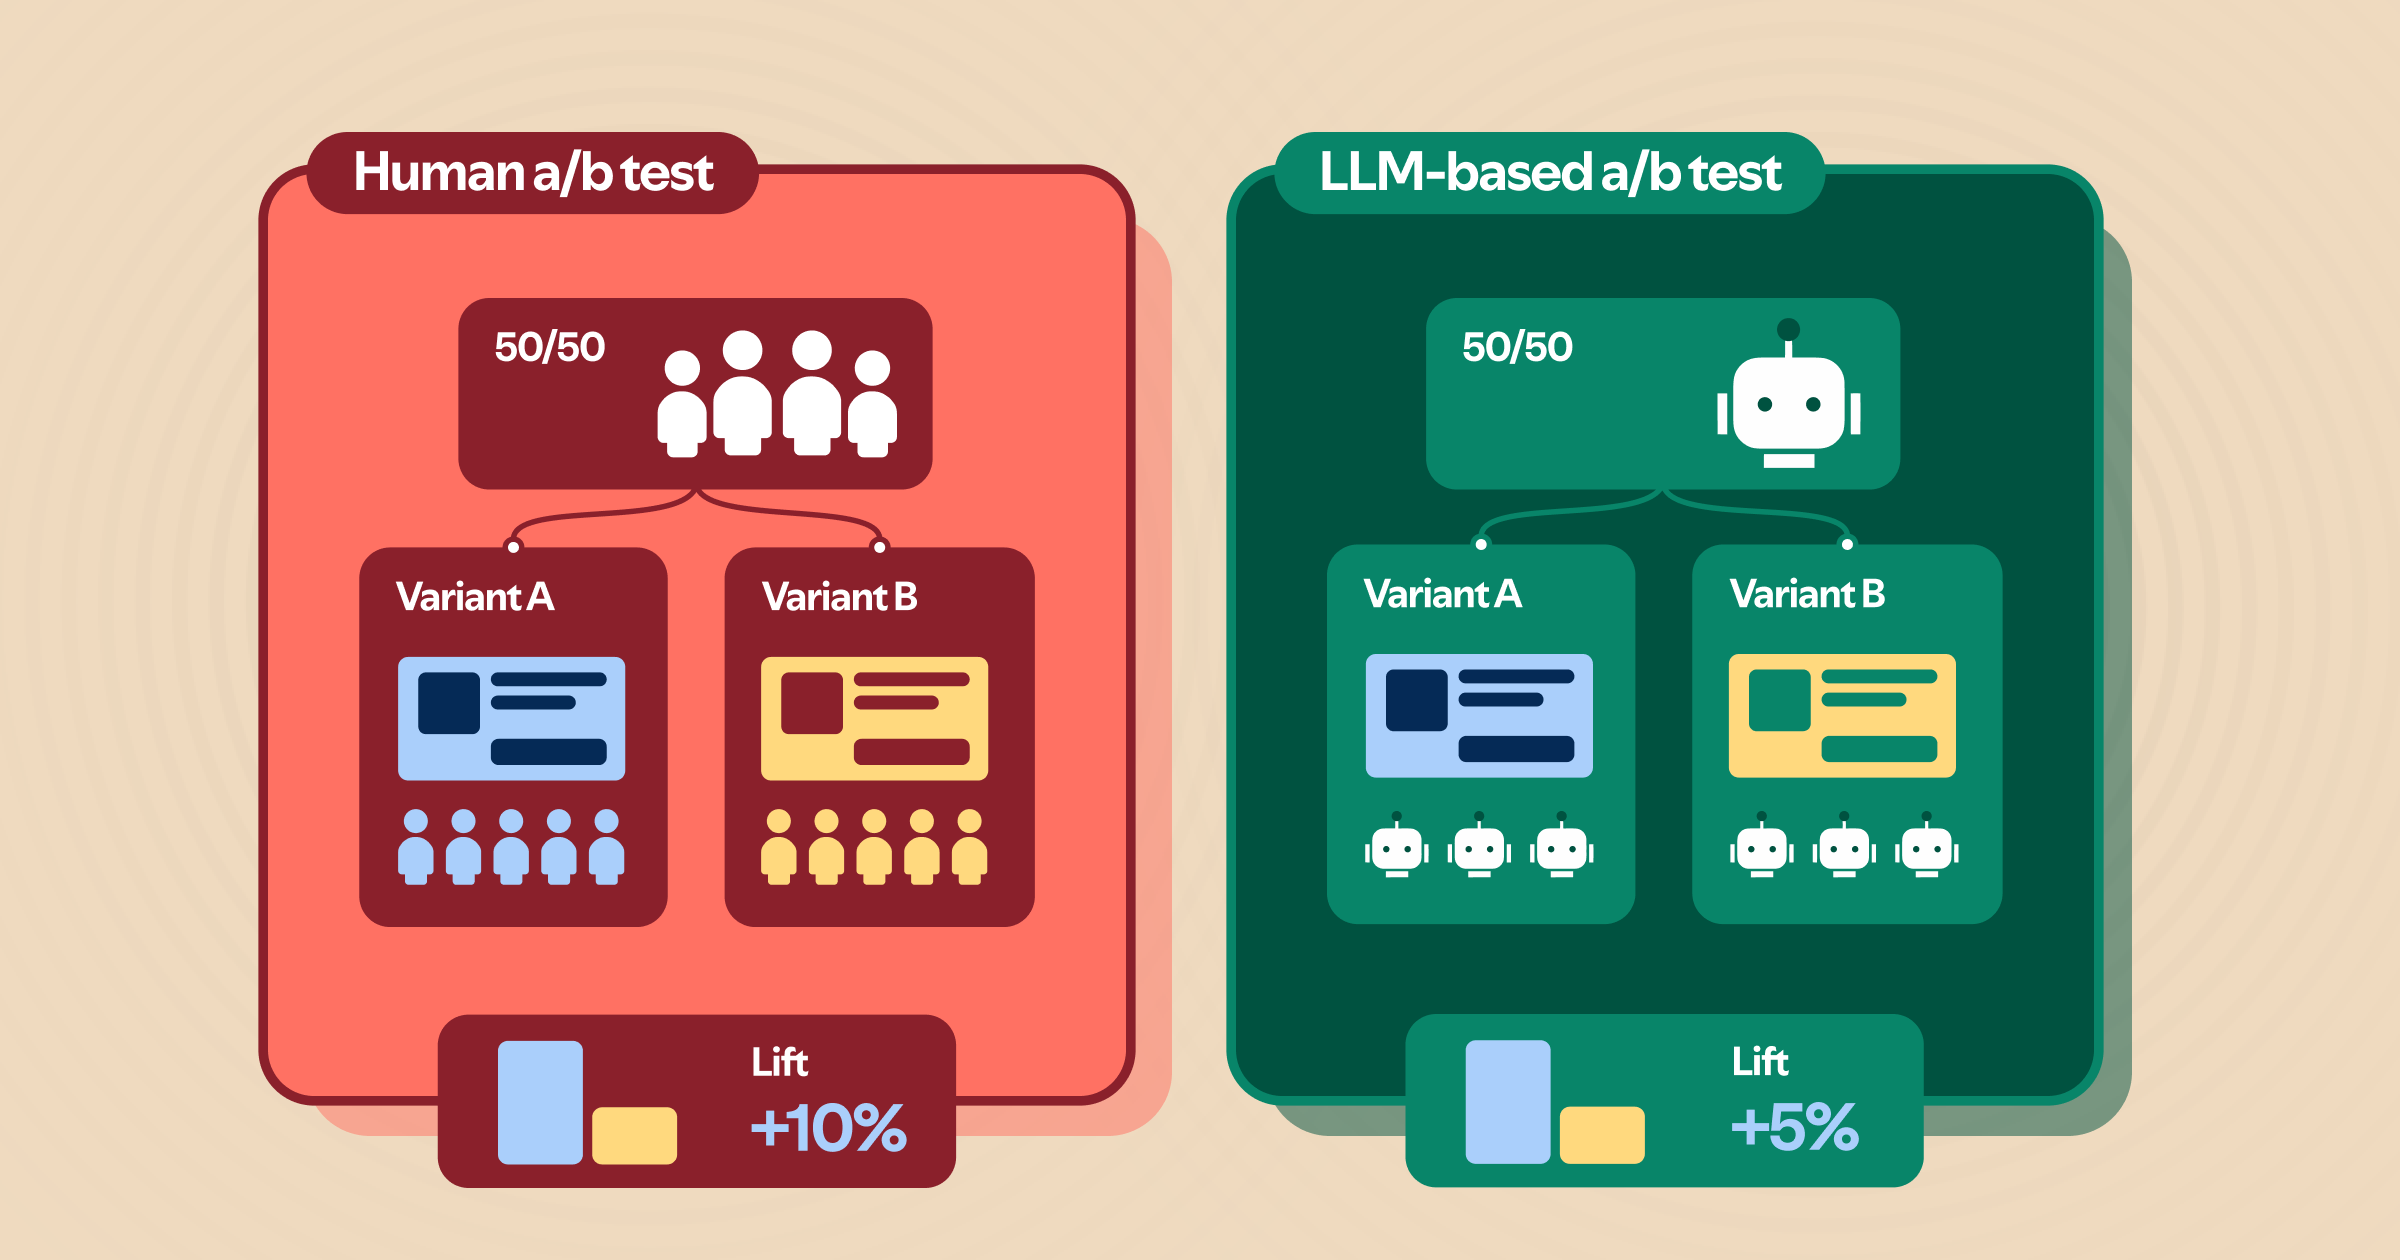
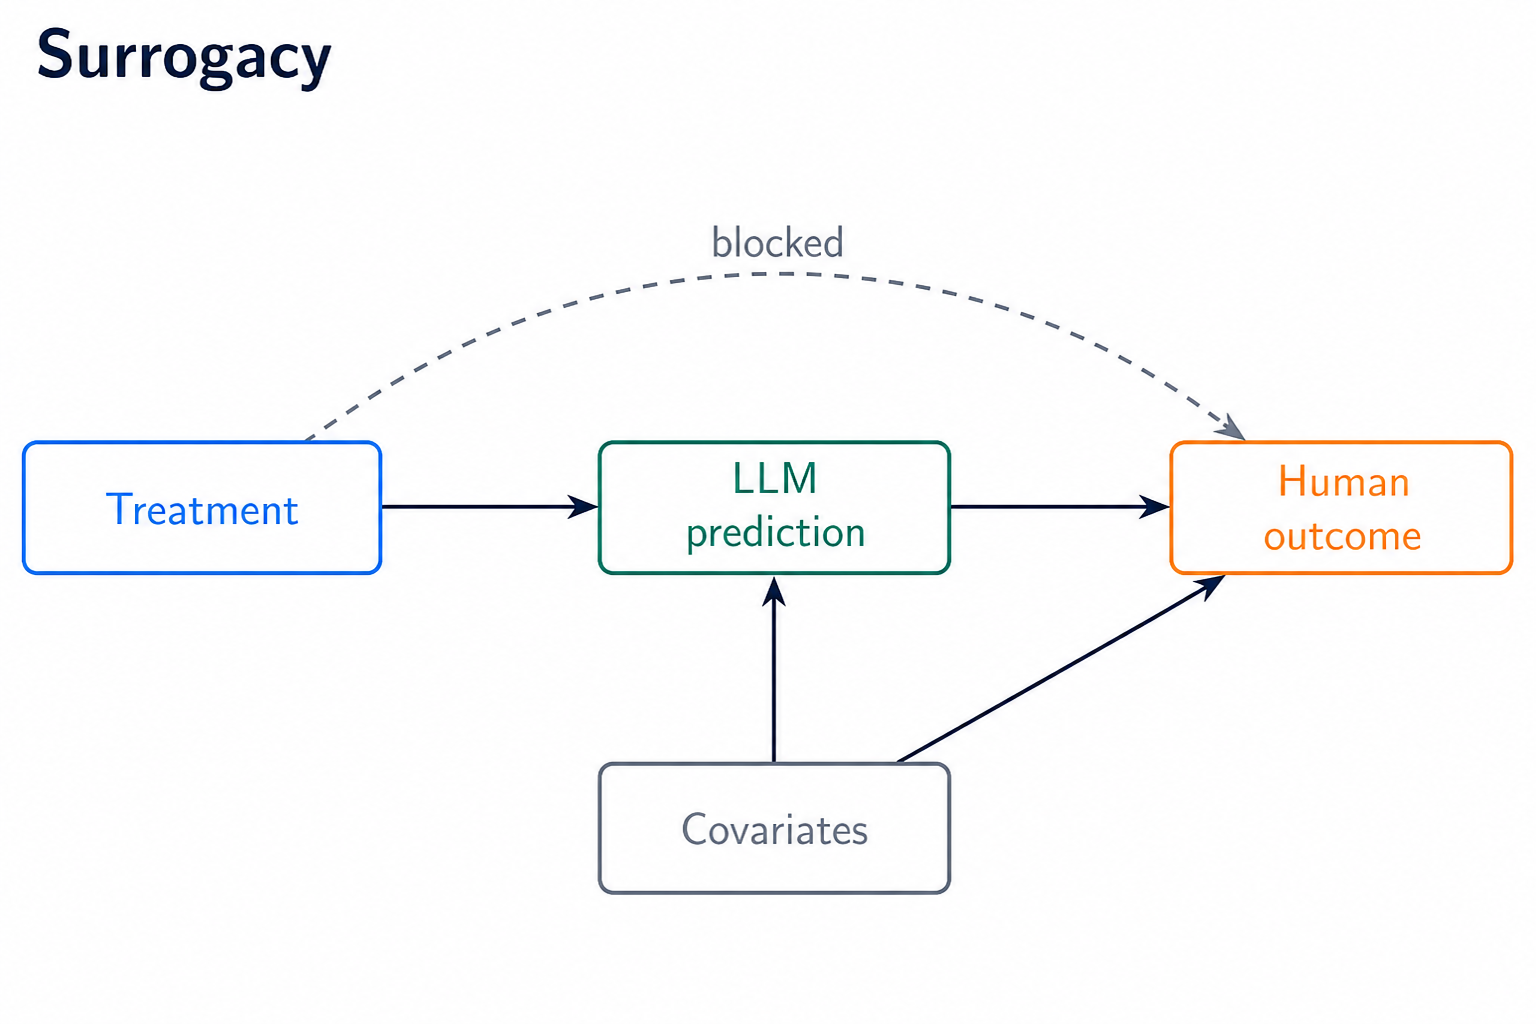
งานจากทีมวิศวกรรม Spotify แสดงให้เห็นด้านมืดของการใช้ LLM แทนมนุษย์แบบไม่ใส่รั้วความปลอดภัย พวกเขาลองใช้ gpt-4o-mini ทำนายผล A/B test บนชุดข้อมูล Upworthy แล้วพบว่าถ้าใช้ค่าพยากรณ์ดิบมาคำนวณ ผลลัพธ์จะสะท้อนผลการทดลองกับมนุษย์จริงได้เพียง 39% เท่านั้น นี่คือหลักฐานตรงว่าในงานที่ดูพื้นผิวแล้วเหมือน low-stakes อย่างการปรับหัวข้อคอนเทนต์ ระบบก็ยังให้ผลลำเอียงเกินกว่าจะปล่อยให้ตัดสินใจแทนมนุษย์โดยไม่มี human-in-the-loop workflow สิ่งที่งานนี้เสนอคือกรอบคิดแบบ surrogate outcome ที่ต้องอาศัยสมมติฐานเรื่อง surrogacy และ comparability ซึ่งยิ่งห่างจากชุดการทดลองเดิมมากเท่าไร สมมติฐานยิ่งไม่น่าเชื่อถือ และนี่คือเส้นแบ่งชัด ๆ ว่าการใช้ LLM แทนมนุษย์ต้องผ่านการ calibrate อย่างจริงจัง ไม่ใช่แค่การ "เชื่อโมเดล"
| Spec | A | B |
|---|---|---|
| การใช้ LLM ใน A/B test | ต้องอาศัย surrogacy และ comparability | ไม่ใช่การทดลองที่ได้เหตุผลตามการออกแบบ |
| ผลพยากรณ์ดิบของ LLM | สะท้อนผลมนุษย์ได้เพียงบางส่วน | ต้องปรับเทียบด้วยวิธีเฉพาะจึงจะเข้าใกล้ความจริง |
ข้อสรุปเชิงนโยบาย: ทำไม hybrid human-AI จึงควรเป็นค่าเริ่มต้น
เมื่ออ่านรวมกันทั้งข้อมูล VentureBeat Pulse และบทเรียนจากการแทนมนุษย์ใน A/B test สัญญาณที่ดังที่สุดคือองค์กรต้องหยุดฝันถึง AI ที่ตัดสินใจแทนมนุษย์ทุกกรณีโดยไม่ต้องมี human oversight ในระบบ AI แนวคิด enterprise AI governance ที่ดีไม่ใช่การเดินให้ไกลที่สุดสู่ zero-human deployment แต่คือการนิยามให้ชัดว่าขอบเขตไหน LLM สามารถช่วยลดภาระ เช่น การคัดกรองคอนเทนต์หรือการทดลองแบบมีการปรับเทียบ และขอบเขตไหนที่ human-in-the-loop workflow ต้องเป็นข้อบังคับ โดยเฉพาะใน healthcare การเงิน และการดำเนินงานที่แตะทั้งชีวิตและความไว้วางใจของสังคม องค์กรที่ถูก AI ทำเจ็บแล้วกลับยิ่งทุ่มเต็มตัวให้ระบบอัตโนมัติ กำลังอ่านบทเรียนผิดหน้า สิ่งที่ควรลงทุนไม่ใช่แค่เทคโนโลยี แต่คือการออกแบบวงจรตรวจสอบให้มนุษย์เป็นผู้มีสิทธิ์ “เบรก” AI ในทุกการตัดสินใจสำคัญ