
คำตัดสิน: จ่ายน้อยลง หรือเอาคะแนนให้สูงกว่า
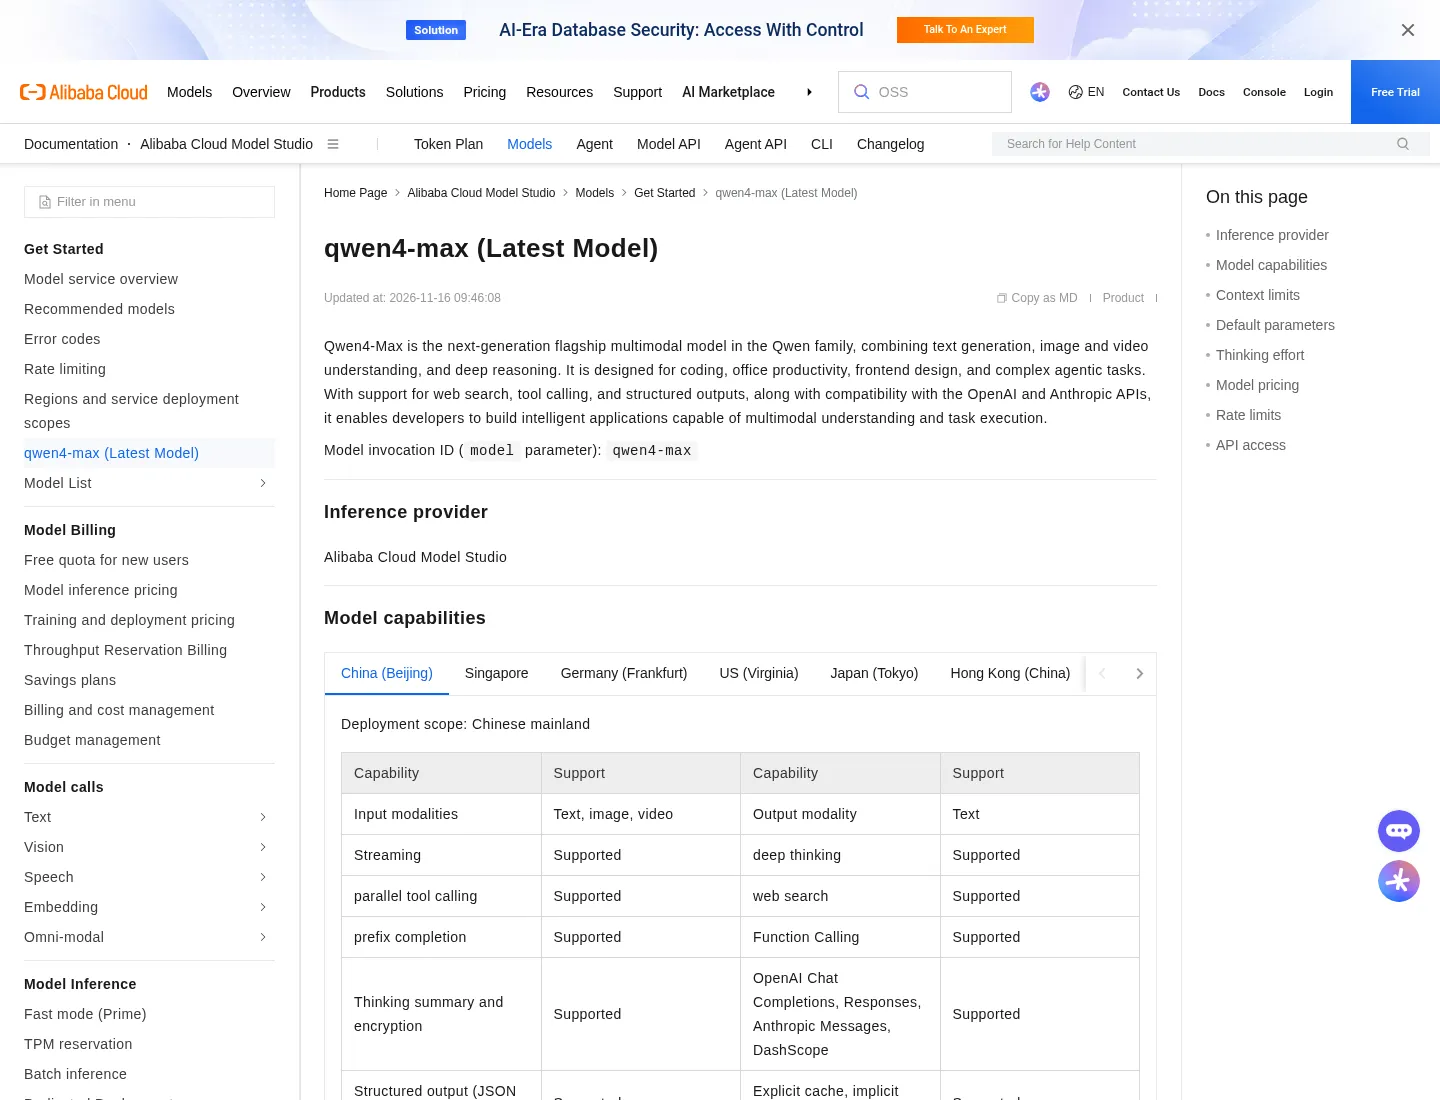
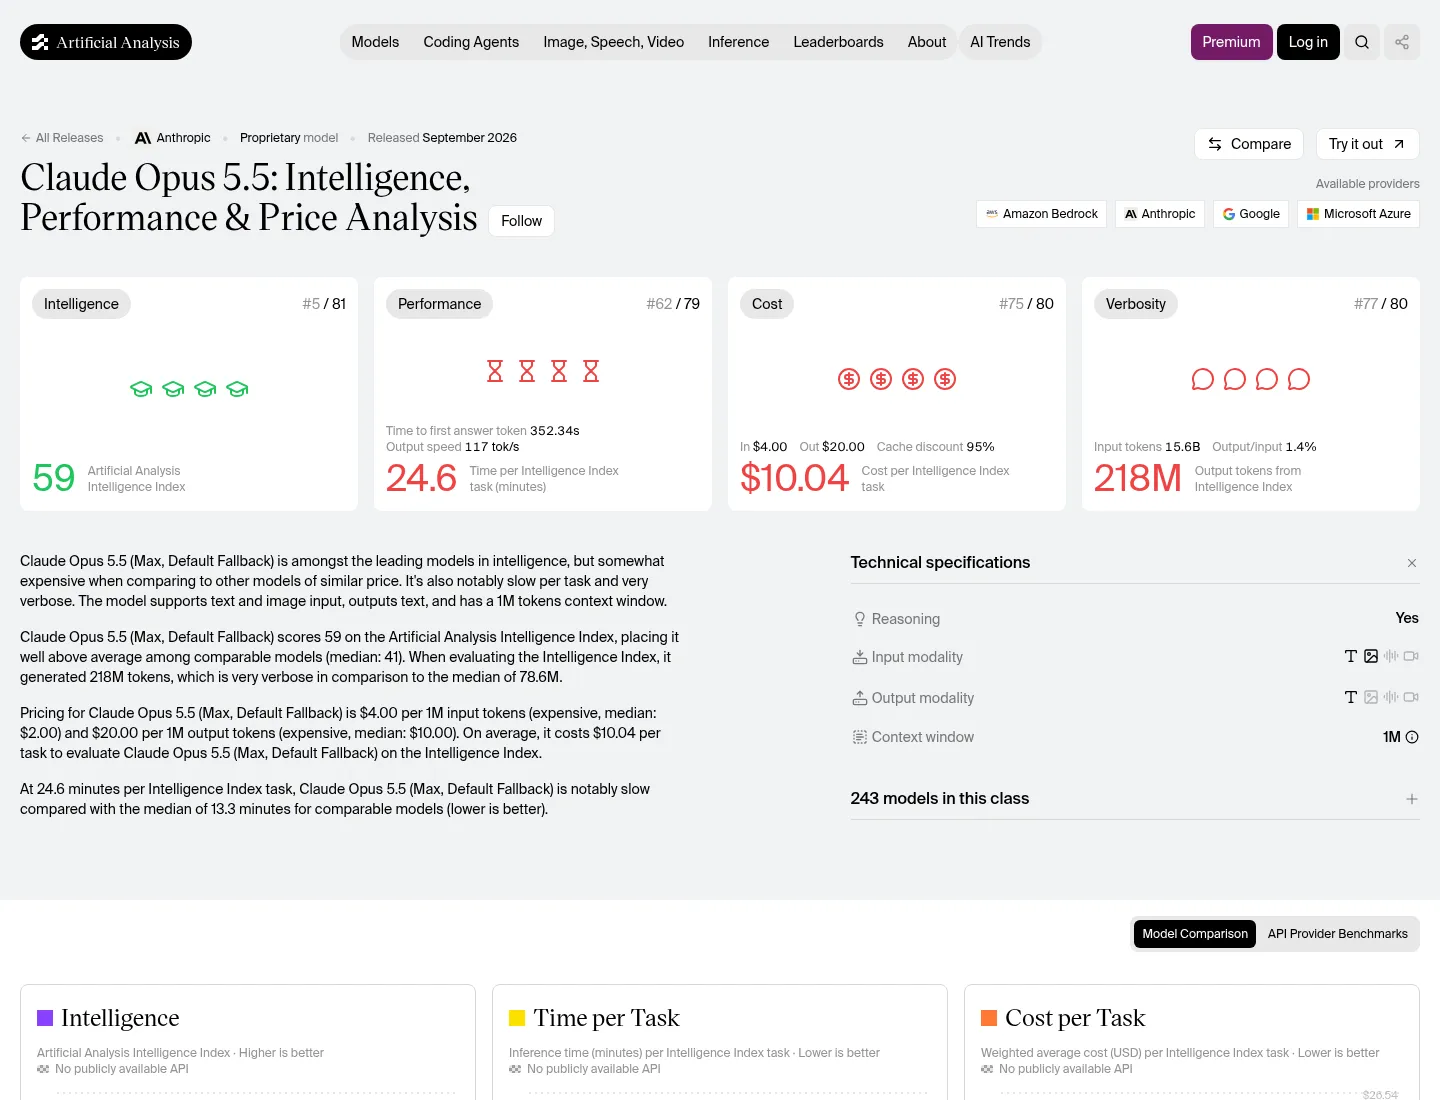
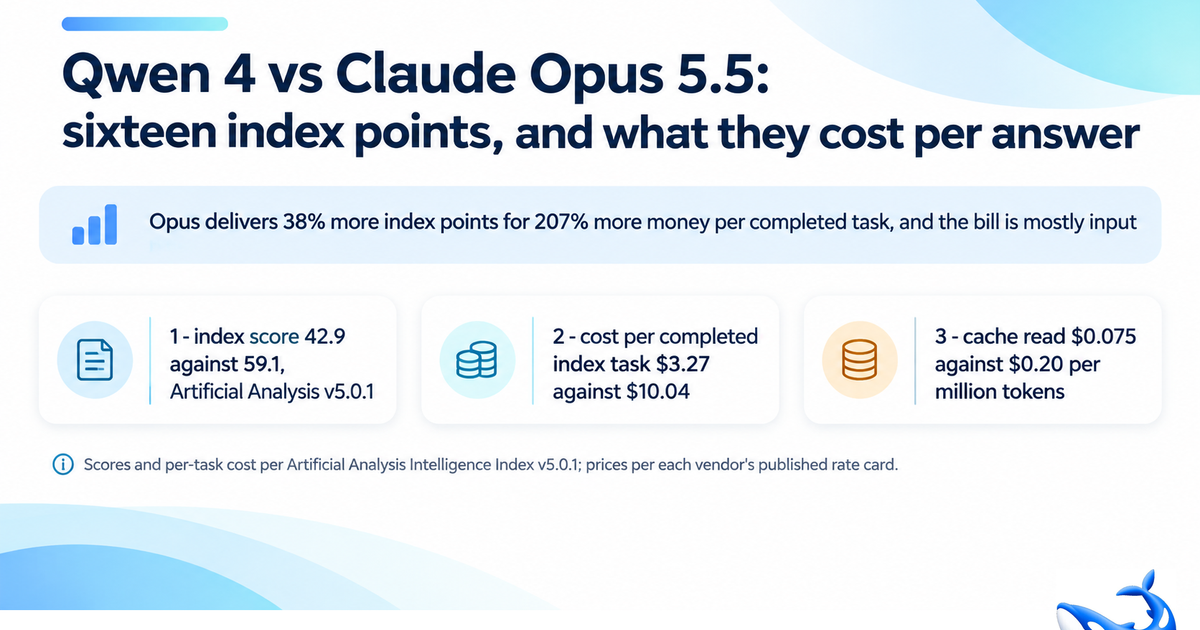
ต้นทุน AI ต่อคำตอบคือค่าใช้จ่ายที่เกิดจากจำนวนโทเค็นอินพุตและเอาต์พุตที่โมเดลใช้ทำงาน ไม่ใช่แค่ราคาเรียกเก็บต่อโทเค็น จึงต้องดูทั้งต้นทุนจริงต่อภารกิจและคุณภาพผลลัพธ์ก่อนเลือกโมเดล สำหรับงานที่ต้องทำซ้ำจำนวนมากและยอมรับคะแนนระดับกลางได้ Qwen4-Max น่าสนใจกว่า แต่ถ้างานต้องการความสามารถสูง โดยเฉพาะการเขียนโค้ดทั้งรีพอซิทอรีและการสั่งงานเชลล์ Claude Opus 5.5 คุ้มกับค่าใช้จ่ายที่สูงขึ้น Qwen4-Max benchmark ได้ 42.9 คะแนน ส่วน Claude Opus 5.5 ทำได้ 59.1 ต่างกัน 16.2 คะแนนในการทดสอบชุดเดียวกันและเวอร์ชันเดียวกัน ทั้งคู่ไม่รองรับวิดีโอตามข้อมูลความสามารถที่มี
| เกณฑ์ | Qwen4-Max | Claude Opus 5.5 |
|---|---|---|
| คะแนน Intelligence Index | 42.9 | 59.1 |
| ต้นทุนต่องานบนดัชนี | ประหยัดกว่าอย่างชัดเจน | สูงกว่า Qwen4-Max |
| Terminal-Bench 4.0 | 48.5% | 59.6% |
| FrontierCode 2.0 | 26.5% | 46.4% |
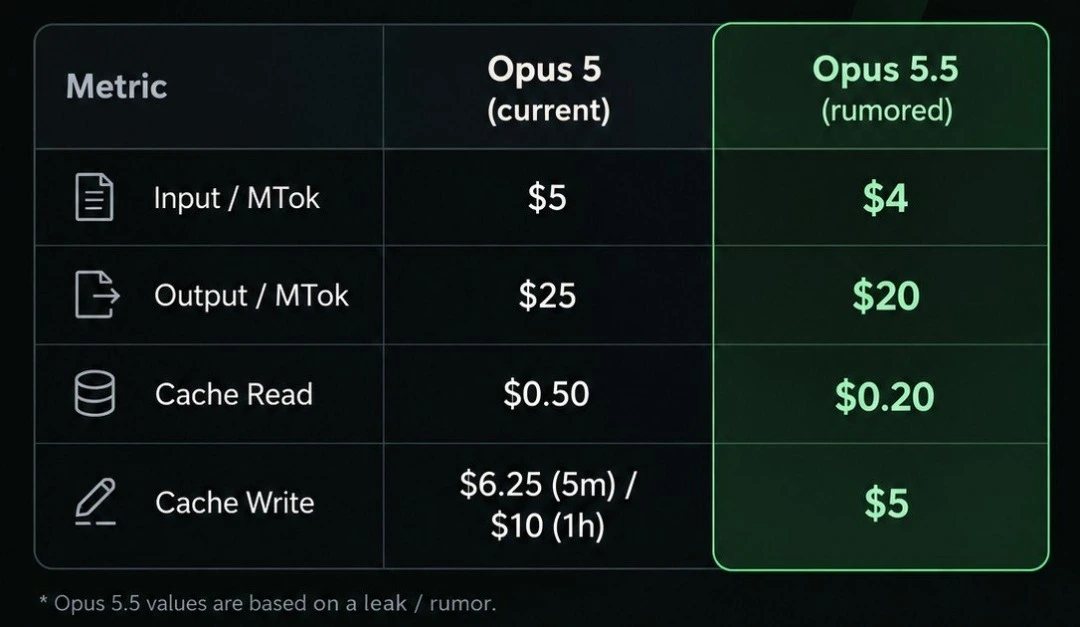
| ราคาอินพุตและเอาต์พุตต่อล้านโทเค็น | ระดับต่ำกว่า | ระดับสูงกว่า |
| การรองรับวิดีโอ | ไม่รองรับ | ไม่รองรับ |
คะแนนที่ต่างกันมีผลกับงานจริงอย่างไร
Claude Opus 5.5 ไม่ได้ชนะเพียงคะแนนรวม แต่ทิ้งช่วงในงานที่ต้องใช้ความสามารถเชิงเทคนิคด้วย โดยทำได้ 59.6% ใน Terminal-Bench 4.0 เทียบกับ 48.5% ของ Qwen4-Max ซึ่งเป็นเกณฑ์ที่สะท้อนการสั่งงานเชลล์ได้ตรงที่สุด ส่วน FrontierCode 2.0 ซึ่งทดสอบงานโค้ดระดับทั้งรีพอซิทอรี คะแนนอยู่ที่ 46.4% เทียบกับ 26.5% ช่องว่างนี้ทำให้ Claude เหมาะกับทีมที่ความผิดพลาดหรือการทำงานซ้ำมีต้นทุนสูง และต้องการผลลัพธ์กับงานซับซ้อนมากกว่าประหยัดค่าใช้จ่ายต่อรอบ อย่างไรก็ดี คะแนน benchmark ไม่ได้แปลว่าทุกคำตอบจะดีกว่าในทุกกรณี หากงานเป็นงานประจำที่กำหนดขอบเขตชัดและตรวจผลได้ การเลือกโมเดลคะแนนต่ำกว่าอาจเป็นการแลกเปลี่ยนที่สมเหตุผล แทนการจ่ายเพิ่มเพื่อความสามารถที่งานนั้นไม่ได้ใช้
ส่วนต่างต้นทุนมาจากราคาและปริมาณโทเค็น
ตัวเลขต้นทุนต่องานของ Qwen4-Max ลดลงจากรุ่นก่อนหน้าอย่างชัดเจน โดยการเปรียบเทียบต้นทุนบน Intelligence Index ระบุว่าค่าใช้จ่ายลดจากระดับเดิมมาอยู่ที่ระดับต่ำกว่า และคำนวณการลดลงได้ราว 67% เมื่อเทียบกับ Qwen3.8-Max สาเหตุไม่ได้มีแค่ราคาโทเค็นที่ลดลง แต่ Qwen4-Max ยังใช้โทเค็นน้อยลงด้วย ราคาต่อโทเค็นอินพุตและเอาต์พุตลดลง 25% จากรุ่นก่อน ขณะที่โทเค็นเอาต์พุตต่องานลดลง 39% และโทเค็นการให้เหตุผลลดลง 42% โทเค็นที่อ่านจากแคชลดลง 34% จึงช่วยลดค่าใช้จ่ายในงานเอเจนต์ที่ต้องอาศัยบริบทจำนวนมาก ส่วนราคาโมเดล AI ของ Claude อยู่ในระดับสูงกว่า และต้นทุนต่อภารกิจบนดัชนีสูงกว่า Qwen4-Max มาก แต่ข้อมูลนี้ไม่ควรใช้สรุปว่าทุกคำตอบมีต้นทุนเท่ากัน เพราะปริมาณอินพุต การแคช และความยาวคำตอบเปลี่ยนบิลได้

เลือกให้ตรงกับปริมาณงานและข้อจำกัด
Qwen4-Max เหมาะกับผู้ที่ต้องรันงานจำนวนมาก คุมงบต่อภารกิจ และใช้ระบบที่มีบริบทซ้ำหรือขั้นตอนเอเจนต์ยาว เพราะการลดโทเค็นช่วยประหยัดได้ควบคู่กับการปรับราคา จุดที่ต้องเผื่อใจคือคะแนนยังตาม Claude Opus 5.5 และเวลาต่องานของ Qwen4-Max ในดัชนีระบุว่าไม่สามารถประเมินได้ ขณะที่ Qwen3.8-Max รุ่นก่อนใช้เวลา 48.1 นาที เทียบกับค่ามัธยฐาน 13.3 นาที จึงไม่ควรตัดสินจากต้นทุนอย่างเดียวเมื่อความเร็วมีผลต่อเวิร์กโฟลว์ Claude Opus 5.5 เหมาะกับงานที่ต้องการคะแนนสูงกว่าและผลลัพธ์ด้านโค้ดหรือเชลล์ที่แข็งแรงกว่า แต่ต้องยอมรับต้นทุนต่อภารกิจที่สูงกว่า ก่อนย้ายงานจริง ควรทดสอบด้วยพรอมป์ตและข้อมูลของทีมเอง เพราะ benchmark บอกแนวโน้มความสามารถ ไม่ได้แทนการวัดต้นทุนและคุณภาพในงานประจำของคุณ
Buy if / Skip if
- Buy the Qwen4-Max if คุณมีงานจำนวนมาก ต้องควบคุมต้นทุนต่อภารกิจ และตรวจสอบคำตอบได้
- Skip the Qwen4-Max if งานหลักเป็นการเขียนโค้ดระดับรีพอซิทอรีหรือสั่งงานเชลล์ที่ต้องการคะแนนสูงกว่า
- Buy the Claude Opus 5.5 if คุณให้ความสำคัญกับคะแนน benchmark และงานเทคนิคที่ซับซ้อนมากกว่าค่าใช้จ่าย
- Skip the Claude Opus 5.5 if ปริมาณงานสูงและงบต่อคำตอบเป็นข้อจำกัดหลัก