
ตัดสินจากงาน ไม่ใช่ราคาต่อโทเค็น
ต้นทุนโมเดล AI คือค่าใช้จ่ายรวมที่เกิดจากโทเค็นขาเข้า โทเค็นขาออก และบริบทที่นำกลับมาใช้ซ้ำระหว่างทำภารกิจ ไม่ใช่เพียงราคาโทเค็น AI ที่ประกาศต่อล้านหน่วย จึงควรเทียบทั้งค่าใช้จ่ายต่อภารกิจและคุณภาพคำตอบก่อนเลือกใช้ Qwen4-Max หรือ Claude Opus
ถ้างานจำนวนมากมีขั้นตอนยาวและต้องควบคุมงบ Qwen4-Max เป็นตัวเลือกที่น่าสนใจกว่า เพราะทำภารกิจดัชนีได้ด้วยต้นทุนต่ำกว่ามาก แต่หากงานต้องพึ่งความสามารถด้านโค้ด การใช้เครื่องมือ หรือการให้เหตุผลยาก Claude Opus 5.5 มีคะแนนนำชัดเจน และอาจคุ้มกับส่วนต่างสำหรับงานที่ความผิดพลาดมีราคาแพง
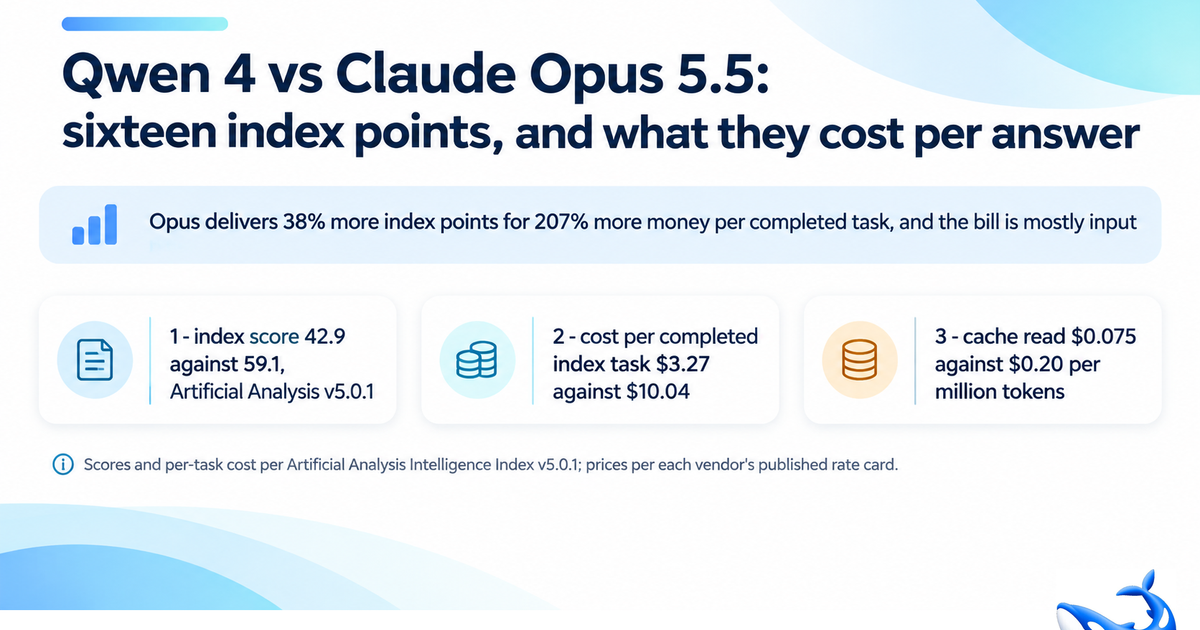
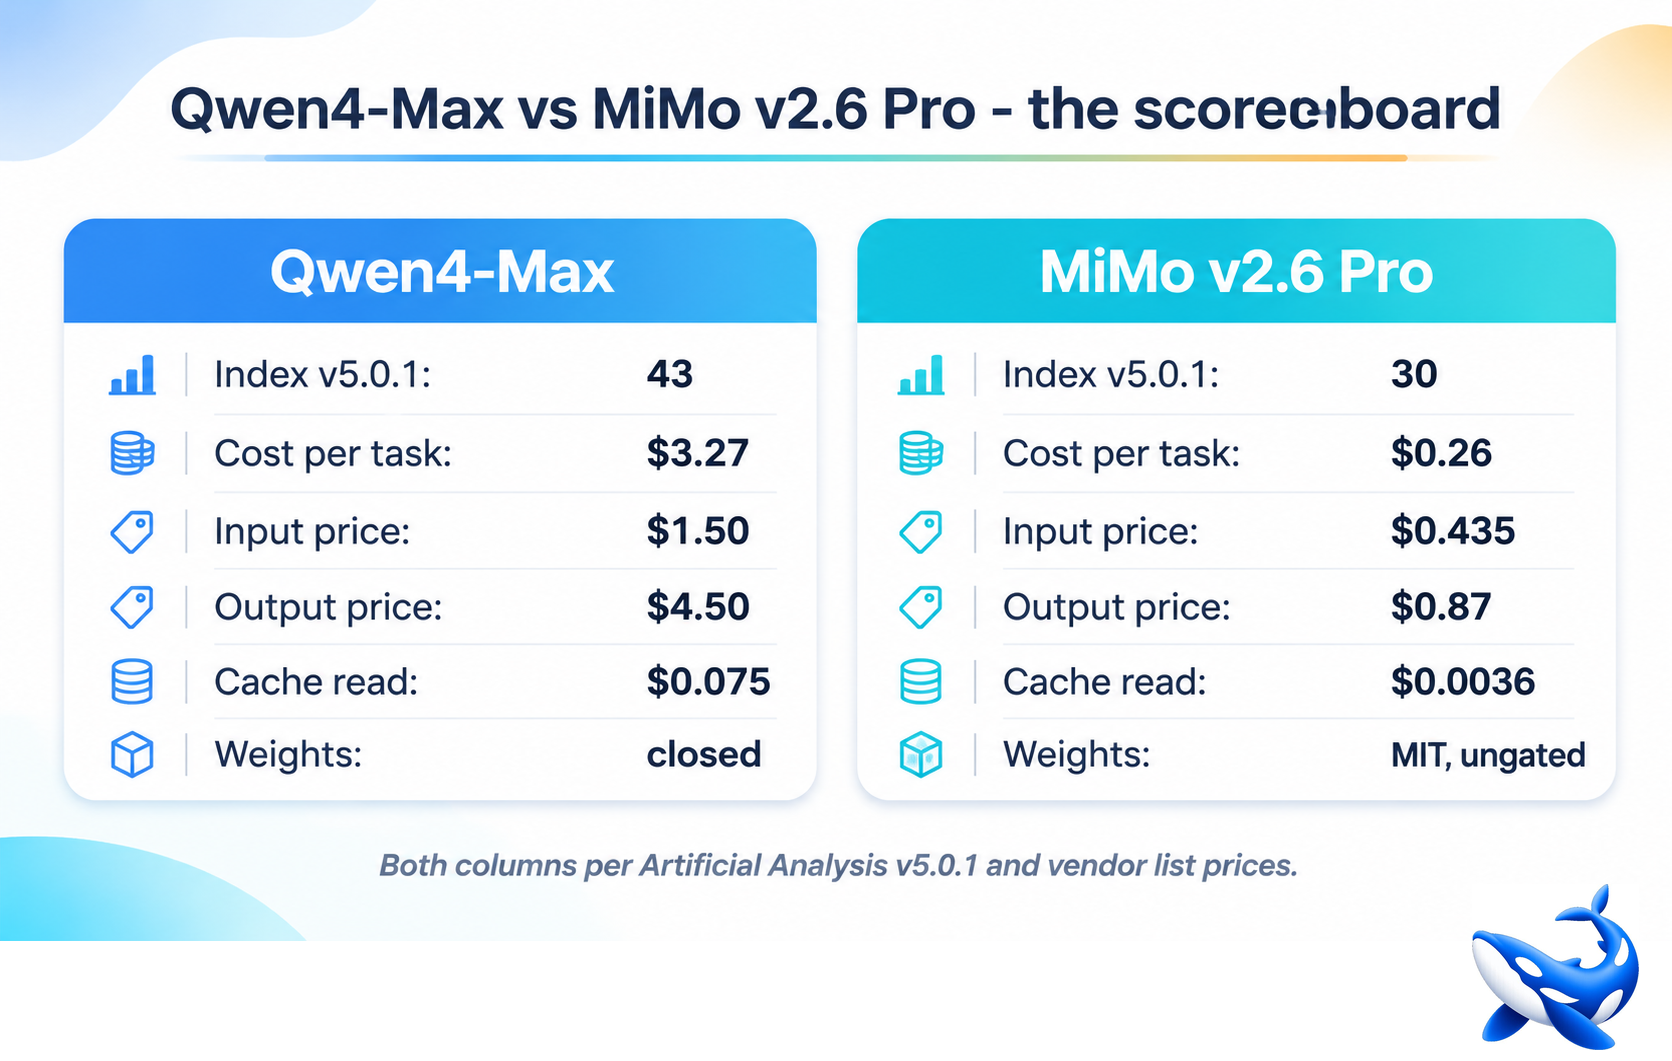
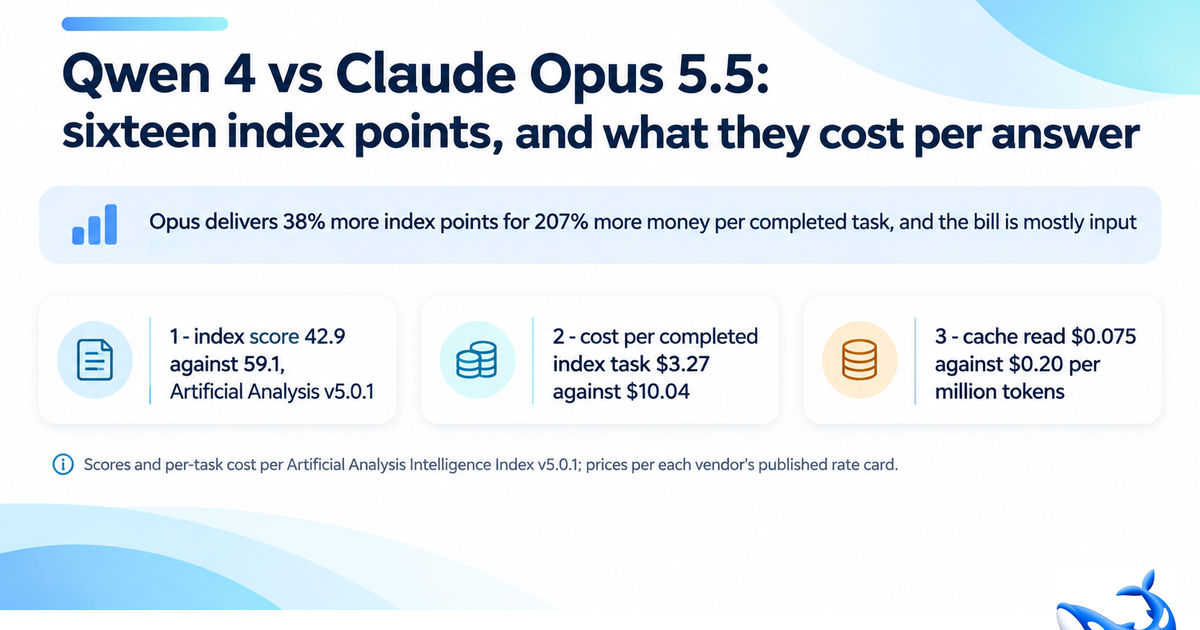
ต้นทุนภารกิจของ Qwen4-Max อยู่ที่ $3.27 เทียบกับ $10.02 ของรุ่นก่อน ลดลงราว 67% โดยส่วนหนึ่งมาจากการปรับราคา และอีกส่วนมาจากการใช้โทเค็นน้อยลง อย่างไรก็ตาม ตัวเลขจากการทดสอบเป็นการคำนวณตามภารกิจมาตรฐาน ไม่ใช่บิลจริงของทุกคน จำนวนรอบสนทนา การเพิ่มของบริบท และการแคช ล้วนเปลี่ยนค่าใช้จ่ายได้
คะแนนสูงกว่าไม่ได้แปลว่าคุ้มกว่าสำหรับทุกงาน
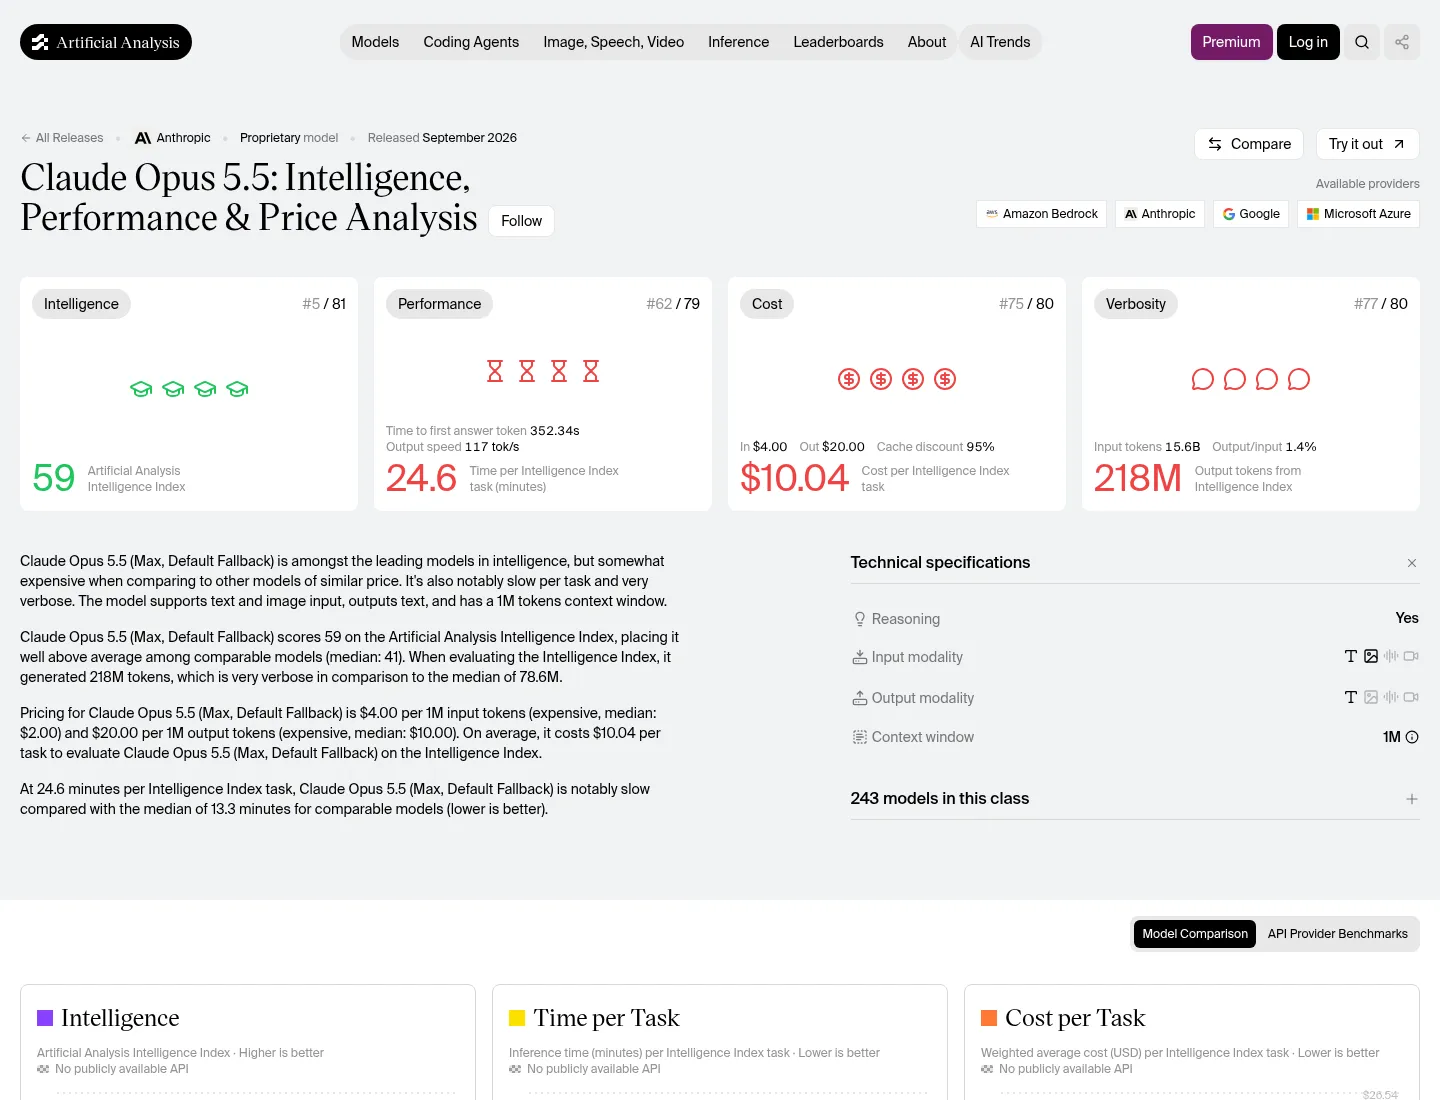
บนดัชนีเดียวกัน Qwen4-Max ได้ 42.9 คะแนน ส่วน Claude Opus 5.5 ได้ 59.1 คะแนน ต่างกัน 16.2 คะแนน ช่องว่างนี้มีความหมายมากขึ้นเมื่อดูงานเฉพาะด้าน: Claude Opus ทำได้ 59.6% ใน Terminal-Bench 4.0 เทียบกับ 48.5% ของ Qwen4-Max และนำใน FrontierCode 2.0 ที่ 46.4% ต่อ 26.5% รวมถึง HLE Diamond ที่ 67.9% ต่อ 44.9%
ถ้าใช้โมเดลช่วยจัดการโค้ดทั้งรีโพซิทอรี สั่งงานเชลล์ หรือแก้โจทย์วิทยาศาสตร์ซับซ้อน คะแนนที่นำของ Claude Opus มีโอกาสแปลเป็นงานที่เสร็จได้อย่างน่าเชื่อถือขึ้น และลดการลองซ้ำ แต่ถ้างานส่วนใหญ่เป็นการสรุปหรือจัดการงานทั่วไปที่ยอมรับความต่างด้านคุณภาพได้ การจ่ายเพิ่มเพื่อคะแนนดัชนีที่สูงกว่าอาจไม่คุ้ม
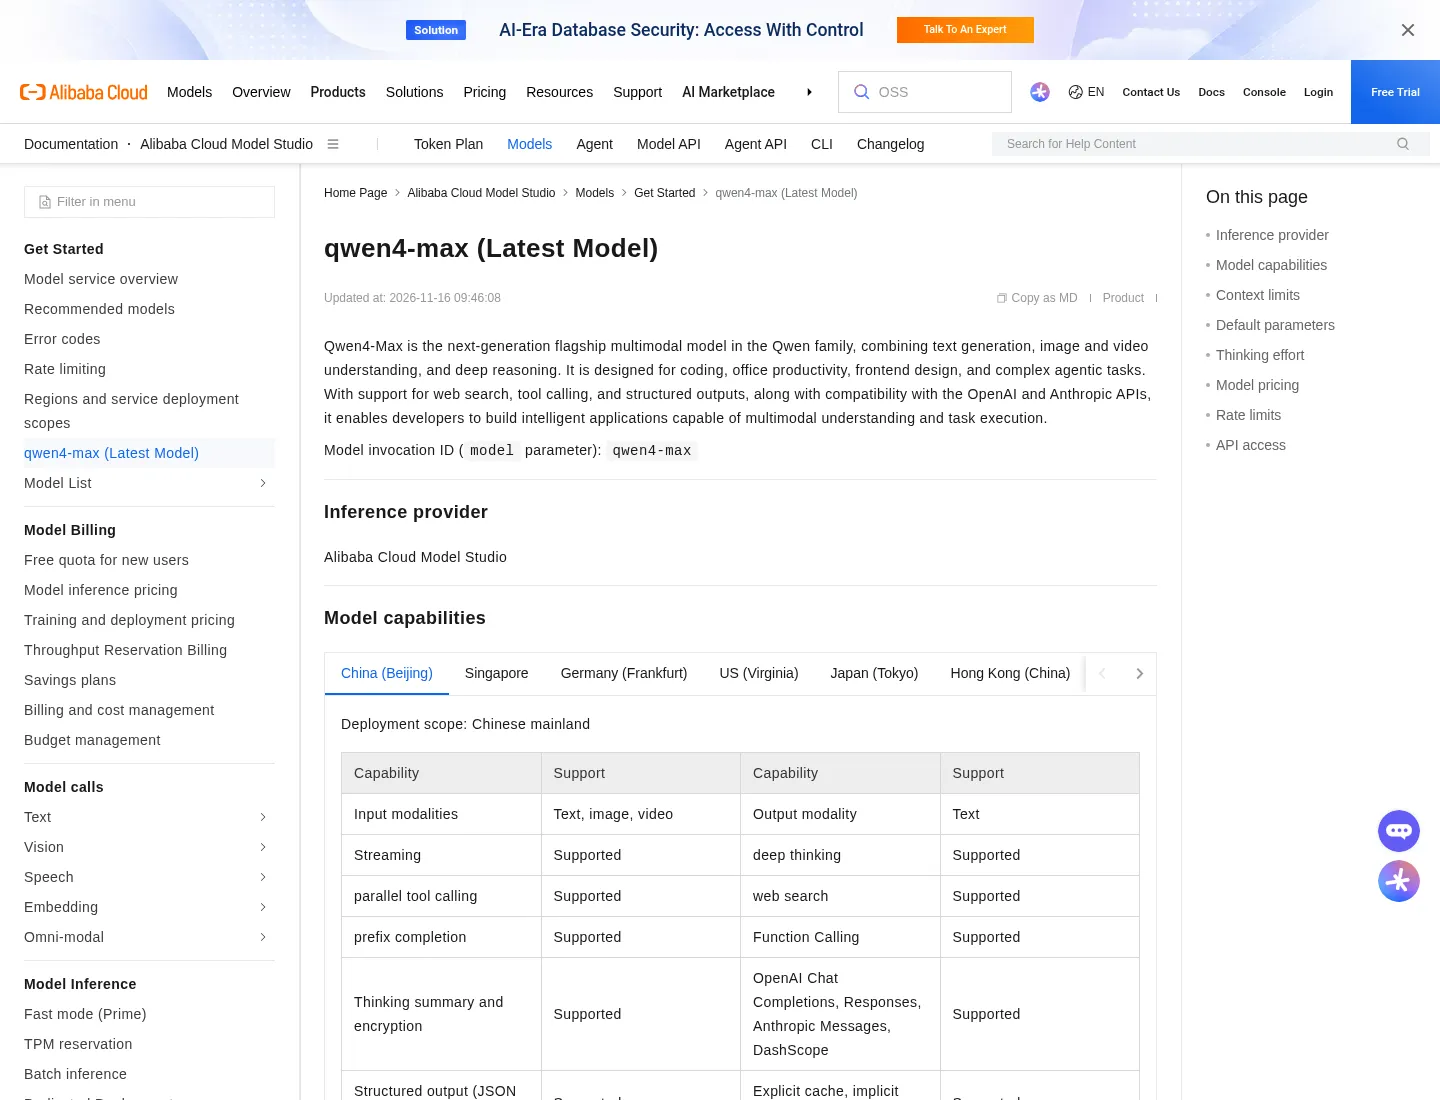
ข้อควรระวังคือคะแนนดัชนีไม่ใช่การรับประกันผลลัพธ์ในงานของคุณ ทั้งสองโมเดลเป็นระบบปิด ไม่เปิดน้ำหนักโมเดล และรองรับข้อความกับภาพ แต่ไม่รองรับวิดีโอตามข้อมูลความสามารถที่มี Claude Opus มีช่องทางให้บริการหลายแพลตฟอร์ม ขณะที่ Qwen4-Max ให้บริการผ่านคลาวด์ของผู้พัฒนาเป็นหลัก ดังนั้นข้อกำหนดด้านการเชื่อมต่อและระบบเดิมก็มีผลต่อการตัดสินใจ
ค่าอินพุตและแคชเป็นตัวแปรที่เปลี่ยนบิล
ราคาโทเค็น AI ขาเข้าและขาออกไม่ใช่ต้นทุนต่อคำตอบโดยตรง เพราะแต่ละภารกิจอาจอ่านประวัติยาว เขียนบริบทลงแคช และสร้างโทเค็นสำหรับการให้เหตุผลก่อนส่งคำตอบ ในการทดสอบดัชนีของ Qwen4-Max มีโทเค็นเอาต์พุตเฉลี่ยประมาณ 104,940 หน่วยต่อภารกิจ และมีโทเค็นอ่านจากแคชราว 14.9 ล้านหน่วย แสดงให้เห็นว่าภารกิจแบบเอเจนต์ระยะยาวมีค่าใช้จ่ายด้านบริบทซ้ำจำนวนมาก
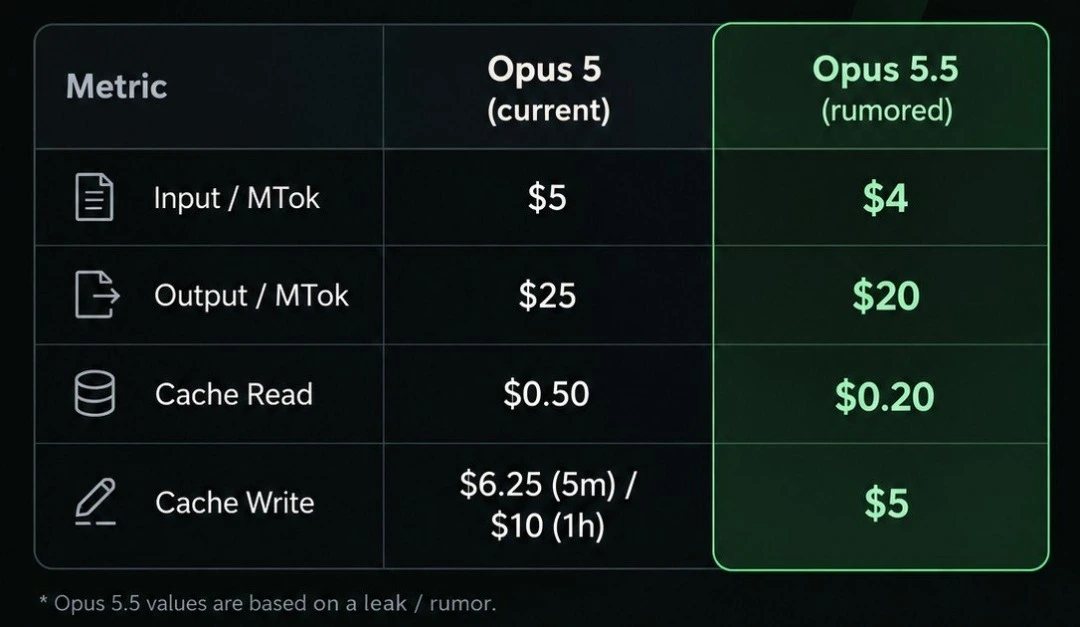
จุดนี้ทำให้การมองแต่ราคาต่อโทเค็นขาออกอาจพลาดต้นทุนส่วนใหญ่ได้ โดยเฉพาะเมื่อส่งประวัติเดิมซ้ำหลายรอบ ราคาการอ่านแคชของ Qwen4-Max ต่ำกว่าราคาขาเข้าปกติมาก จึงได้เปรียบกับงานที่ใช้บริบทเดิมต่อเนื่อง แต่ประโยชน์จริงขึ้นอยู่กับว่าแคชถูกใช้งานซ้ำได้มากแค่ไหน ส่วน Claude Opus อาจเหมาะกว่าเมื่อคุณต้องการลดจำนวนรอบแก้ไขหรือเพิ่มโอกาสที่งานยากจะสำเร็จตั้งแต่ครั้งแรก
สรุปคือ Qwen4-Max เหมาะกับงานปริมาณมากที่ควบคุมรูปแบบและบริบทได้ ส่วน Claude Opus เหมาะกับงานมูลค่าสูงซึ่งความสามารถปลายทางสำคัญกว่าค่าใช้จ่ายต่อครั้ง ตัวเลขต้นทุนและคะแนนเป็นผลจากการทดสอบกับรูปแบบภารกิจเฉพาะ ไม่ควรนำไปแทนการวัดกับพรอมป์ต์ ความยาวบริบท และอัตราแคชของระบบจริง
Buy if / Skip if
- Buy the Qwen4-Max if งานจำนวนมากมีบริบทยาว ใช้ซ้ำได้ และคุณต้องการลดต้นทุนต่อภารกิจ
- Skip the Qwen4-Max if งานหลักคือโค้ดระดับรีโพซิทอรี งานเชลล์ หรือโจทย์วิทยาศาสตร์ยากที่ต้องการคะแนนนำ
- Buy the Claude Opus if ความแม่นยำในงานเทคนิคและโอกาสสำเร็จมีค่ามากกว่าการลดค่าใช้จ่ายต่อครั้ง
- Skip the Claude Opus if งานส่วนใหญ่เป็นงานทั่วไปที่โมเดลราคาประหยัดทำได้เพียงพอ และคุณต้องประมวลผลจำนวนมาก