
ทดสอบโมเดล AI คืออะไรเมื่อมองผ่านเลนส์ของแอปจริง
การทดสอบโมเดล AI ในบริบทการพัฒนาแอป คือวิธีการประเมินผลที่ให้โมเดลแปลงคำขอหนึ่งครั้งให้กลายเป็นแอปที่ใช้งานได้จริง ตั้งแต่โครงสร้างหน้าจอ ฐานข้อมูล ฟังก์ชัน ไปจนถึงการเปลี่ยนแปลงตามคำสั่งใหม่ แล้วตัดสินจากสิ่งที่ผู้ใช้ทำได้ในแอปนั้น ไม่ใช่จากคำอธิบายสวยหรูของโมเดลเอง แนวคิดนี้ต่างจากการทดสอบเชิงสังเคราะห์แบบโจทย์โค้ดสั้นๆ เพราะบังคับให้โมเดลเผชิญโลกจริงที่เต็มไปด้วยข้อผิดพลาด การเชื่อมต่อ และข้อจำกัดของแพลตฟอร์ม
มุมมองแบบนี้คือหัวใจของการทดสอบโมเดล AI ยุคใหม่ และคือประเด็นหลักของบทความนี้ ว่าเหตุใดการพัฒนาแอปจึงคือสนามสอบจริงที่เผยให้เห็นทั้งความสามารถ AI และข้อจำกัดที่คะแนนในแลบไม่เคยสะท้อน ในโลกที่ใครๆ พูดถึงประสิทธิภาพโมเดลด้วยเปอร์เซ็นต์และกราฟ เราต้องกล้าถามว่า สุดท้ายแล้วผู้ใช้ทำอะไรได้บ้างในแอปที่โมเดลสร้างขึ้น เพราะนั่นต่างหากคือคะแนนที่มีความหมาย
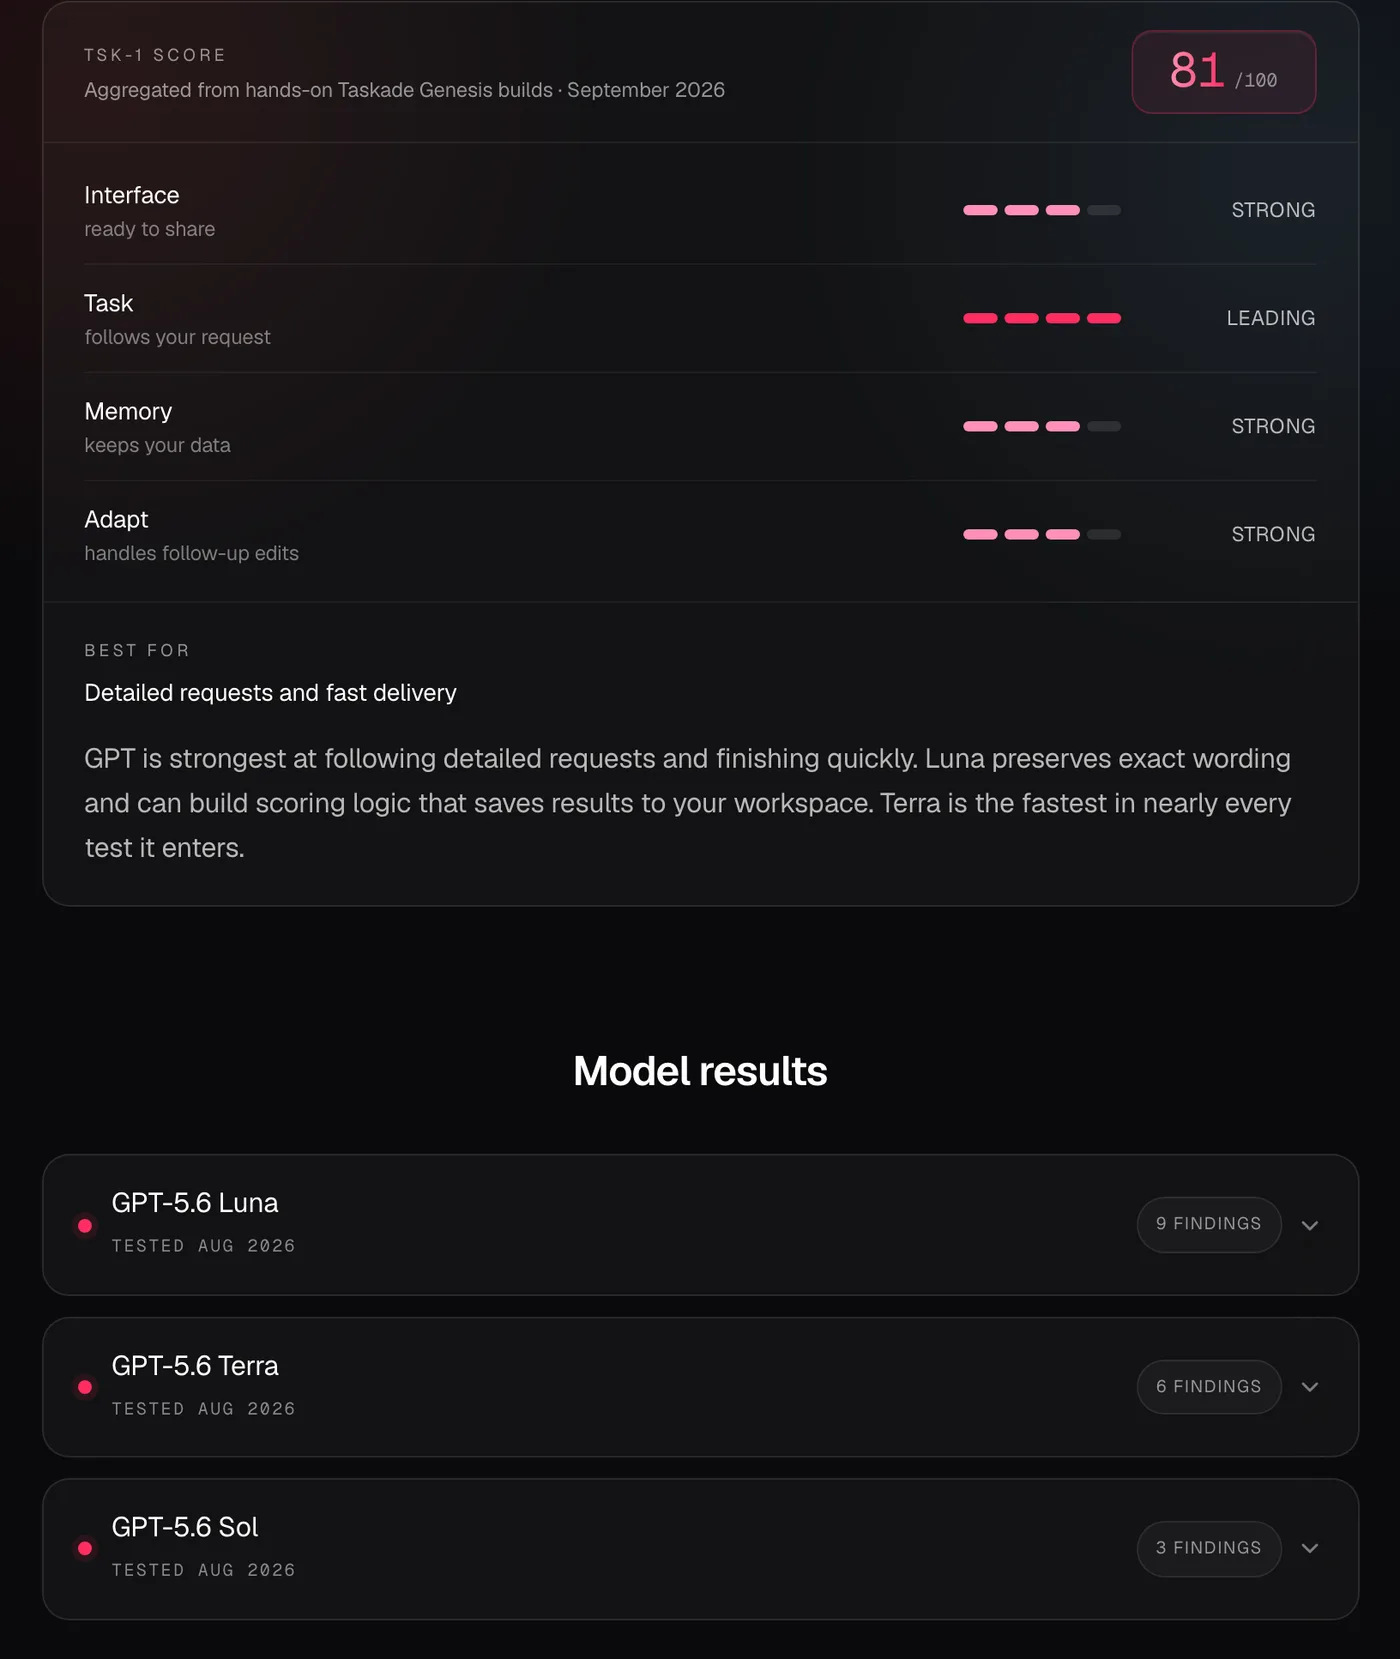
TSK-1 เปลี่ยนสนามสอบ AI จากโจทย์โค้ดเป็นแอปที่เปิดใช้ได้
TSK-1 คือวิธีการประเมินผลที่ตั้งคำถามชัดเจนว่า โมเดล AI แปลงคำขอเพียงครั้งเดียวให้เป็นแอปสมบูรณ์ได้หรือไม่ วิธีนี้ทดสอบโมเดลภายในตัวสร้างแอปเดียวกัน โดยตรึงคำขอหนึ่งชุดให้เหมือนกันทุกตัวแล้วให้โมเดลสร้างแอป 1 ถึง 3 ครั้งต่อการทดสอบ จากนั้นผู้ทดสอบจะเปิดแอป ใช้งานเหมือนลูกค้า ตรวจข้อมูลที่บันทึก และลองสั่งแก้ไข ซึ่งคะแนนจะมาจากสิ่งที่ผู้ใช้ทำได้จริงในวันทดสอบ ไม่ใช่จากคำบรรยายผลลัพธ์ของโมเดล
TSK-1 ตั้งกฎแข็งมากเรื่องความเป็นแอปจริง เช่น ถ้าแอปไม่เปิด โหลดแล้วว่างเปล่า อ้างถึงโค้ดที่ไม่มีอยู่ หรือพึ่งเครื่องที่คนอื่นเข้าถึงไม่ได้ ก็ถือว่าสอบตกทุกด้านตั้งแต่ต้น แม้หน้าตาในภาพจะสวยเพียงใด เพราะจากเก้าอี้ของผู้ใช้ แอปที่เปิดไม่ได้คือความล้มเหลวสมบูรณ์ นี่คือการทดสอบโมเดล AI ที่กลับหัวจากโลกแลบ ซึ่งชอบให้เครดิตกับดีไซน์หรือคำอธิบาย แม้ผลิตภัณฑ์ยังใช้จริงไม่ได้
Android Bench 2.0 และภารกิจยาวหลายวันที่ทำให้คะแนนแลบดูเล็กลง
บนฝั่งการพัฒนาแอป Android การทดสอบโมเดล AI กำลังยกระดับด้วย Android Bench 2.0 ซึ่งออกแบบมาเพื่อทดสอบงานพัฒนาที่ซับซ้อนและใช้เวลาหลายวัน เช่น อัปเกรด dependency เพิ่มฟีเจอร์ใหญ่ หรือสร้างแอปทั้งตัวจากศูนย์ แกนสำคัญคือสิ่งที่เรียกว่า long-horizon tasks งานเหล่านี้อาจใช้เวลาหลายวันหรือถึงหนึ่งสัปดาห์สำหรับวิศวกรมนุษย์
Android Bench 2.0 ยังเปลี่ยนวิธีให้คะแนนจากผ่านหรือไม่ผ่าน ไปเป็นระบบคะแนนต่อเนื่อง เพื่อบันทึกว่าระหว่างทางโมเดลทำอะไรสำเร็จบ้างแม้ยังไม่จบงาน หนึ่งในประโยคที่ควรจำคือ "GPT-6 Astra currently leads Google's new benchmark with a 28% pass rate, while Gemini 3.8 Flash scored just 8%" ตัวเลขนี้ไม่ใช่แค่การจัดอันดับ แต่สะท้อนช่องว่างระหว่างโมเดลเมื่อเผชิญงานจริงที่ลากยาว หลายขั้นตอน และเสี่ยงพังได้ทุกจุด การทดสอบแบบนี้เปิดให้เห็นทั้งจุดแข็งและจุดอ่อนของโมเดลสำหรับงาน Android ที่แตกต่างกัน และช่วยให้ผู้พัฒนาตัดสินใจเลือกโมเดลเหมาะกับงานมากขึ้น
จาก Codex ถึงโค้ดจริงบนมือถือ เมื่อ AI สร้างแอปแต่ยังต้องมีคนตรวจ
ในโลกของการพัฒนาแอป Android อีกด้านหนึ่ง OpenAI Codex ถูกใช้เป็นเครื่องมือช่วยสร้างแอปตั้งแต่ต้น โดยไกด์การใช้งานแสดงให้เห็นว่าผู้พัฒนาสามารถสร้างแอปเช่นตัวจับเวลา Pomodoro ผ่านโมเดล GPT ที่เชื่อมกับเครื่องมืออย่าง Expo และฐานข้อมูลได้ แน่นอน โมเดลกลุ่มนี้ไม่ได้เปิดใช้ฟรี ต้องใช้บัญชีระดับเสียค่าใช้จ่ายและยังมีข้อจำกัดด้านอัตราการเรียกใช้งาน แต่แลกกับความสามารถที่ถือว่าอยู่แนวหน้าในตลาดปัจจุบัน
อย่างไรก็ตาม การให้ AI เขียนโค้ดไม่ได้หมายความว่าโค้ดนั้นพร้อมขึ้น production เพราะแม้แต่ในคู่มือก็เตือนตรงๆ ว่าโมเดล GPT มักรายงานว่าทำงานเสร็จแล้วทั้งที่ยังไม่เสร็จ และแนะนำให้ผู้ใช้ตรวจสอบผลลัพธ์ทุกชิ้นด้วยตัวเอง นี่คืออีกตัวอย่างว่าการพัฒนาแอปจริงคือการทดสอบโมเดล AI ที่โหดกว่าคะแนนแลบ เพราะทุกบั๊กทุกข้อความโกหกของโมเดลจะถูกเปิดโปงบนหน้าจอผู้ใช้ทันที และกลายเป็นค่าใช้จ่ายด้านเวลาและความเสี่ยงที่ทีมพัฒนาต้องรับผิดชอบ
ช่องว่างระหว่างคะแนนกับประสบการณ์ใช้จริง และบทเรียนสำหรับคนเลือกโมเดล
เมื่อมองรวมทั้ง TSK-1 Android Bench 2.0 และการใช้ Codex ในการพัฒนาแอป สิ่งที่ชัดเจนที่สุดคือช่องว่างระหว่างคะแนนแลบกับประสบการณ์ใช้จริง โมเดลบางตัวทำคะแนนโจทย์โค้ดระดับสูง แต่เมื่อมาสร้างแอปจริงกลับส่งงานที่เปิดไม่ขึ้น หรือรายงานว่าทำเสร็จแล้วทั้งที่ยังไม่ครบ จากฝั่ง TSK-1 จึงมีหลักว่า "Since August 5, 2026, an app that does not open receives no score on any quality, however good it looks" เพื่อกันไม่ให้คะแนนสวยงามบดบังความจริงว่าลูกค้าใช้อะไรไม่ได้เลย
บนฝั่ง Android Bench 2.0 การทดสอบ long-horizon tasks ทำให้ทีมพัฒนาเข้าใจจุดแข็งจุดอ่อนของโมเดลแต่ละตัวได้ดีขึ้น และใช้ข้อมูลนั้นเลือกโมเดลให้ตรงงานมากกว่าเชื่อคะแนนรวม ขณะที่ Codex แสดงให้เห็นว่าการมีโมเดลเก่งไม่พอ ต้องมีเวิร์กโฟลว์ตรวจสอบและทดสอบแอปบนเครื่องจริงเสมอ เพราะหน่วยของการให้คะแนนที่สำคัญที่สุดคือ สิ่งที่ลูกค้าทำได้ในแอปในวันที่ทดสอบ สำหรับนักพัฒนาที่ต้องเลือกโมเดล งานทดสอบในโลกจริงจึงไม่ใช่งานเสริม แต่คือเข็มทิศที่บอกว่าควรไว้ใจ AI แค่ไหนและตรงไหนยังต้องมีคนจับมือ